Premiera / Narzędzie
Czy warto indeksować całe repo, zanim agent zacznie pisać?
Anthropic i Augment Code spierają się na łamach Ars Technica o jedno: czy przed pracą agenta warto z góry zaindeksować całe repozytorium, czy lepiej, by model wyszukiwał kod grepem od nowa przy każdym zadaniu. Cat Wu z Anthropic nie widzi mierzalnej poprawy z bogatego kontekstu i celowo trzyma harness szczupłym, a Vinay Perneti chwali się, że na Terminal-Bench semantyka dała ten sam wynik o 33% taniej. Przyznaje jednak, że przewaga liczy się dopiero na dużych, prywatnych repozytoriach, których publiczne benchmarki nie mierzą, więc spór idzie o koszt tokenów, nie o samą trafność.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 5 min ·
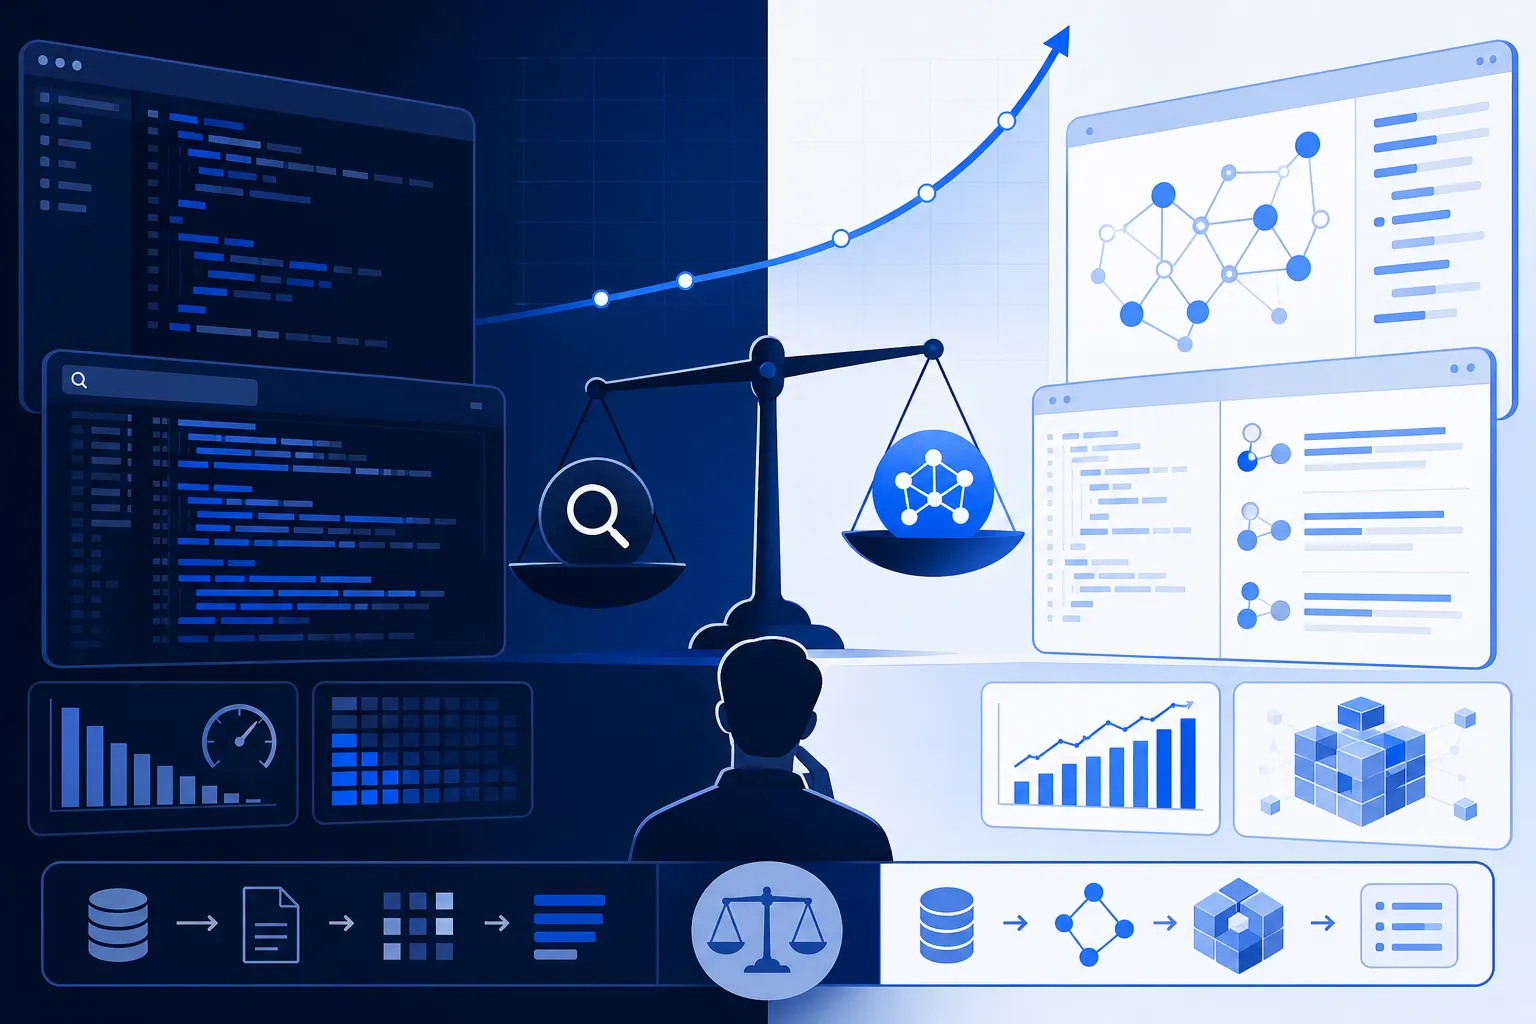
Dwie firmy, które robią oprogramowanie opakowujące modele językowe, spierają się o jedną rzecz: czy kod trzeba przygotować agentowi z góry, czy lepiej, żeby model odnajdywał go sam przy każdym zadaniu. Samuel Axon z Ars Technica przepytał obie strony. Cat Wu, szefowa produktu Claude Code w Anthropic, twierdzi, że ich testy nie pokazują żadnej mierzalnej poprawy, gdy z góry buduje się uporządkowany kontekst wokół repozytorium, więc jej zespół świadomie trzyma swój harness szczupłym. Vinay Perneti, wiceprezes ds. inżynierii w Augment Code, obstawił dokładnie odwrotnie. Powiem od razu, po której jestem stronie: w większości przypadków bliżej mi do Anthropic, a Augment wygrywa w jednym, wąskim, ale całkiem realnym scenariuszu.
Agent zapomina wszystko między zadaniami i naraz mieści w głowie tylko kawałek kodu, więc za każdym razem musi najpierw pójść i zebrać ten fragment, który akurat jest mu potrzebny. Tym, co model w ogóle zobaczy z kodu, jakie akcje może wykonać i jak z tym kodem rozmawia, steruje warstwa oprogramowania owinięta wokół modelu. To właśnie harness. Sposoby na samo zebranie kodu są dwa. Pierwszy, grepowy, którym idą Claude Code i Codex: model przeszukuje pliki tekstowo, jak programista wpisujący frazę w wyszukiwarkę, od nowa przy każdym zadaniu. Drugi, semantyczny, którym poszedł Augment: całe repozytorium jest z góry zaindeksowane, kod zamienia się na liczbowe wektory, a osobny model wyszukujący wyciąga w ułamku milisekundy te fragmenty, które pasują znaczeniowo, a nie dosłownie tekstem.
Przewaga pokazuje się dopiero na dużym, prywatnym repozytorium
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.