Model / Badania
Nowe modele, benchmarki i badania — co naprawdę potrafią i jak to zmierzono.
113 art.
Tydzień 40 · 28 września – 4 października 2026
 Model / Badania
Ta sama cena za token, mocniejszy model: co naprawdę tanieje w GPT-6.1 Sol
4 min
GPT-6.1 Sol, który OpenAI pokazało 30 września, kosztuje w API tyle co poprzednik, czyli 2 dolary za milion tokenów wejścia i 10 dolarów za milion wyjścia, a w teście DeepSWE dorównuje Astrze przy niższym ustawieniu rozumowania. Naprawdę tanieje tylko wejście z pamięci podręcznej, które spadło o połowę, do 0,10 dolara za milion, co przy agencie wielokrotnie wysyłającym kontekst repozytorium waży więcej niż benchmarki. Trzeba uważać na dwukrotnie droższe wejście powyżej 272 tysięcy tokenów i na to, że narzędzia działają tylko przez Responses API.
 Model / Badania
Gemini 4 Argon prowadzi w jednym teście kodu z trzech
4 min
Gemini 4 Argon od Google'a zdobył 77,9% w DeepSWE v1.1 i wyprzedził GPT-6 Astrę oraz Claude Opusa 5.5, ale w tym samym zestawieniu przegrywa z Astrą o ponad 10 punktów we FrontierSWE v2, a z Opusem o dziewięć w Terminal-Bench 4.0. Według Bloomberga część pracowników Google'a podejrzewa, że model szlifowano pod testy bardziej niż pod prawdziwą pracę. Na razie Argona dostały tylko zespoły bezpieczeństwa z programu Fairwind, a stawki 2 i 10 dolarów za milion tokenów podwoją się po promocji, więc przed przesiadką lepiej sprawdzić go na własnym repozytorium.
 Model / Badania
Sonnet 5.5 kosztuje połowę Opusa, dopóki nie każesz mu długo myśleć
5 min
Claude Sonnet 5.5 z 28 września kosztuje za token połowę tego, co Opus 5.5, a w CursorBench traci do niego nieco ponad dwa punkty. Ta przewaga trzyma się jednak tylko na niskim i średnim wysiłku, bo na wyższych poziomach sam Anthropic przyznaje, że Sonnet dogania Opusa przy podobnym koszcie zadania. Najlepiej wypada w prostszych pracach, na przykład w przeglądach kodu, gdzie CodeRabbit zszedł z 1,16 dolara do 47 centów za recenzję. Przy przesiadce trzeba też usunąć parametry temperature i top_p, bo inaczej API zwróci błąd 400.
 Model / Badania
73% trafnych fragmentów zamiast 46%: Jev jako filtr w agencie badawczym
4 min
GPT Researcher domyślnie przepuszcza pobrane fragmenty przez Jev od TypeSafe, model, który zamiast pisać tekst zwraca prawdopodobieństwa z góry ustalonych odpowiedzi, i trafnych okazało się 73% zachowanych fragmentów wobec 46% przy embeddingach, przy tym samym koszcie raportu. Całą różnicę robi próg, bo zmuszony do wypełnienia wszystkich dziesięciu miejsc Jev spadł do 50%. Model kosztuje 0,042 dolara za milion tokenów wejściowych, a reklamowe mnożniki 193,6 i 444,6 pochodzą z testów samej firmy, więc traktuję je jako obietnicę, nie pomiar.
 Model / Badania
Opus 5.5 tańszy o 40%? Cennik obiecuje połowę tej sumy
4 min
Anthropic wypuścił 22 września Opusa 5.5 z obietnicą, że kosztuje o 40% mniej niż Opus 5, choć sam cennik daje tylko 20%: milion tokenów wejściowych kosztuje 4 dolary zamiast 5. Resztę oszczędności wyznacza ustawienie wysiłku, którego domyślny poziom spadł z high na medium, więc rachunek zależy od konfiguracji, a nie od samego modelu. Przy migracji wymuszone wywołanie narzędzia kończy się błędem 400, a przy dobrze opisanych zadaniach programistycznych zacząłbym od dwa razy tańszego Sonneta 5.5.
 Model / Badania
Ile programowania zostaje w modelu po wycięciu połowy ekspertów?
4 min
Zespół DASLab z ISTA wyciął z modelu Qwen3.8-Flash-Next od Alibaby 256 z 512 ekspertów w każdej warstwie, a resztę wag zapisał z dokładnością 3,5 bita, dzięki czemu wersja do programowania mieści się na jednej karcie z 32 GB zamiast 354 GB. Metoda RCO zachowuje tylko to, co było w próbce kalibracyjnej, przez co pierwsza wersja straciła widzenie, a testy kodu tego nie zauważyły. Na LiveCodeBench zostaje 98,7% wyniku, ale na SWE-bench Verified spadek z 82,8% do 75,6% pokazuje, że w pracy agenta cięcie kosztuje więcej.
 Model / Badania
CLM-8B nie pisze ani słowa, tylko wybiera najlepszy ruch agenta
4 min
CLM-8B od związanego ze Stanfordem zespołu Contrastive-LM nie generuje tekstu, tylko przypisuje prawdopodobieństwo każdemu możliwemu ruchowi agenta, dzięki czemu jest szybszy od zamkniętego Jev, w grze T-Rex nawet dziewięciokrotnie. Jako sędzia łatek podniósł wynik na DeepSWE z 73,7 do 81,6%, podczas gdy Jev wybierał gorzej niż branie pierwszego rozwiązania z brzegu. Rekord liczono jednak na 38 i 30 zadaniach, więc szybkość broni się lepiej niż jakość, a nakładkę o wadze 75 MB na licencji Apache 2.0 można sprawdzić na własnych zadaniach.
Tydzień 39 · 21–27 września 2026
 Model / Badania
Grok 4.7 kosztuje tyle samo za token, ale na zadanie zużywa dwa razy więcej
4 min
xAI wypuściło 21 września Groka 4.7 w tej samej cenie co poprzednik, czyli 2 dolary za milion tokenów wejściowych i 6 za milion wyjściowych, ale na najwyższym poziomie rozumowania model zużywa średnio około 81 tysięcy tokenów na zadanie, a Grok 4.6 potrzebował 36 tysięcy. Nowa wersja rzadziej zmyśla i zajmuje czwarte miejsce w rankingu agentów programistycznych Artificial Analysis, choć w Terminal-Bench 4.0 wciąż traci prawie 20 punktów do Fable 5.1. Zanim ustawisz najwyższy poziom na stałe, zmierz na własnych zadaniach, ile tokenów trafi na fakturę.
 Model / Badania
GPT-6 Sol i Luna: OpenAI tnie ceny o połowę, ale liczyć trzeba koszt zadania
4 min
OpenAI wypuściło 22 września modele GPT-6 Sol i Luna o połowę tańsze od poprzedników, ale przy agencie programistycznym liczy się koszt całego zadania, a nie cena tokenu. Sol zdobywa 68,8% na DeepSWE, teście agentów naprawiających prawdziwe repozytoria, czyli niewiele mniej niż Claude Fable 5 przy rachunku niższym o około 80%. Niezależne pomiary studzą jednak entuzjazm, bo Artificial Analysis daje Solowi 48 punktów wobec 58 dla Claude Opus 5.5, a tańszy DeepSeek V4.1 Flash wyprzedza Lunę w programowaniu.
 Model / Badania
Claude Opus 5.5 jest o 40% tańszy, ale obniżka kryje się w pamięci podręcznej
3 min
Claude Opus 5.5 ma wyjść o 40% taniej niż Opus 5, ale cennik bazowy spadł tylko o 20%, a główna obniżka, aż o 60%, dotyczy odczytów z pamięci podręcznej, które przy agentach piszących kod stanowią większość rachunku. Resztę daje mniejsze zużycie tokenów, bo przy naprawie kodu liczącego 200 tysięcy linii Opus 5 spalił ich 2,5 raza więcej. Przed przesiadką sprawdziłbym, jak agent zniesie myślenie, którego nie da się już wyłączyć, oraz zachowane myślenie, które na nowych kontach API blokuje edycję historii rozmowy.
 Model / Badania
DiffusionGemma zamiast płatnego API do szybkich decyzji agenta
4 min
W zeszłym tygodniu do vLLM trafił tryb, w którym DiffusionGemma, czyli Gemma 4 od Google przerobiona na model dyfuzyjny, nie pisze odpowiedzi, tylko odczytuje ją z pustych pól szablonu i od razu podaje prawdopodobieństwo każdej opcji, zgodnie z API płatnego Jeva. Jedyny niezależny test, opublikowany przez LargitData 20 września, pokazał jednak, że djev-spark zaliczył 32,2% tur wobec 61,4% Jeva, a zwykła Gemma 4 31B osiągnęła 77%. Przy kierowaniu zgłoszeń radzę więc na razie tylko porównywać wyniki, a progi pewności kalibrować na własnych danych.
 Model / Badania
Otwarty model decyzyjny na Macu, prawie tak celny jak zamknięty Jev
4 min
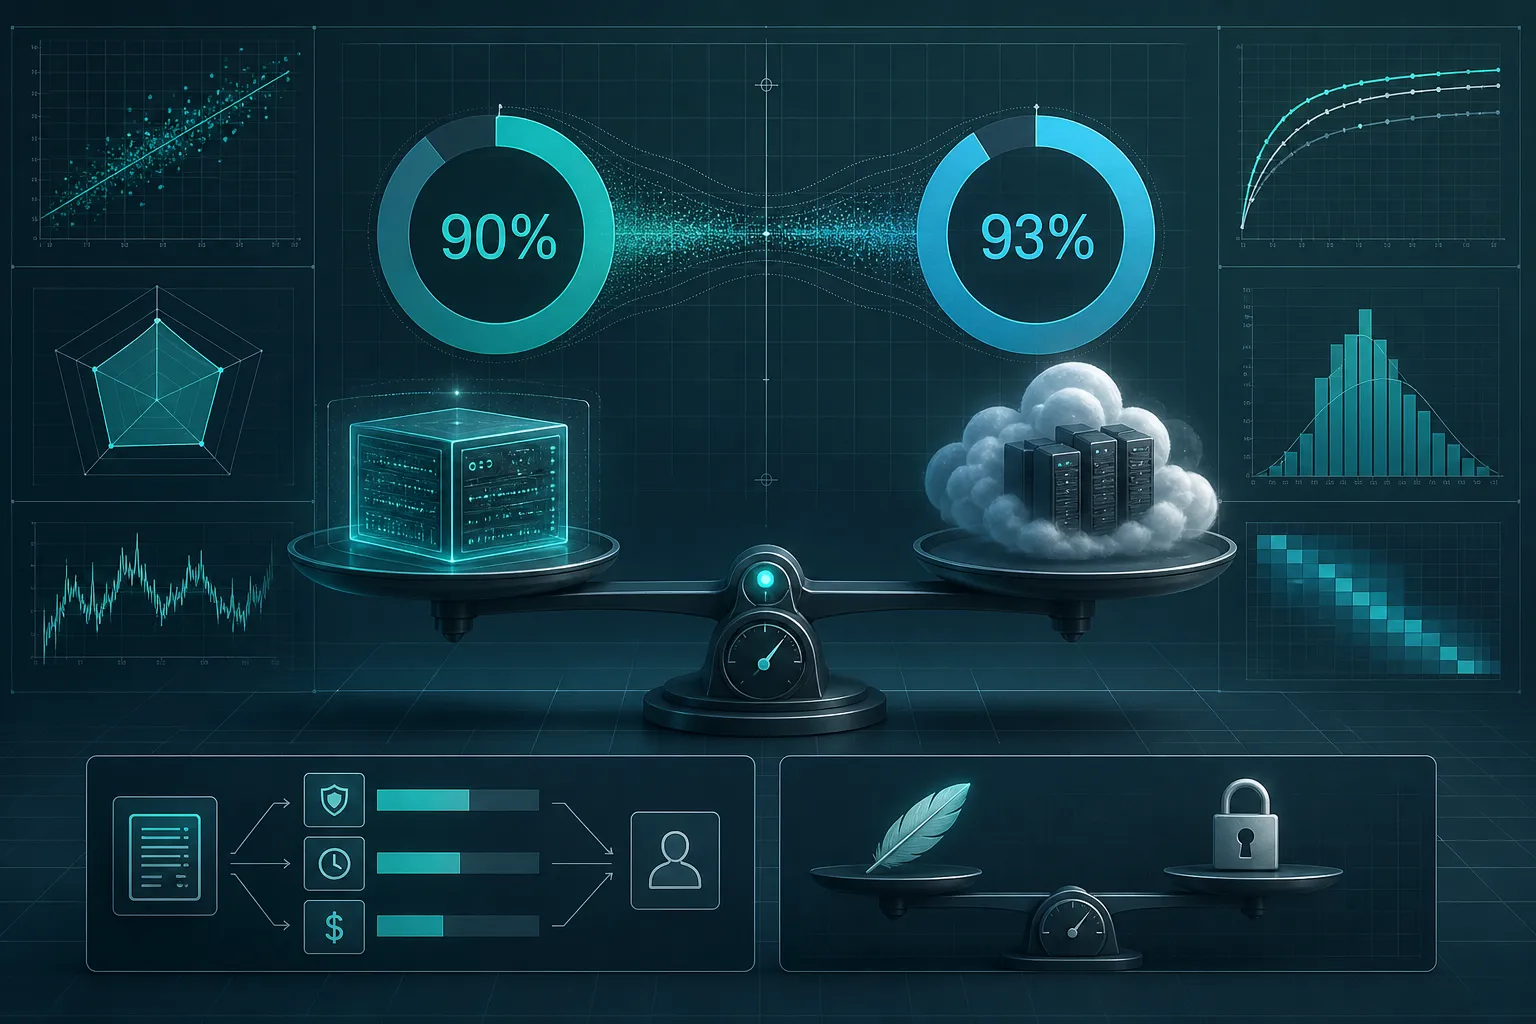
Bespoke Labs wydało Nimble, otwarty model zbudowany na Qwen3.5-9B, który wybiera odpowiedź z listy opcji lokalnie, na Macu albo karcie NVIDIA, więc nie trzeba parsować JSON-a zwróconego przez API. Na 324 przykładach testowych zgodził się z etykietami w 90,1% przypadków, a zamknięty Jev firmy TypeSafe w 93,2%, tyle że etykiety są syntetyczne, a test wąski. Do wstępnej klasyfikacji zgłoszeń to rozsądny wybór, ale przy decyzjach o pieniądzach lepiej najpierw sprawdzić go na własnych danych, bo bywa zbyt pewny siebie.
Tydzień 38 · 14–20 września 2026
 Model / Badania
Gemini 3.8 Live mówi dalej, kiedy myśli
4 min
Google wypuścił 15 września dwa modele głosowe, Gemini 3.8 Live do taniej obsługi dużego ruchu i wersję Extended Thinking, która rozumuje i mówi równocześnie, dzięki czemu rozmowa nie zamiera na czas wywołania narzędzia. Extended Thinking prowadzi w rankingu jakości rozmów Artificial Analysis z wynikiem 82,6 punktu, ale w bankowym wariancie testu agentowego τ-Voice domyka tylko 35,1% spraw, czyli dwie na trzy nie dochodzą do finału. Cennika Google nie podał, a przy rozmowie na żywo płaci się za godziny dźwięku, więc akurat ta liczba decyduje o sensie agenta na infolinii.
 Model / Badania
DeepSeek wygasza własnego flagowca, bo tańszy model wypada lepiej
3 min
DeepSeek od zeszłego poniedziałku przekierowuje ruch z flagowego V4-Pro na tańszy V4.1-Flash i rozlicza go po niższych stawkach, więc w konfiguracji masz jeden model, a odpowiada inny. Firma tłumaczy to wynikami: 90,6 punktu na Terminal-Bench 2.1, prawie dwa oczka przed GPT-5.6 Sol i trzy przed własnym V4-Pro, przy pamięci ściętej z 3514 do 890 bajtów na token. Przy agencie, który pracuje godzinami nad jednym zadaniem, to właśnie pamięć bywa największą pozycją rachunku, więc czterokrotna oszczędność waży więcej niż miejsce w rankingu. Tyle że tabelkę mierzył sprzedawca, a wyboru już nie ma.
 Model / Badania
Model mieści się na laptopie, ale nie uruchomisz go na zwykłym llama.cpp
3 min
PrismML wypuścił 17 września Bonsai 2 27B, czyli model Alibaby ściśnięty do 5,9 GB z deklarowaną stratą 1,8% na benchmarkach, bo każda waga przyjmuje w nim już tylko trzy wartości zamiast szesnastobitowej liczby. Brakujący punkt procentowy jest tu najmniej ciekawy: prawdziwą przeszkodą jest to, że główna gałąź llama.cpp tego formatu nie obsługuje, więc do czasu przyjęcia poprawki trzeba korzystać z forka PrismML. Domyślna instalacja waży zresztą 7,8 GB razem z modułem do obrazów, a długa rozmowa w oknie 256 tysięcy tokenów potrafi zająć w pamięci więcej miejsca niż sam model.
 Model / Badania
Model przepisuje 90% migracji i dostaje za to zero punktów
4 min
Google przebudował Android Bench od podstaw: zamiast drobnych poprawek mierzy zadania, nad którymi inżynier siedzi kilka dni, a wynik podaje jako ciągły wskaźnik ukończenia. Czołówka, która na poprzedniej wersji meldowała ponad 90%, zjechała do 28% dla prowadzącego GPT-6 Astra, czyli tą samą drogą co wcześniej przy SWE-Bench Pro. Przepisywanie z Javy na Kotlina modele robią gładko, ale przeniesienia aplikacji wieloplatformowej na natywnego Androida nie domknął żaden. Oceniany jest przy tym model razem z harnessem, więc różnica między wierszami tabeli nie musi być różnicą między modelami.
 Model / Badania
Jedenaście plików GGUF i ani jednego pomiaru
4 min
Empero wrzucił na Hugging Face destylat Qwen3.8-35B-A3B w wersjach od 12,6 GB po pełne 71 GB, a zalecany czterobitowy plik waży 21,7 GB i mieści się na karcie z 24 GB pamięci albo w 32 GB RAM-u. Przy każdym tokenie pracuje tylko około 3 miliardów z 35 miliardów wag, dzięki czemu odpowiedzi lecą szybciej, niż sugeruje rozmiar, ale cały plik i tak musi wejść do pamięci, bo router sięga w każdej chwili po dowolny z 256 fragmentów. Karta nie podaje ani jednego pomiaru, więc dopóki nie przepuści tego ktoś przez niezależny benchmark, destylacja pozostaje zapowiedzią wydawcy, a nie faktem.
Tydzień 37 · 7–13 września 2026
 Model / Badania
Agent Cognition zabiera się do kodu po 18 krokach zamiast 48
4 min
SWE-2, nowy model Cognition napędzający Devina, zabiera się do edycji kodu po 18 krokach zamiast 48, a całą drogę przez zadanie skrócił ze 127 kroków do 53, bo koszt wpisano wprost do funkcji nagrody podczas uczenia. Na własnym benchmarku firmy wypada niemal jak Fable 5.1, 50,0% wobec 50,9%, i to o 64% taniej, ale na trudniejszym Terminal-Bench 4 zostaje daleko w tyle z wynikiem 27,3%. Cennika ani osobnego API nie ma, model dostajesz wyłącznie razem z Devinem, więc przewagi kosztowej nikt z zewnątrz na razie nie sprawdzi u siebie.
 Model / Badania
Ta sama para modeli, trzy różne rachunki za jedno zadanie
5 min
Artificial Analysis wylicza, że średnie zadanie agentowe kosztuje 3,26 dolara na GPT-6 Astra i 7,63 na Claude Fable 5.1 przy identycznej skuteczności, ale OpenAI i Cognition zmierzyły tę samą różnicę na 63% i 42%, a Zvi Mowshowitz wskazuje, że Fable puszczono w trybie Max, co te 57% zawyża. Cognition odpowiada układem Fusion w Devinie, w którym droższy model prowadzi, a tańszy grzebie w kodzie: na DeepSWE 1.1 ścina to koszt zadania o 46% bez straty jakości, tyle że z Astrą na Terminal-Bench 4.0 wynik leci w dół o ponad pięć punktów. Cenę za zadanie widać dopiero na własnym repozytorium.
 Model / Badania
Ten sam model, dwie warstwy, 36 punktów różnicy
5 min
ARC Prize przepuścił GPT-6 Astrę przez ten sam zestaw zadań dwa razy, przy identycznym poziomie rozumowania zmieniając tylko warstwę obsługującą model między ruchami, i dostał raz 62,71%, a raz 98,55%. Ta druga liczba poszła w świat jako dowód na AGI, choć opisuje całą konfigurację, a nie model, który kupujesz. Milion tokenów wyjściowych kosztuje 50 dolarów, dwa i pół raza więcej niż u Sola, a mimo to przebieg na średnim poziomie rozumowania zamknął implementację w 80 żądaniach zamiast 238 i wyszedł taniej. Zanim policzysz, ile kosztuje cię Astra, sprawdź, co masz wokół niej.
 Model / Badania
Mercury 2.5 skraca porządkowanie kontekstu ze 150 sekund do 27
4 min
Augment Code streszczał długie sesje przez około 150 sekund, a po przesiadce na Mercury 2.5 od Inception ten sam krok zajmuje 27 sekund i kosztuje o 90% mniej, bo model dyfuzyjny wypełnia całe bloki tokenów naraz, zamiast dopisywać je po kolei. Sęk w tym, że wszystkie liczby, łącznie z reklamowanymi 1107 tokenami na sekundę, pochodzą od producenta, a niezależny pomiar poprzednika dał 684 tokeny zamiast obiecywanego tysiąca. Cena 0,04 dolara za milion tokenów wejściowych to rabat na start, docelowo cennik mówi 0,20 za wejście i 0,75 za wyjście.
 Model / Badania
Anthropic radzi w pierwszym akapicie, żeby zostać przy tańszym modelu
5 min
Anthropic wypuścił 1 września Claude Fable 5.1 i już w pierwszym akapicie notatek o wydaniu poradził, żeby do większości zadań zostać przy tańszym Opusie 5. Cennik wejścia zostaje na 10 dolarach za milion tokenów, a prawdziwy koszt przesiadki leży w kodzie, bo model podpisuje bloki rozumowania stanem rozmowy i wycięcie starej tury czy odświeżenie daty w prompcie kończy się trwałym błędem 400. Nowe konta mają tę kontrolę domyślnie, starsze jeszcze nie, więc twój klucz może działać bez zarzutu, a pierwszy użytkownik z nowego konta zobaczy błąd, którego nigdy nie widziałeś.
 Model / Badania
Kilkanaście razy taniej, jeśli oddasz Mecie swoje prompty
4 min
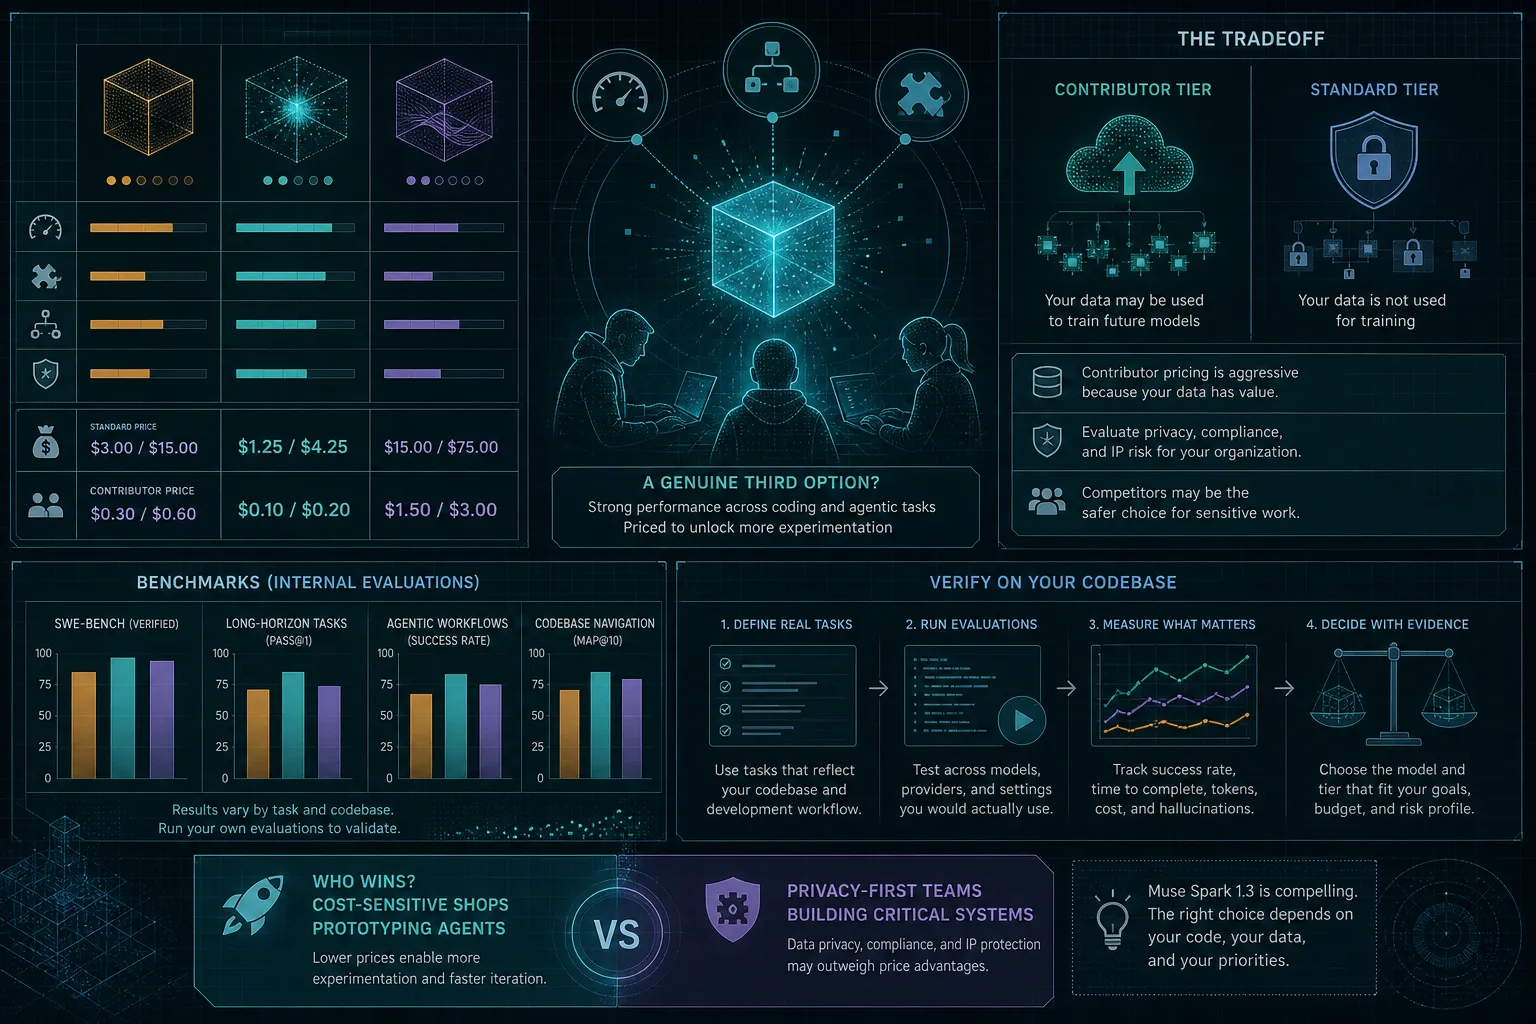
Drugiego września Meta wystawiła Muse Spark 1.3 pod dwoma identyfikatorami, które różni tylko ciąg znaków w polu model: standard kosztuje 1,25 i 4,25 dolara za milion tokenów, a wariant contributor schodzi do 0,10 i 0,20, bo zgadzasz się, żeby Meta trenowała kolejne modele na twoich promptach i odpowiedziach. Tego wyboru nie widać ani w interfejsie aplikacji, ani w narzędziach, które mają wyłapywać wycieki danych, więc zostaje grep po ciągu -contributor i pytanie do dostawcy. Przy prywatnym projekcie to uczciwa wymiana, przy kodzie klienta nikt po jego stronie jej nie wybrał.
 Model / Badania
Qwen3.8 27B mieści się w 17 GB i nie traci na jakości
5 min
Quesma wydała około 3000 dolarów na wynajem kart, żeby zmierzyć, ile pamięci naprawdę potrzebuje Qwen3.8 27B: pełny model w BF16 waży 55 GB, a skompresowany do czterech bitów schodzi do 17 GB i powtarza wynik oryginału na Terminal-Bench 2.1, więc mieści się na RTX 4090 razem z 64 tysiącami tokenów kontekstu. Klif zaczyna się dopiero przy jednym bicie, ale większym problemem jest domyślne ustawienie reasoning_effort na xhigh, przez które Simon Willison czekał 21 minut na prosty rysunek w SVG, a lekarstwem jest jedna linijka z poziomem low.