Poradnik / Praktyka
Poradniki, warsztaty i sprawdzone praktyki pracy z AI.
44 art.
Tydzień 40 · 28 września – 4 października 2026
Tydzień 39 · 21–27 września 2026
Tydzień 38 · 14–20 września 2026
 Poradnik / Praktyka
Instrukcje pisane pod słabszy model dziś kosztują cię kontekst
4 min
OpenAI przekonuje deweloperów, że instrukcje pisane pod słabszy model przy GPT-6 Astrze zaczynają działać przeciwko tobie, bo zjadają kontekst i ciągną agenta tam, gdzie już go nie chcesz. Stąd rada, żeby skrócić opisy skilli, zamienić rozdęty AGENTS.md w drogowskaz do reszty i wyciąć przepisy krok po kroku, z którymi Astra radzi sobie sama. Mocne "pytaj, zanim cokolwiek zrobisz" zostawiam tam, gdzie jest, bo nadgorliwy agent kosztuje 30 sekund, a przekonany o własnej racji cały wieczór odkręcania. A skille w repozytorium sterują też agentami współpracowników, którzy pracują na innym modelu.
 Poradnik / Praktyka
Opus 5 bierze "bądź zachowawczy" dosłownie i przemilcza część błędów
4 min
Anthropic ostrzega w przewodniku po promptowaniu Opus 5, że dopisane kiedyś do promptu "bądź zachowawczy" nowy model bierze dosłownie i razem z hałasem przemilcza część prawdziwych błędów. Parametr effort tnie czas myślenia, ale nie długość odpowiedzi, więc o zwięzłość trzeba poprosić wprost. Przy wyłączonym myśleniu model potrafi napisać coś, co wygląda na wywołanie narzędzia, choć nic się nie uruchomiło, a taki zapis zostaje w historii rozmowy i kolejne tury czytają go jak fakt. Bezpieczniej zostawić myślenie włączone i ciąć koszt niższym ustawieniem effort.
 Poradnik / Praktyka
Recenzent nie pomylił się ani razu i to był problem
5 min
Automatyczny recenzent Codex w projekcie AgentCoop nie pomylił się ani razu, a mimo to sześć rund recenzji rozdęło funkcję z 28 do 42 linii, bo zasada „każda uwaga załatwiona przed mergem” po cichu zmieniła się w „każdą poprawiamy”, a tak kończyło się 91% uwag. Zespół odpowiedział procedurą liczącą koszt w godzinach zamiast etykietek P1 i P2 oraz skryptem chain-check, który zatrzymuje pracę, gdy dwie rundy z rzędu trafiają w kod napisany pod wcześniejszą uwagę tego samego recenzenta. Arytmetyki nie kupuję, ale ktoś wreszcie spisał drugą stronę rachunku, czyli to, co naprawdę traci użytkownik.
 Poradnik / Praktyka
Trzy wymagania, dwie asercje i poprawka, która wygląda poprawnie
4 min
Poprawka jednym warunkiem zapala dwie asercje na zielono, ale kasuje trzeci punkt kontraktu, bo Python traktuje None i pustą listę tak samo. Człowiek taki wynik najwyżej przeoczy, natomiast agent naprawczy zbiega do testu zamiast do wymagania, więc odwrotnie napisana asercja potrafi go skłonić do zepsucia działającego kodu. W preprincie ExecCritic ten sam agent rozwiązywał 61,2% zadań z SWE-bench Verified, a ze słabszymi wygenerowanymi testami osuwał się do 57,3%, przy nierównych budżetach obliczeniowych. Stąd jedno pytanie do każdego testu: którą błędną implementację odrzuci.
Tydzień 37 · 7–13 września 2026
 Poradnik / Praktyka
Anthropic radzi opisać zadanie raz i zostawić Opusa 5 w spokoju
3 min
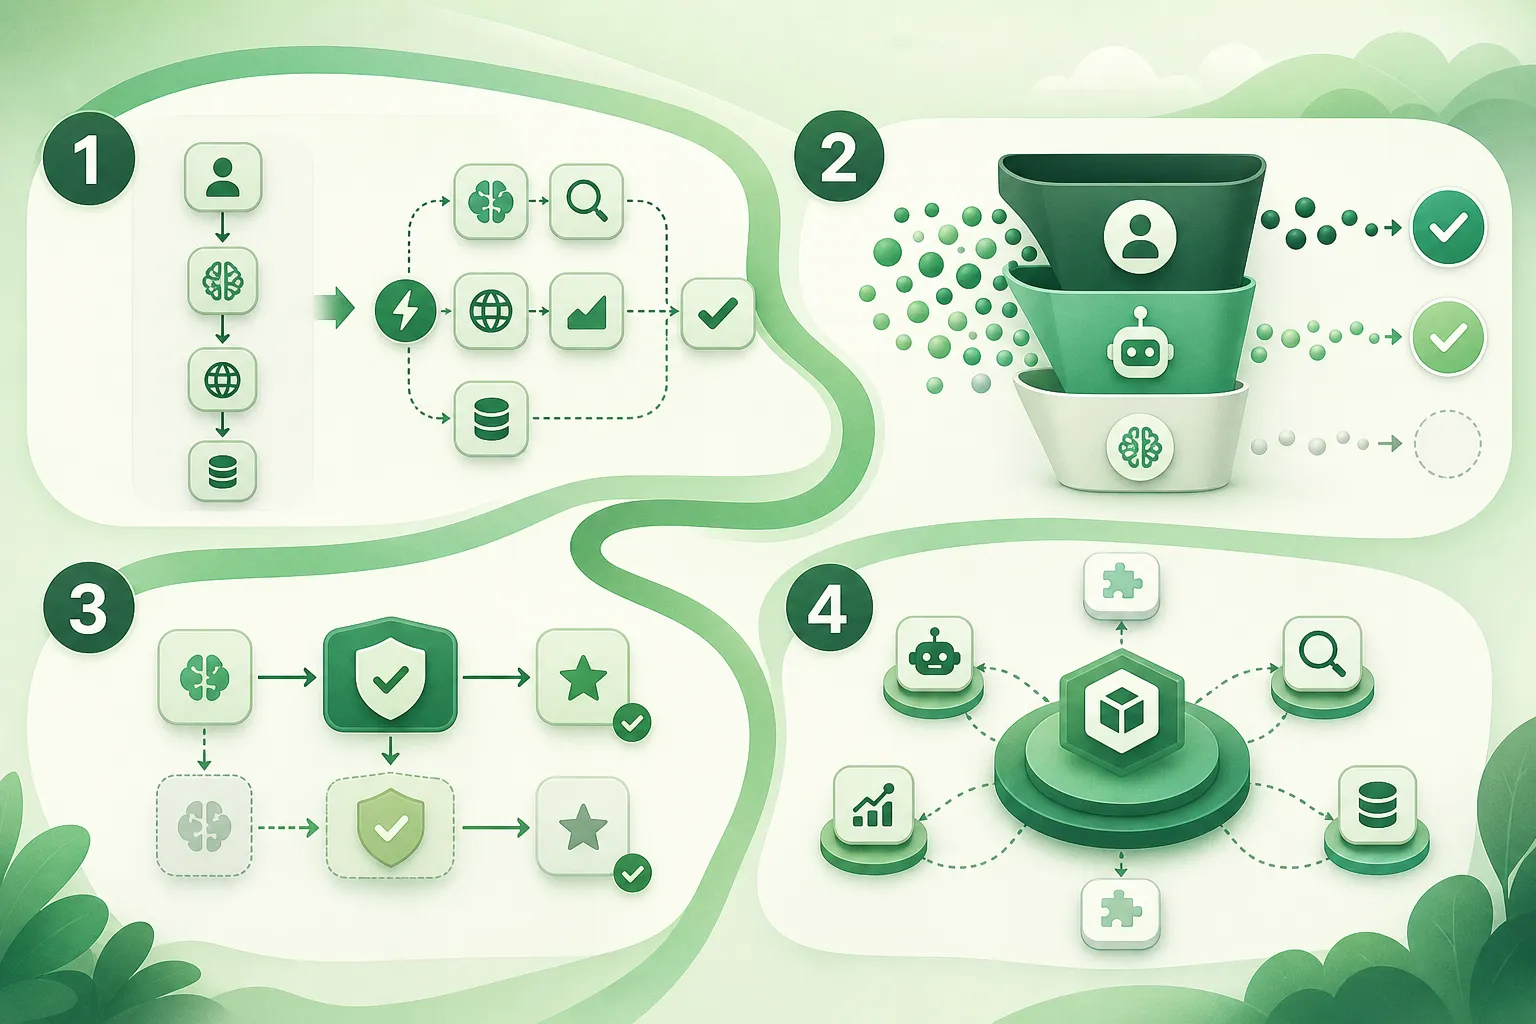
Anthropic radzi dawać Opusowi 5 całą specyfikację naraz i nie przerywać mu w trakcie, bo milionowe okno kontekstowe nie zmusza już do cięcia zadania na tury. Druga połowa tych porad jest o pieniądzach: przegląd kodu ma trzymać skuteczność także na niższych poziomach parametru effort, a model domyślnie startuje z high, więc konfiguracja nieruszana od czasów Opusa 4.8 kupuje dziś myślenie, które niczego już w wyniku nie zmienia. To jedyna rada z własnym sposobem sprawdzenia, bo reszta, łącznie ze zdaniem o przeglądach, to deklaracja producenta o własnym modelu.
 Poradnik / Praktyka
Jury Google'a zajrzało w kod i znalazło jeden model z imionami agentów
4 min
Google przejrzał kod tysięcy zgłoszeń na AI Agents Challenge i opisał cztery wzorce, które powtarzały się u najlepszych, choć żaden nie dotyczy agentów jako takich. Zamiast łańcucha wywołań jeden zespół postawił cztery kolejki asyncio.Queue, inny wstawił przed model lokalny regex, który odsiał ponad 40% wiadomości, zanim cokolwiek trafiło na rachunek za inferencję, a kolejny wystawił własnego agenta jako serwer MCP. Liczby są pomiarami samych zespołów, a konkurs oceniało jury firmy, która go zorganizowała, więc to obserwacja, nie dowód.
Tydzień 36 · 31 sierpnia – 6 września 2026
Tydzień 34 · 17–23 sierpnia 2026
 Poradnik / Praktyka
Wzorzec Karpathy'ego po czterech miesiącach: lista miejsc, w których się sypie
5 min
Po czterech miesiącach ze wzorcem wiki Andreja Karpathy'ego komentujący pod gistem zgłaszają te same pęknięcia: notatki zgadzają się z notatkami, a sprzeczność leży w linijce kodu, której wiki nigdy nie przeczytała. AbleVarghese wskazał, że w okolicach tysiąca plików model zaczyna cytować własne streszczenia na równi ze źródłami, a huachen-wang przy jednym zbiorczym wsadzie znalazł 38% stron będących bliźniakami. Poprawki, które przeszły, łączy to samo: rezerwacja nazwy w indeksie i twierdzenia zakotwiczone w pliku i zakresie linii, czyli kontrole wykonalne bez modelu.
 Poradnik / Praktyka
Pięć linijek, które piszesz, zanim odpalisz drugiego agenta
4 min
Poradnik Warpa o pracy z kilkoma agentami naraz sprowadza się do pięciu linijek wklejanych każdej sesji na start: kto odpowiada za które katalogi, na jakiej gałęzi pracuje i co ma zameldować na koniec. Warp rozpisuje to na osiem kroków, sadza każdego agenta we własnym worktree i wprost zabrania automatycznego scalania, bo cudzy błąd łapiesz tylko przy przeglądzie. Chmurowe polecenie /orchestrate zostawiłbym na migracje monorepo, bo poradnik nie podaje ani kosztu, ani oszczędności, a cztery agenty skracają czas pisania kodu i wydłużają czas jego czytania.
 Poradnik / Praktyka
Zestaw testów agenta potrafi wysłać prawdziwy przelew
4 min
Braintrust tłumaczy, dlaczego test jednostkowy odrzuca poprawny przebieg agenta tylko za to, że sprawdził regulamin przed zamówieniem, i w miejsce asercji wstawia funkcję oceniającą cały zapis pracy w skali od 0 do 1, puszczaną kilka razy na to samo zgłoszenie. Zestaw wpięty w prawdziwe API płatnicze wysyłałby przy tym prawdziwe przelewy, więc usługi trzeba podstawić jako atrapy. Zapamiętałbym stąd liczbę kroków jako sygnał regresji, bo zapala się, zanim wynik zdąży się popsuć. Gorzej, że bramka w CI blokuje merge na ocenie modelu w roli sędziego, którego zgodności z ludźmi nikt nie podaje.
Tydzień 33 · 10–16 sierpnia 2026
Tydzień 32 · 3–9 sierpnia 2026
 Poradnik / Praktyka
Trzy odruchy Opus 5, które przepalają tokeny
4 min
Firmowy przewodnik Anthropica po promptowaniu Opus 5 to głównie lista zabezpieczeń, które trzeba skasować, bo model robi je już sam i tylko przepala na nich tokeny. Jest domyślnie gadatliwszy, sam weryfikuje swoją pracę i chętnie rozdaje robotę podagentom, więc dopiski w rodzaju "sprawdź dwa razy" dokładają kosztu bez zysku, a objętości nie przykręcisz przez effort, bo ten steruje myśleniem, nie długością odpowiedzi. Przy przeglądzie kodu lepiej kazać mu wypisać wszystko, niż prosić o same poważne problemy, a myślenia nie warto gasić, tylko zejść z effort.
 Poradnik / Praktyka
Jak zmieścić dwa modele Llama 3.1 8B na jednym GPU H100
4 min
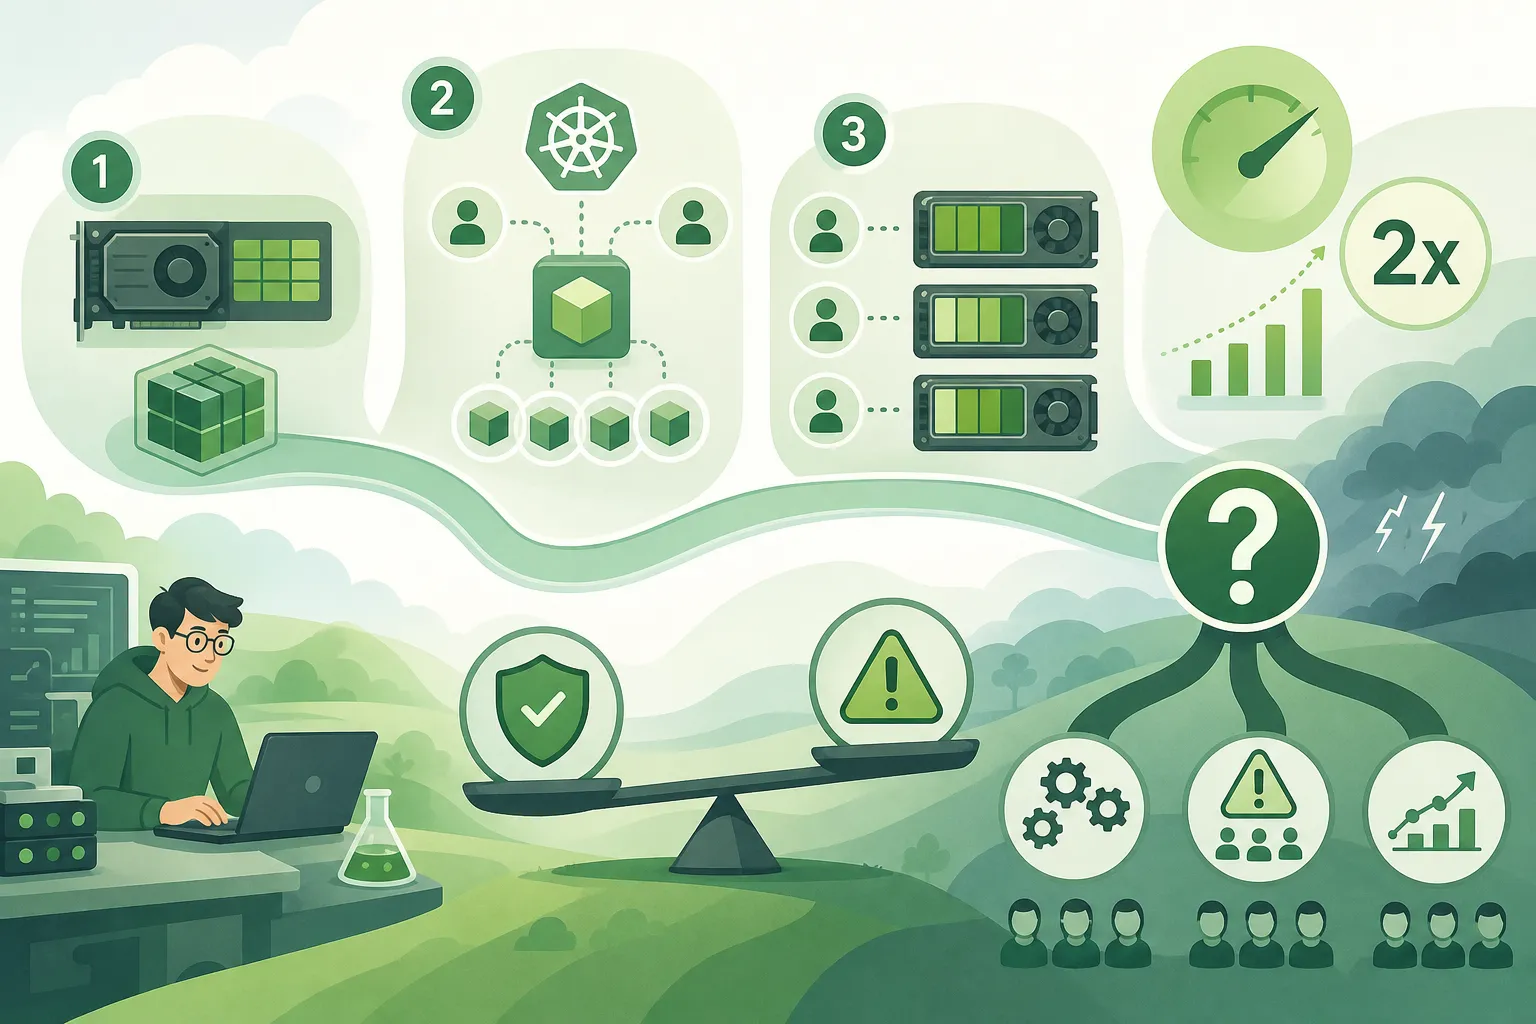
Red Hat pokazał, jak zmieścić dwa osobne modele Llama 3.1 8B, każdy zajmujący około 15 GB, na jednej karcie NVIDIA H100 z 80 GB pamięci, zamiast blokować dwie karty. Recepta łączy technologię NVIDIA MIG, która tnie układ na sprzętowo odizolowane wycinki po 40 GB, z mechanizmem Kubernetesa DRA, który zarządza nimi bez kolizji. To jednak dopiero laboratoryjne demo: funkcja jest w Kubernetesie 1.34 w fazie alpha, na OpenShifcie domyślnie ma wejść od wersji 5.0, a podwojenie działa tylko dla tej konkretnej pary model plus karta.
Tydzień 31 · 27 lipca – 2 sierpnia 2026
 Poradnik / Praktyka
Kiedy graf agenta opłaca się bardziej niż logika schowana w promptcie
4 min
Nowy, 25-stronicowy przewodnik na arXiv, opublikowany 21 lipca przez zespół Daniela Pearsona, argumentuje, że przy długich procesach warto wyjąć logikę sterowania z prompta i narysować ją wprost jako graf w LangGraph, zamiast zdawać się na ukrytą pętlę ReAct. Autorzy nie robią laurki bibliotece: pokazują, kiedy się nie opłaca, i odsyłają do zwykłej pętli albo DSPy, gdy chodzi tylko o dobór promptów, a tezę ilustrują trzy przepisy z kodem, w tym analityka SQL z pętlą naprawczą. Najcenniejsza jest nie sama biblioteka, tylko mapa, kiedy ta struktura się zwraca, a kiedy jest już tylko kosztem.
 Poradnik / Praktyka
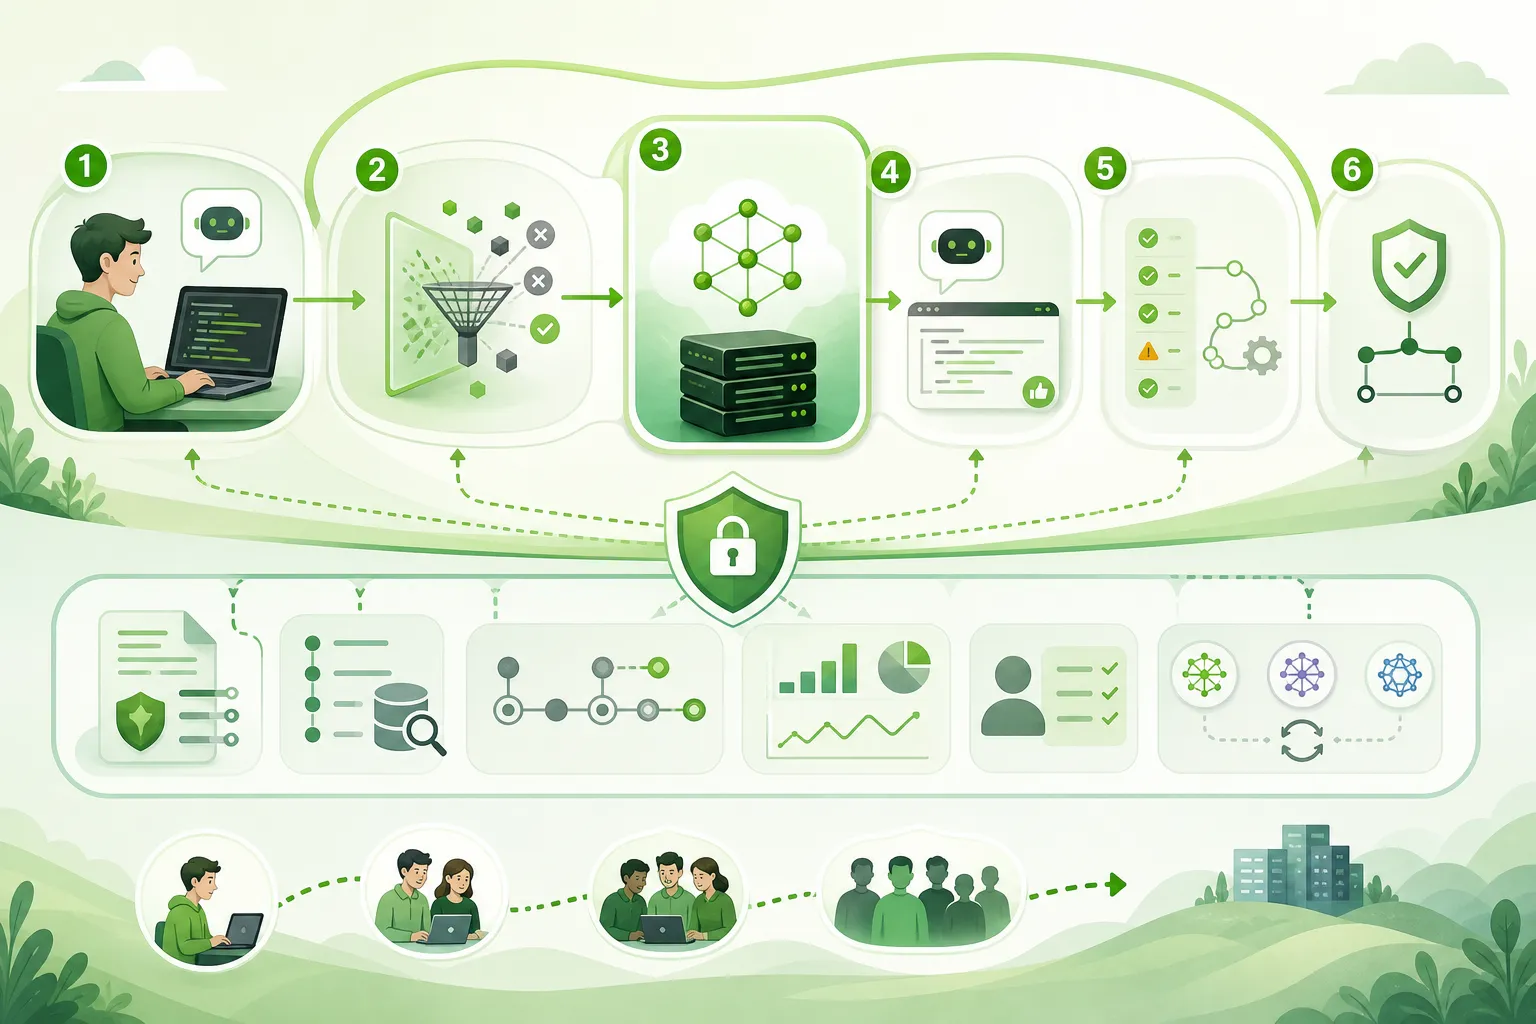
NVIDIA pokazuje, jak wpuścić asystenta AI do wrażliwego kodu, nie oddając mu kontroli
4 min
NVIDIA pokazuje, jak wpuścić asystenta AI do wrażliwego kodu, nie oddając mu kontroli: model tylko podpowiada, a pilnowanie zasad, skanowanie zależności i pomiar żyją poza nim, w systemach, którym zespoły już ufają. Na własnych kartach stoi StarCoder2 o 7 miliardach parametrów w kontenerze udającym API OpenAI, NeMo Guardrails odrzuca ryzykowne zapytania, a bramka w CI wyłapuje slopsquatting, czyli wymyślone przez model nazwy paczek. Zastrzeżenie jest poważne: to przepis, nie wynik, bez ani jednej liczby, a robotę nie tyle zdejmuje z zespołu, ile przesuwa na pisanie i utrzymanie reguł.
 Poradnik / Praktyka
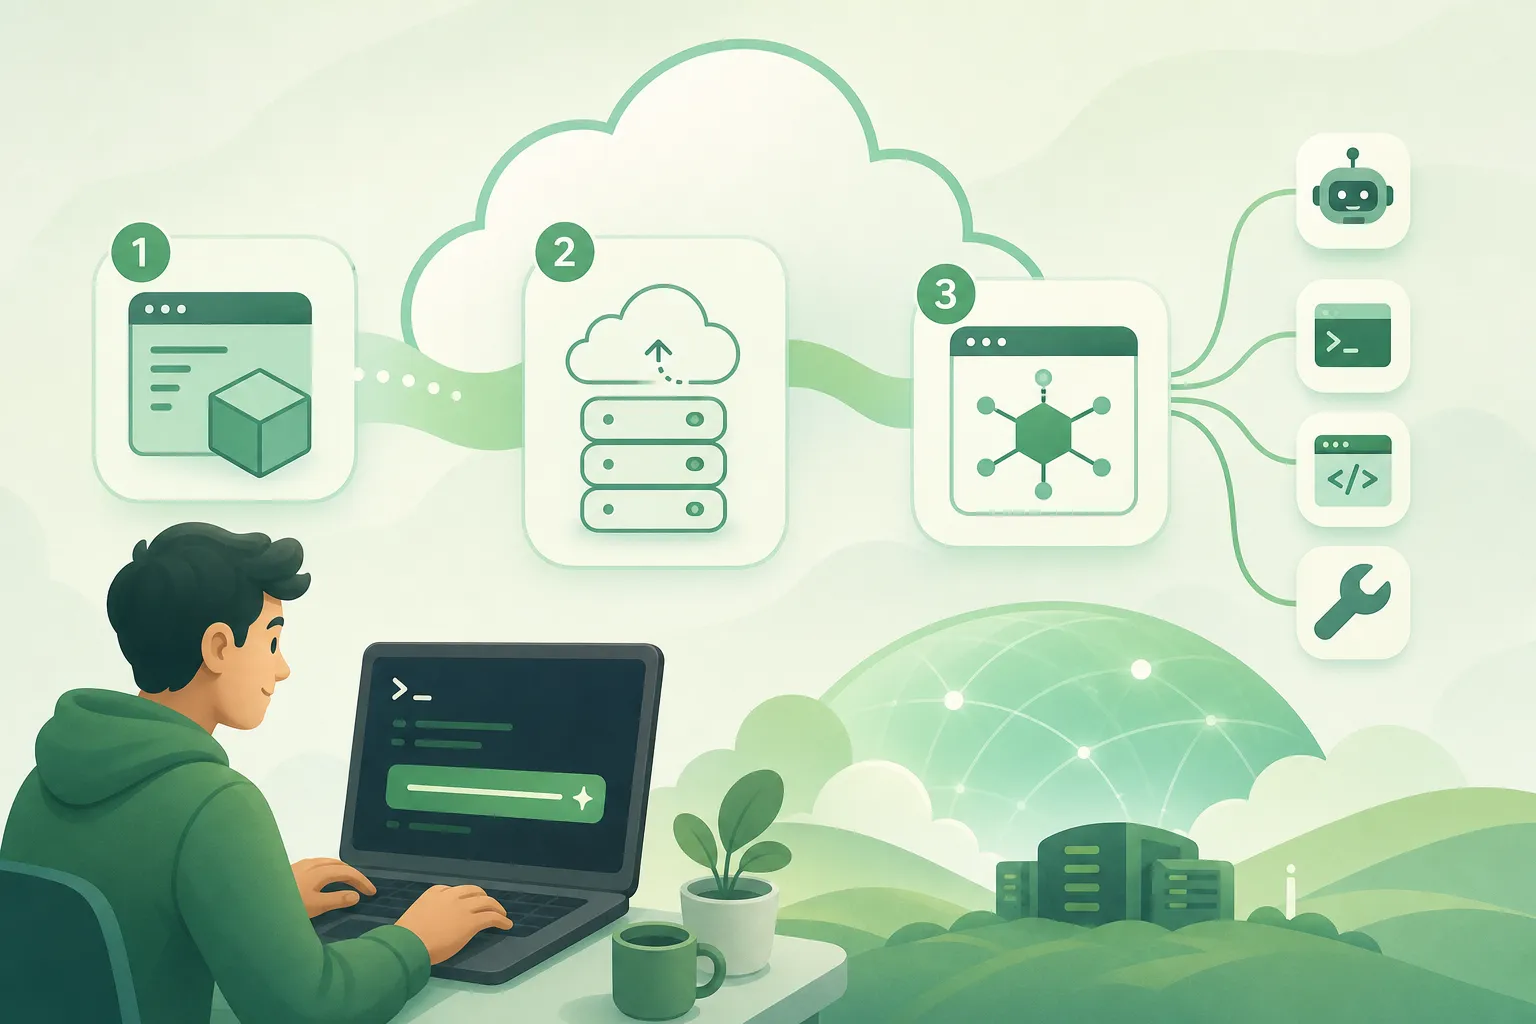
Trzy komendy dzielą pusty katalog od zdalnego serwera MCP
3 min
Dokumentacja Cloudflare Agents sprowadza postawienie zdalnego serwera MCP do trzech komend, tak że w kilkanaście minut pusty katalog zmienia się w narzędzie na workers.dev, którego używa prawdziwy agent. Wzorzec Code Mode idzie dalej: zamiast wystawiać każdy z ponad 2500 endpointów API Cloudflare jako osobne narzędzie, co zjadłoby modelowi ponad milion tokenów, serwer daje tylko search() i execute() i mieści się w około tysiącu. Tyle że bezobsługowy hosting działa wyłącznie na Cloudflare, a oszczędność bierze się z typowanego opisu ich API, więc własne narzędzia i tak piszesz ręcznie.
Tydzień 30 · 20–26 lipca 2026
 Poradnik / Praktyka
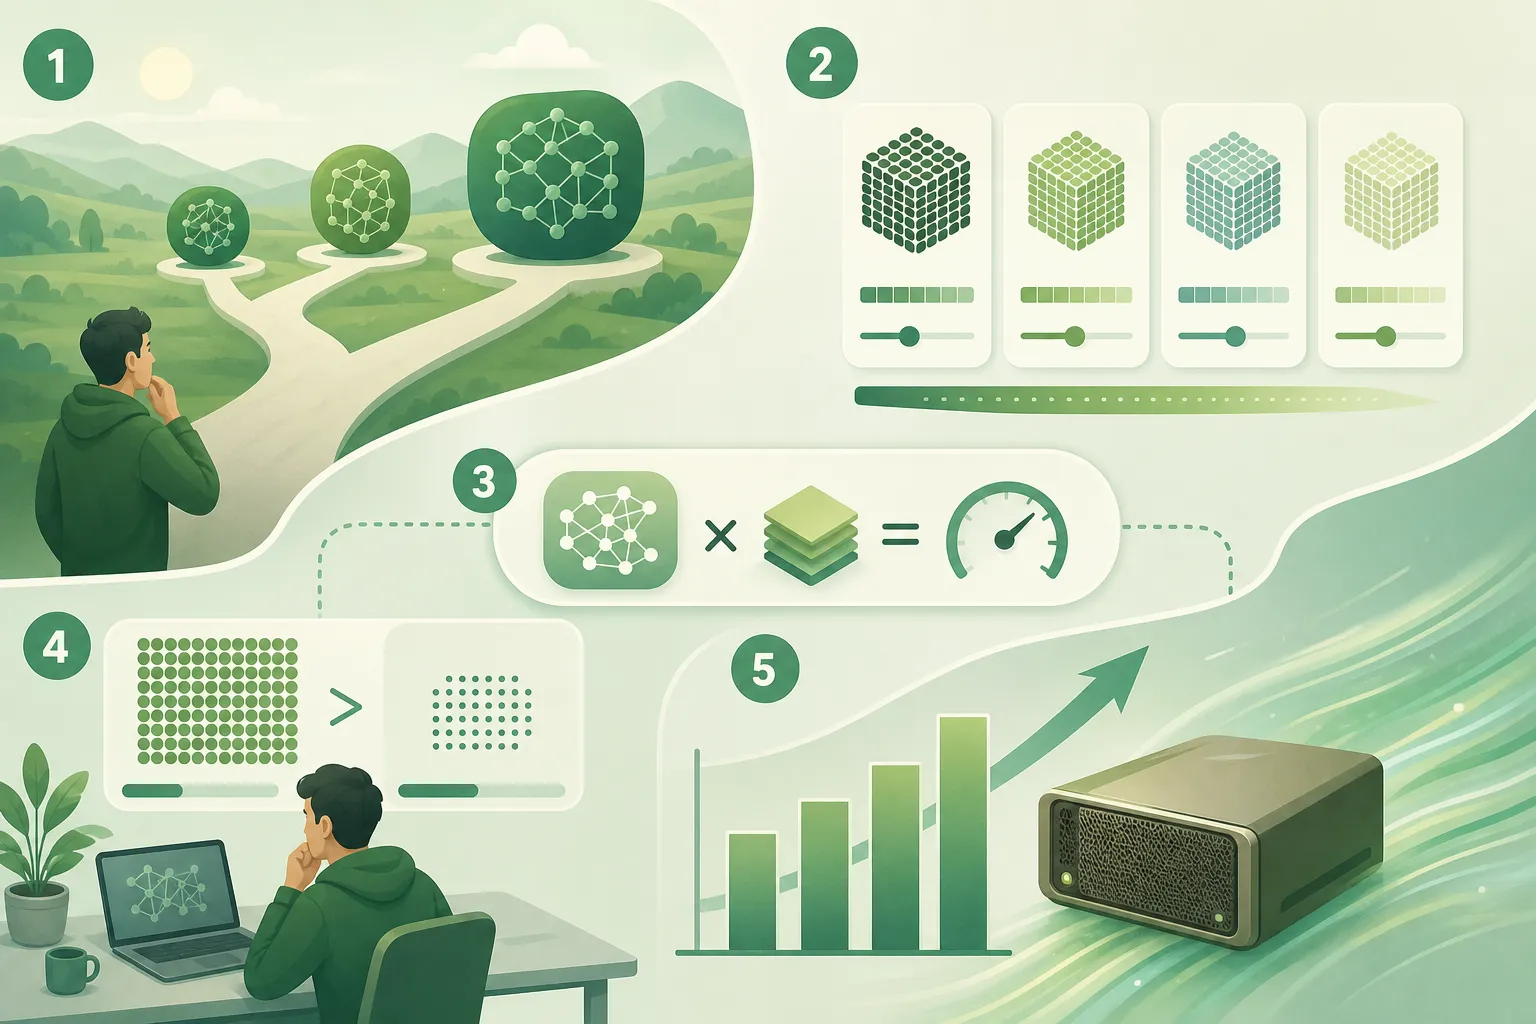
Rozmiar modelu przestał przewidywać jego prędkość
4 min
Model Laguna S 2.1 ma 118 miliardów parametrów, ale generuje tekst szybciej niż czterokrotnie mniejszy Qwen3.6-27B, bo o prędkości decyduje nie całkowity rozmiar, tylko liczba aktywnych parametrów w architekturze MoE. Mori Shige z Classmethod przez pół roku mierzył lokalne modele na DGX Spark i zostały mu z tego dwa odruchy: czytać liczbę aktywnych parametrów zamiast łącznej wagi, a ściągając wersję 4-bitową, sprawdzić dwóch wydawców, bo ta sama kwantyzacja potrafi dać nawet 55% różnicy w prędkości. Dekodowanie spekulatywne podbiło Qwen3.6-35B-A3B o jakieś 40%.
 Poradnik / Praktyka
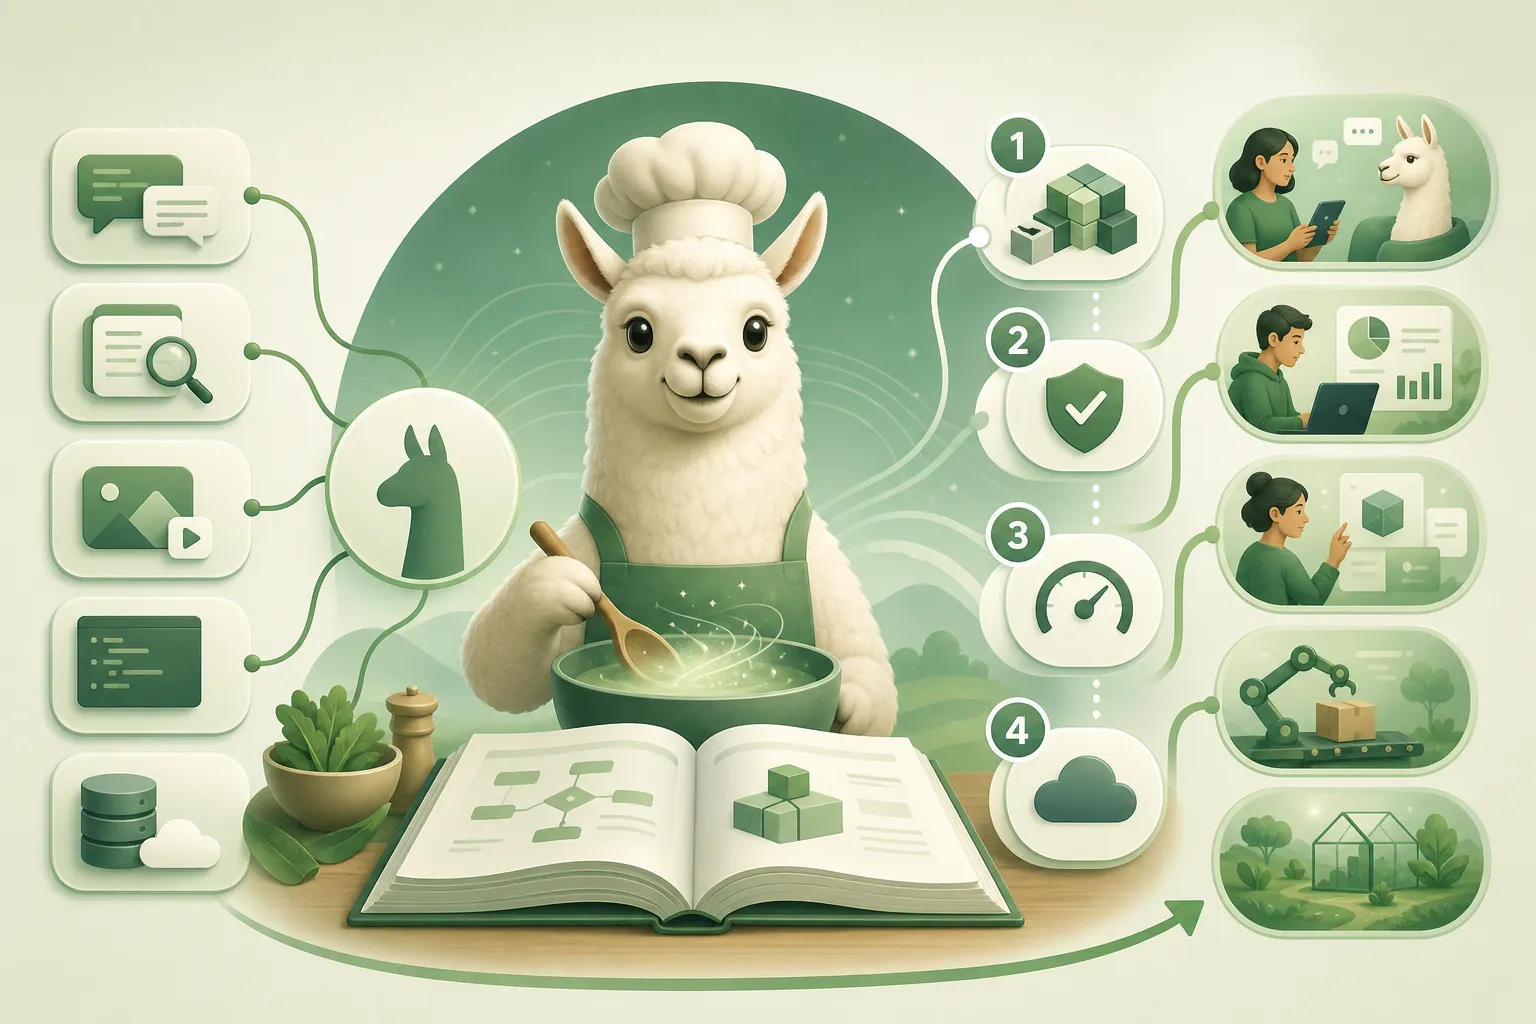
Nowy cookbook Llamy to nie premiera, tylko uporządkowanie i jeden czytelny sygnał
3 min
Meta przemianowała repozytorium llama-recipes na llama-cookbook i przebudowała je od środka, ale to nie premiera, tylko zebranie w jednym miejscu trzech podstaw pracy z modelami Llama: inferencji, fine-tuningu i RAG. Prawdziwym sygnałem są wyróżnione na górze przepisy dla Llamy 4, gdzie wariant Scout dostaje okno kontekstowe 5 milionów tokenów, a Maverick analizator prac naukowych i bota na WhatsAppie. To pokazuje, do czego Meta faktycznie szykuje swój model, czyli długi kontekst i analiza dokumentów, a nie walka o czołowe miejsce w benchmarkach programistycznych.
 Poradnik / Praktyka
Gemma 4 rusza lokalnie na pięć sposobów, a przejście z chmury to jedna linijka
3 min
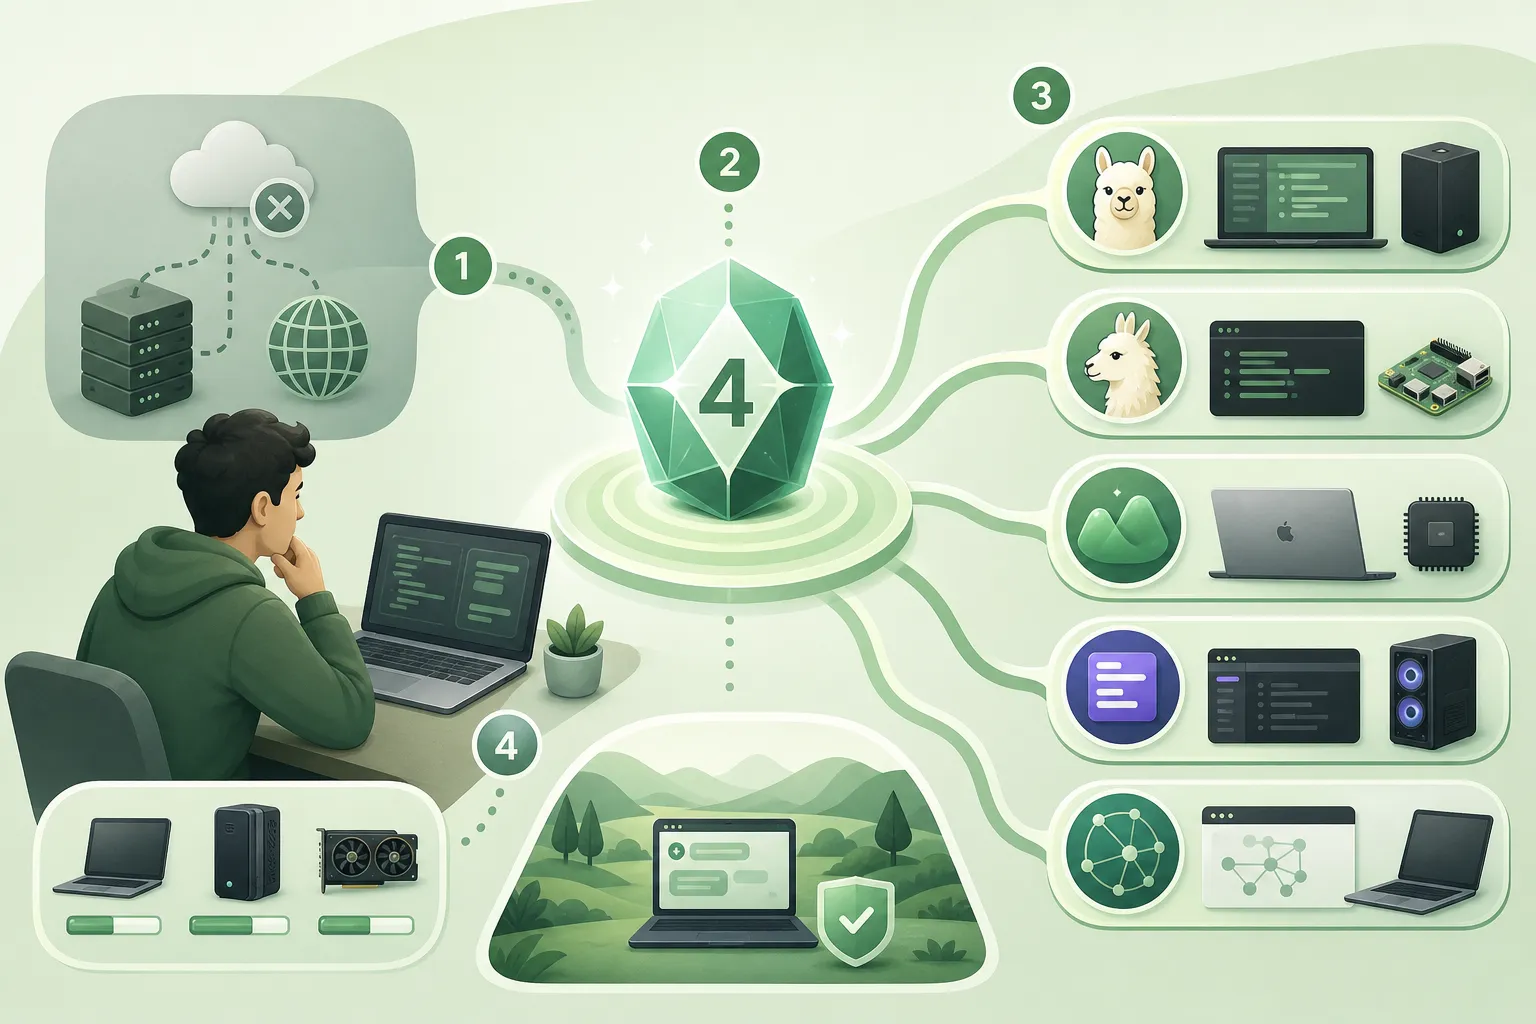
Gemma 4 od Google DeepMind ma już wagi na Hugging Face, a kurs Piyusha Thakura na PyImageSearch pokazuje pięć sposobów odpalenia jej lokalnie: Ollama, llama.cpp, MLX, LM Studio i Transformers.js, w większości bez sieci. Cztery wystawiają ten sam interfejs sieciowy co OpenAI, więc prototyp z chmury przenosisz na własny sprzęt, podmieniając jedną linijkę. Sens to nie sam offline, tylko prywatność danych i brak opłaty za token. Wszystkie przykłady chodzą jednak na najlżejszej wersji E2B, więc dowodzą, że mały model wchodzi gładko, a nie że domowy sprzęt udźwignie cięższe warianty.
 Poradnik / Praktyka
Dziesięć awarii między działającym modelem a czystym bełkotem
4 min
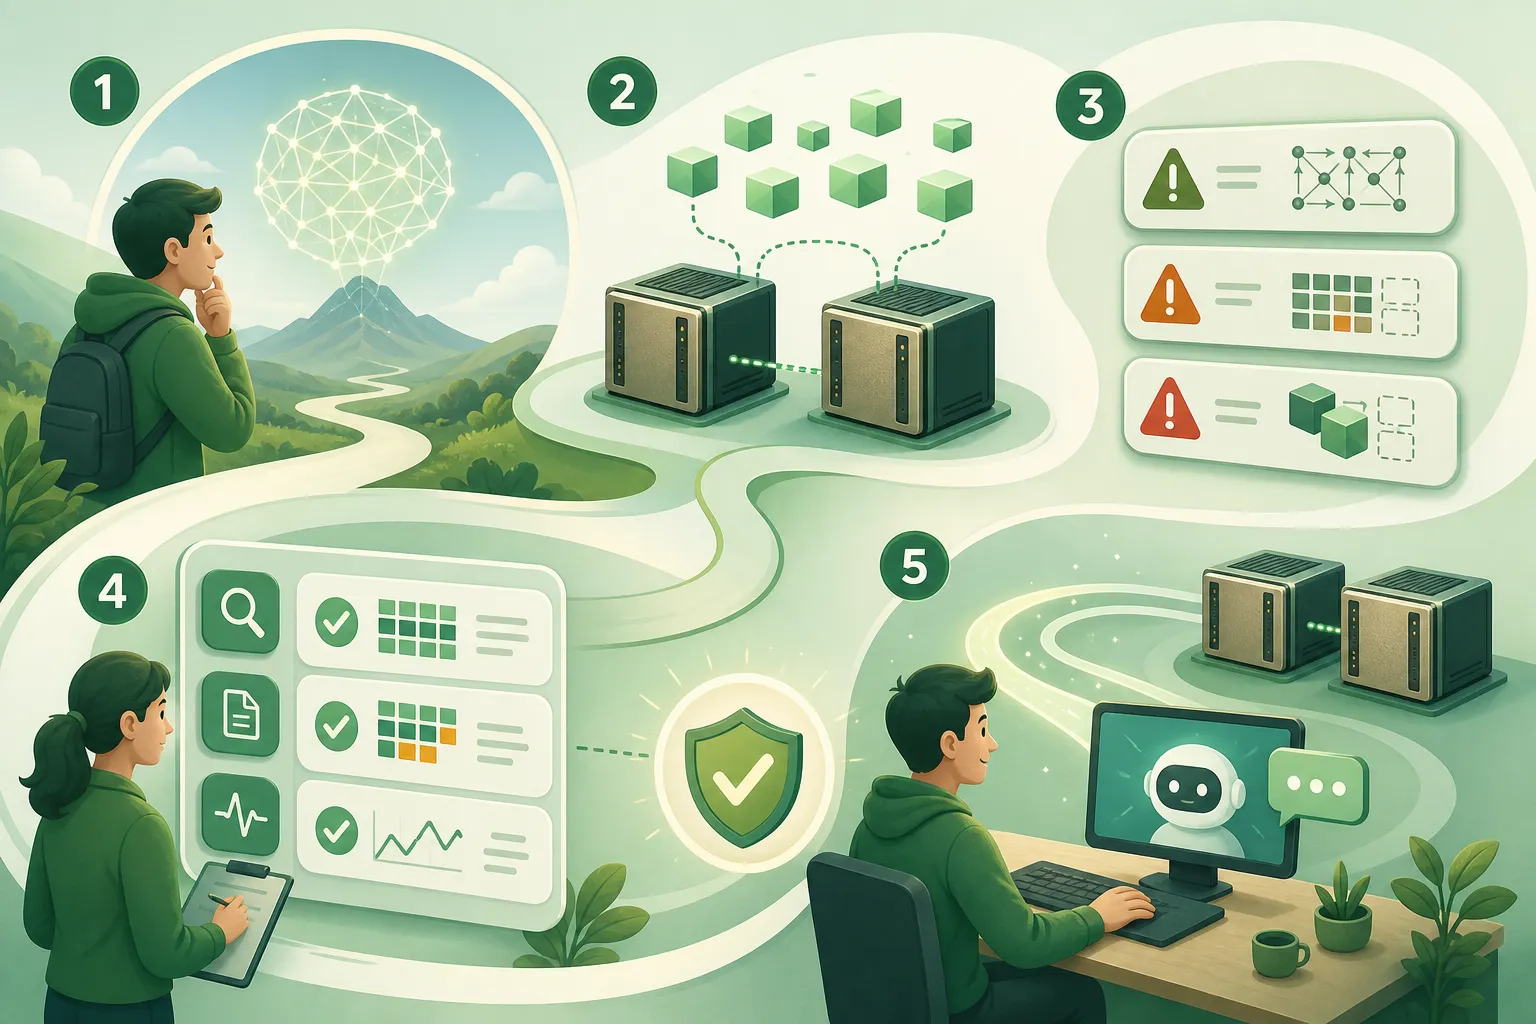
Deweloper tonyd2wild uruchomił GLM-5.2, otwarty model o 753 miliardach parametrów, na dwóch biurkowych DGX Spark, osiągając około 15 tokenów na sekundę. Zmieściło się to dzięki architekturze mixture-of-experts i kwantyzacji ekspertów do 2 bitów, kosztem jakości odpowiedzi. Sednem nie są jednak liczby, tylko lista 10 awarii dzielących "teoretycznie się da" od "faktycznie działa": różne nazwy użytkowników rozbiły ścieżkę do biblioteki NCCL, a brakujący plik z wagami sprawił, że model wstawał czysto i wypluwał bełkot. Główny wniosek: "wstało bez błędów" nie znaczy "działa poprawnie".
Tydzień 29 · 13–19 lipca 2026
 Poradnik / Praktyka
Co naprawdę poprawia rozumowanie modelu, gdy nie możesz sięgnąć po większy?
3 min
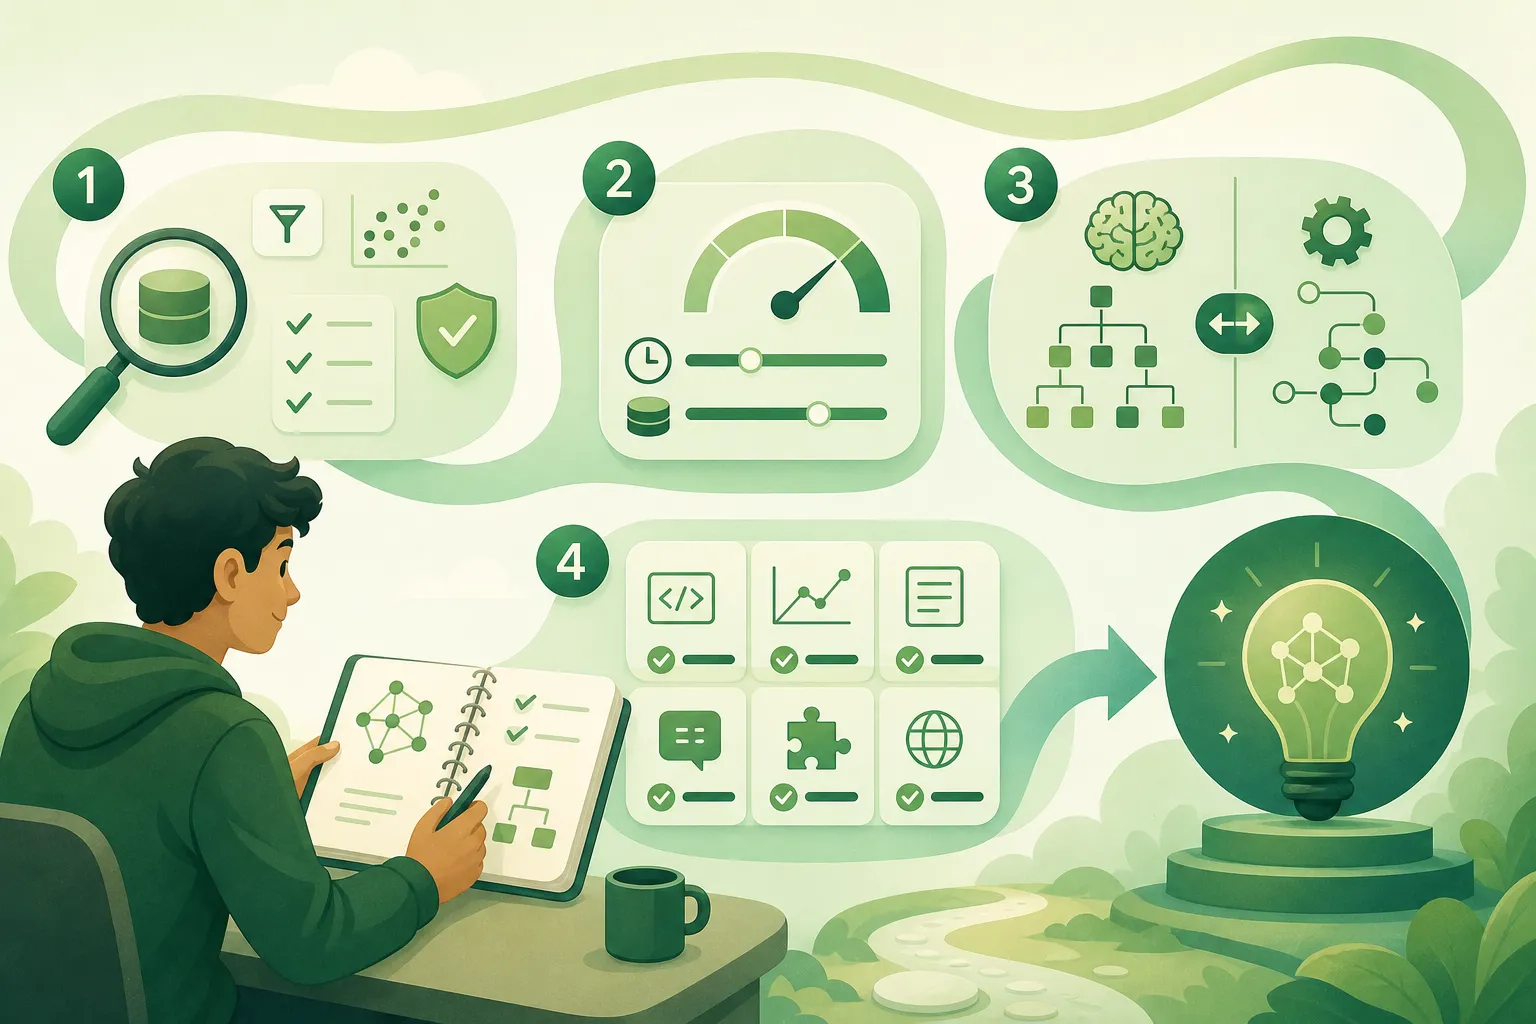
NVIDIA rozegrała na Kaggle konkurs, w którym ponad 5000 uczestników dostało ten sam model Nemotron-3-Nano-30B, mogło doszkalać tylko adapter LoRA i musiało zmieścić rozumowanie w sztywnym budżecie tokenów bez internetu. Z pięciu wniosków wraca jeden: model uczy się tak dobrze, jak dobrze da się sprawdzić każdy krok jego rozumowania, bo prawidłowa odpowiedź potrafi ukrywać zepsutą drogę, a jedna uśredniona liczba zamiata pod dywan słabości w konkretnych zadaniach. To podsumowanie NVIDIA, promujące jej model i karty Blackwell, ale kto dostraja własny model, dostaje gotową listę do sprawdzenia.
 Poradnik / Praktyka
Najtrudniejsza linijka promptu to ta, w której mówisz, co znaczy gotowe
4 min
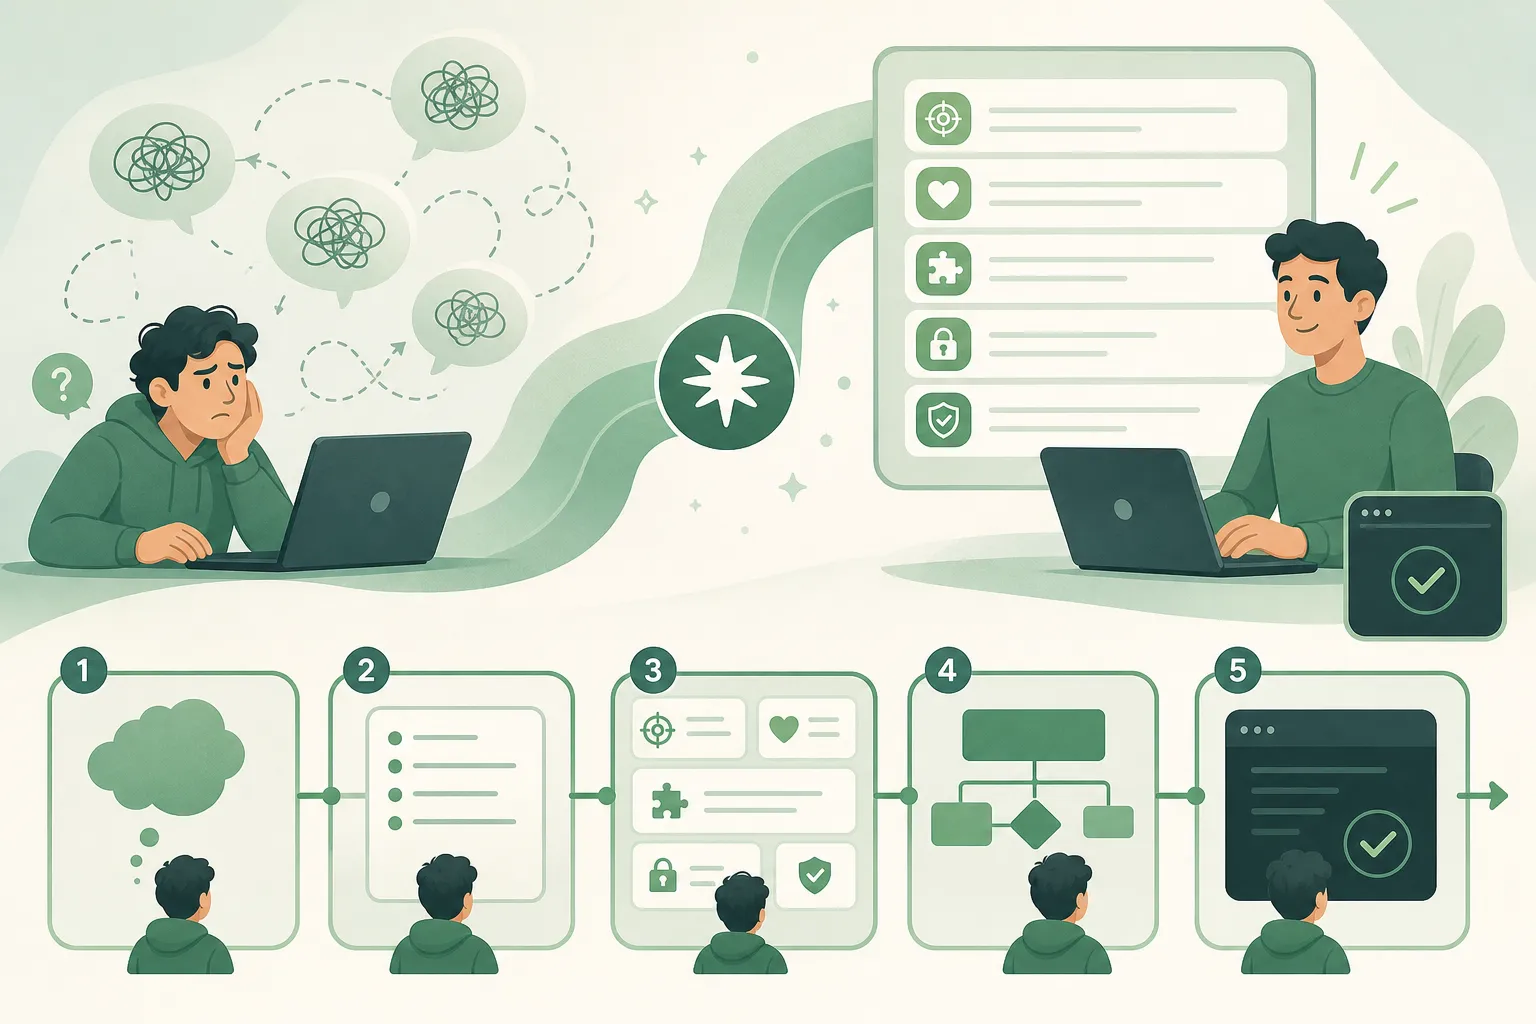
Komenda /goal w Claude Code odwraca pracę z modelem: zamiast sterować nim ruch po ruchu, podajesz metę i szablon z pięcioma polami, a model sam pracuje, aż dowiezie wynik albo wyczerpie limit tur. Najtrudniejsze jest pole VERIFICATION, bo trzeba w nim mierzalnie zapisać, co znaczy „gotowe”, inaczej model kończy za wcześnie albo kręci się w kółko. Sabrina przepuściła szablon przez sześć projektów, ale rada, żeby pracował godzinami, zderza się z ceną: drogi Claude Fable ma ścięty o połowę tygodniowy limit, więc rozsądniej puszczać go na planowanie, a pisanie kodu zostawić tańszemu Opusowi 4.8.