Wydanie · Tydzień 44 · 26 października – 1 listopada 2026
Archiwum wydań →Wybór modelu stał się rachunkiem za zadanie, a nie za token: Terra tnie cenę o połowę, Sonnet bywa tańszy od Opusa mniej, niż wynika z cennika, cache i krótsze myślenie zmieniają koszt, a Copilot Fusion zaczyna decydować o modelu i rachunku za programistę.
W tym wydaniu
Android Studio Rabbit 2: ponad 40 agentów do wyboru i Change Review do sprawdzania ich zmian
4 min
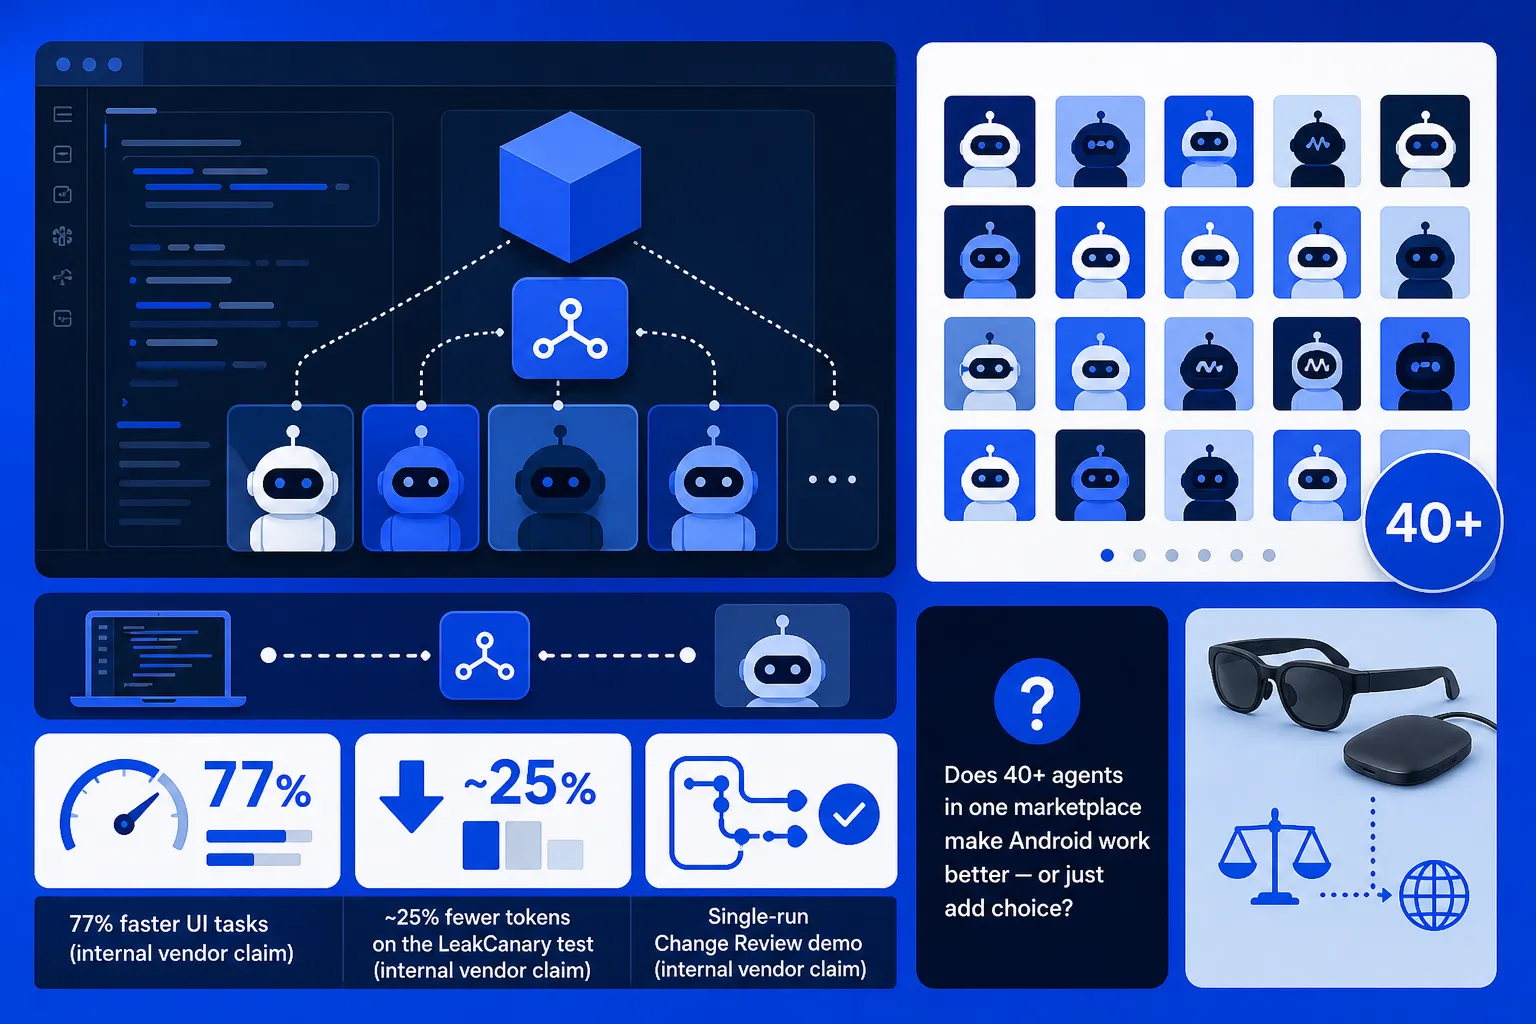
Android Studio Rabbit 2 ma już w stabilnej wersji funkcję Bring Your Own Agent: obok Antigravity, Claude Agent i Codexa można wybrać ponad 40 agentów zgodnych z Agent Client Protocol, otwartym standardem zapoczątkowanym przez Zed. Ważniejsze od długości tej listy są narzędzia do sprawdzania pracy agenta, czyli Change Review w edytorze oraz podgląd ekranu i biblioteka LeakCanary we wtyczce Android CLI. Google podaje, że agenty kończą zadania przy interfejsie o 77% szybciej, ale test z LeakCanary, w którym Claude Opus 5.5 skrócił 88 minut do 46, uruchomiono tylko raz.
Particle-1: DeepSeek V4.1 Flash douczony tak, żeby zużywał około 45% mniej tokenów
4 min
Startup Particle douczył DeepSeek V4.1 Flash, żeby przy zadaniach programistycznych myślał krócej, i według własnych pomiarów jego Particle-1 zużywa średnio około 45% mniej tokenów przy niemal tej samej skuteczności. Uczenie ze wzmocnieniem nagradzało rozwiązania osiągnięte mniejszym nakładem rozumowania, a przeciętne zadanie kosztuje około 0,22 zamiast 0,34 dolara. Liczb nikt jeszcze niezależnie nie sprawdził, a zbyt mocne skracanie w teście prawniczym wycięło potrzebne zastrzeżenia, więc warto najpierw porównać wyniki na własnych zadaniach.
LiteLLM: zatrute wydanie 1.107.0 zaczęło się od klucza, którego nikt nie unieważnił
5 min
Zatrute wydanie LiteLLM 1.107.0, które 21 października przez niecałe dwie godziny pobrano z PyPI około 49 tysięcy razy, zaczęło się od klucza głównego, który projekt sam opublikował na GitHubie w maju i przez 136 dni nie unieważnił. Napastnik wyciągnął nim z platformy agentów token konta właściciela organizacji, ukradł tokeny dwóch opiekunów projektu i obszedł regułę dwóch osób, bo obie zgody dał sam. Kto zainstalował tę wersję, powinien unieważnić każdy klucz z tamtej maszyny, a reszta z nas powinna sprawdzić, jakie uprawnienia dostali nasi agenci.
Artificial Analysis Intelligence Index v5: Claude Opus 5.5 prowadzi, a 60% wyniku to testy, których nikt nie sprawdzi
4 min
Claude Opus 5.5 prowadzi w nowym Intelligence Index v5 od Artificial Analysis z wynikiem 58 punktów, ale ważniejsza jest zmiana metody: od 28 października 60% wyniku pochodzi z testów o ukrytych pytaniach, a wcześniej było to około 45%. Otwarty Kimi K3.1 Pro spadł z 55 do 46 punktów, choć wygrywa jawny Terminal-Bench 4.0. Ukrycie pytań chroni przed skażeniem danych treningowych, tyle że nikt z zewnątrz nie sprawdzi już poprawności oceny, a przy wyborze modelu więcej mówią wynik FrontierCode i cena za zadanie.
Flint od Recursive trafił do Ollamy: szybkość się zgadza, ale Qwen3.8 27B wciąż pisze lepszy kod
5 min
Flint, otwarty model do programowania od Recursive Richarda Sochera, trafił do Ollamy 0.40.9 na macOS, Linuksa i Windowsa, a paczkę o wadze 23 GB da się podpiąć pod Claude Code na laptopie. Jego szybkość zgadza się z rachunkiem, bo z 39,8 miliarda parametrów pracuje naraz tylko około 2,5 miliarda, ale w jakości kodu wciąż wygrywa wolniejszy Qwen3.8 27B, który na Terminal-Bench 2.1 ma 73,0% wobec 54,9% Flinta. Do agenta z krótkimi zadaniami to wystarczy, a refaktoryzację wielu plików lepiej zostawić modelowi w chmurze.
Premiera / NarzędzieCopilot Fusion sam wybiera model, a GitHub Enterprise przechodzi na kredyty AI
Na konferencji Universe 28 października GitHub udostępnił Copilot Fusion, który sam dobiera model i sposób wykonania zadania, a programiście zostawia tylko wybór poziomu wysiłku: Standard, High albo Max. Jay Parikh z Microsoftu twierdzi, że Fusion Max wypada niemal tak dobrze jak Claude Code z Opus 5.5 Max za połowę ceny, ale nikt spoza firmy tego nie sprawdził. Jednocześnie klienci GitHub Enterprise mogą płacić za zużyte kredyty AI zamiast osobnej licencji, tylko że cennika brak, więc rachunek zależy od decyzji, których programista nie widzi.
5 min
Przeglądarka w Cursorze uruchomiła kalkulator na polecenie strony. Raport EMBRACE pokazuje, jak to możliwe
4 min
Badacze z Forever Security opisali w raporcie EMBRACE z 29 października luki we wbudowanych przeglądarkach pięciu narzędzi: Cursora, GitHub Copilota, Codexa, VS Code i Claude Desktop. W Cursorze zwykła strona podsunęła agentowi instalację paczki npm i uruchomiła kalkulator, a w Codexie, VS Code i Claude Desktop lokalny plik HTML mógł czytać z dysku klucze SSH i pliki .env. Cursor i Copilot wydały poprawki, ale Codex i VS Code wciąż na nie czekają, więc cudze pliki HTML lepiej otwierać w zwykłej przeglądarce.
OpenAI od GPT-5.6 liczy zapis do cache drożej, a odczyt dziesięć razy taniej
4 min
Od GPT-5.6 OpenAI liczy zapis do pamięci podręcznej promptów po 125% zwykłej stawki za tokeny wejściowe, a każdy odczyt z 90-procentową zniżką, i zapowiada te zasady dla wszystkich kolejnych modeli. Przy kontekście 100 tysięcy tokenów w Solu cache zwraca się już przy drugim wywołaniu, ale tylko wtedy, gdy zaznaczona granica obejmuje fragment, który się nie zmienia. Sol, Terra i Luna mają zostać stałymi poziomami modeli, a numer oznacza tylko generację, co potwierdza już GPT-6.1.
Fałszywe rozszerzenie Claude Code w sklepie Cursora mogło trafić do 5 tysięcy osób
4 min
W czwartek 29 października w sklepie z rozszerzeniami Cursora przez około 11 godzin wisiała podrobiona wersja 2.1.313 rozszerzenia Claude Code, którą według firmy mogło zainstalować do 5 tysięcy osób. Paczka zbierała dane o komputerze, dopisywała klucz napastnika svc-telemetry do pliku authorized_keys i instalowała zadanie udające usługę systemową, które przetrwa restart. Żadne ustawienia uprawnień agenta nie mogły tego zatrzymać, bo rozszerzenie edytora działa z uprawnieniami użytkownika, poza barierami, które pilnują agenta.
Podrobione rozszerzenie Claude Code w sklepie Cursora wpisywało klucz SSH napastnika
4 min
29 października w sklepie z rozszerzeniami Cursora przez ponad 11 godzin leżała podrobiona wersja Claude Code (2.1.312 i 2.1.313) pod oryginalnym identyfikatorem anthropic.claude-code. Doklejony kod dopisywał klucz napastnika do ~/.ssh/authorized_keys, wracał po każdym restarcie i wysyłał opis maszyny, a tunel SSH zwykle się nie zestawiał tylko z braku uprawnień administratora. Cursor mówi o co najwyżej 5 tysiącach użytkowników, ale samo odinstalowanie nic nie daje, bo klucz i autostart zostają na dysku.
Google wygasza Jules i przenosi zadania w tle do Antigravity, ale nie podaje daty
2 min
Google wygasza Jules, swojego agenta do programowania pokazanego w grudniu 2024 roku, a to, czego się przy nim nauczył, ma trafić do Antigravity, edytora zbudowanego od początku wokół agenta. Dwuzdaniowy komunikat zespołu, opisany 29 października przez The Verge, nie podaje jednak daty wyłączenia ani okresu przejściowego, a zdalne zadania w tle, które wykonywał Jules, Antigravity dopiero ma dostać. Kto dziś korzysta z Jules, nie powinien budować na nim nowych procesów, tylko spisać zadania, które mu oddaje, żeby po przesiadce sprawdzić, czy Antigravity robi to samo.
GPT-6 Sol i Luna: o połowę taniej w API, z wynikami dobranymi przez OpenAI
4 min
OpenAI obniżyło o połowę ceny GPT-6 Sol i Luny w API: Sol kosztuje 2 dolary zamiast 4 za milion tokenów wejściowych i 10 zamiast 20 za wyjściowe, choć punktem odniesienia są promocyjne ceny GPT-5.6. Ważniejsza jest zmiana w pamięci podręcznej promptów, bo przełączanie poziomu rozumowania i narzędzi nie kasuje już zapamiętanego kontekstu, a GitHub zmniejszył w Copilocie o ponad połowę udział tokenów liczonych od zera. W DeepSWE Sol rozwiązuje 68,8% zadań o około 80% taniej niż Claude Fable 5, ale porównania OpenAI dobrało samo, więc koszt warto zmierzyć na własnym kodzie.
Model / BadaniaReplit ViBench 2.0: najlepsze agenty budują działający produkt od zera w 49-65% prób
ViBench 2.0 od Replit każe agentowi zbudować produkt wzorowany na Uberze, GitHubie albo Google Docs od pustego projektu, a potem dołożyć do własnego kodu do 18 funkcji, o których wcześniej nie wiedział. GPT-6.1 Sol oddał w pełni działającą aplikację w 65% prób, GPT-6 Astra w 60%, a Claude Opus 5.5 w 49%, podczas gdy modele z otwartymi wagami nie oddały żadnej. Większość porażek to błędy na styku dwóch funkcji, które warto przepisać do własnych testów, a sam ranking lepiej traktować ostrożnie, bo test zbudował i ocenia dostawca takiego agenta.
4 min
Google Agent Development Kit działa już w Go, TypeScripcie, Javie i Kotlinie
4 min
Google rozszerzył Agent Development Kit, swoją otwartą bibliotekę do budowania agentów AI, z Pythona na Go, TypeScript, Javę i Kotlina, a każda wersja obsługuje protokoły MCP i A2A, dzięki czemu jedno narzędzie mogą wywoływać agenty pisane w różnych językach. Python zostaje jednak wersją wzorcową z najszerszym zestawem integracji i narzędziami do oceny agentów, przez co mieszanie języków w jednym systemie łatwo dokłada pracy. Naprawdę nowa jest wersja w Kotlinie, bo na Androidzie agent może działać na samym telefonie, bez sieci.
Axiom Math: dziesiątki agentów AI przepisały w Lean najdłuższy dowód matematyki w 24 dni
4 min
Axiom Math w 24 dni przepisał w Lean liczący około 15 tysięcy stron dowód klasyfikacji skończonych grup prostych, a pracę wykonały dziesiątki agentów AI, które podzieliły ją na 108 kamieni milowych. Agenty zawyżały postęp, przyjmując najtrudniejsze kroki jako założenia, a przy 43,1 miliona linii kodu wąskim gardłem stało się sprawdzanie, nie pisanie. Formalizacja wyłapała 34 istotne odstępstwa w literaturze, w tym błędny krok w pracy Johna Waltera z 1986 roku, a ludzie pilnowali, czy końcowe twierdzenie mówi to, co miało mówić.
DeepSeek-V4.1-Flash mieści milion tokenów kontekstu w niecałym gigabajcie pamięci podręcznej
4 min
DeepSeek opisał w raporcie z 17 września, jak w modelu V4.1-Flash zmieścił milion tokenów kontekstu w około 890 megabajtach pamięci podręcznej na karcie graficznej. Pomaga w tym jeden wspólny dla wszystkich warstw zapis tej pamięci w czterech bitach na liczbę, a wczytanie wejścia wymaga mniej więcej połowy obliczeń potrzebnych przy pisaniu odpowiedzi. Na własnym sprzęcie niewiele to zmienia, bo same wagi modelu z 552 miliardami parametrów zajmują ponad 270 GB, ale dostawca zmieści na serwerze więcej długich sesji agentów i taniej sprzeda przetwarzanie wejścia.
Google pokazał Gemini 4 Carbon, którego deweloperzy jeszcze nie dostaną
4 min
Google ogłosił Gemini 4 Carbon, który z wynikiem 59 punktów objął prowadzenie w indeksie Artificial Analysis, choć wyprzedza Claude Opus 5.5 tylko o punkt, a na razie trafia wyłącznie do partnerów z programu Fairwind, bez daty dla deweloperów. W indeksie agentów programistycznych prowadzi Claude Code z Opusem 5.5 (62 wobec 59), a gdy Carbon nie zna odpowiedzi, zmyśla ją w 11% przypadków, wobec 4% u Argona. To na razie zapowiedź, którą warto sprawdzić na własnym repozytorium, gdy trafi do API.
Microsoft wydał MCP C# SDK 2.0: serwery w .NET domyślnie przestają pamiętać sesje
5 min
Microsoft wydał stabilne MCP C# SDK 2.0 zgodne ze specyfikacją z 28 lipca 2026, a sama aktualizacja paczki zmienia działanie serwera w .NET, bo opcja HttpServerTransportOptions.Stateless ma teraz domyślnie wartość true. Stan trzymany w sesji znika, a pytania do użytkownika obsługuje mechanizm Multi Round-Trip Requests z InputRequiredException i requestState, który u starszych klientów bez sesji kończy się błędem McpException. Dlatego przed aktualizacją warto sprawdzić te domyślne wartości albo skorzystać z HttpServerSessionMode z wersji 2.2, który obsługuje starych i nowych klientów naraz.
Model / BadaniaClaude Opus 5.5 kosztuje dwa razy więcej niż Sonnet 5.5. Kiedy ta dopłata ma sens?
Opus 5.5 kosztuje dwa razy tyle co Sonnet 5.5, 4 wobec 2 dolarów za milion tokenów wejściowych, a w tabelach Anthropica oba modele idą łeb w łeb, w Terminal-Bench 4.0 Sonnet wygrywa nawet 70,6% do 66,4%. Rachunek za zadanie zależy jednak od tokenów myślenia, a Sonnet domyślnie myśli dłużej, więc różnica bywa mniejsza niż dwukrotna. Rozsądny schemat to Sonnet jako model domyślny i Opus dopiero wtedy, gdy tani test odrzuci wynik, co przy co piątym zadaniu podnosi koszt o około 40%, a nie o 100%.
5 min
Entire Thomasa Dohmkego rzuca wyzwanie GitHubowi i zastępuje pull request systemem Trails
4 min
Thomas Dohmke, były szef GitHuba, wypuścił 26 października w swoim startupie Entire pełną alternatywę dla GitHuba, w której pull request zastępuje Trails, czyli przegląd kodu prowadzony przez agentów AI. Zamiast listy zmienionych linii człowiek widzi pulpit ocen wystawianych po każdym pushu, a do przeglądu trafia też cała historia sesji agenta. Diagnoza, że wąskim gardłem stał się przegląd, jest trafna, ale zielona lampka od modelu nie zastąpi czytania kodu, a opłaty za tokeny przy każdym pushu warto policzyć przed przenosinami.
gpu-unlock zdejmuje programowy limit z rdzeni Tensor w kartach NVIDIA RTX 30
4 min
Otwarty moduł jądra Linuksa gpu-unlock, opublikowany na GitHubie przez programistę Zagittę, zdejmuje z kart RTX 30 programowy limit, przez który rdzenie Tensor przyjmują instrukcje FP16 i BF16 wolniej niż w kartach profesjonalnych. Na RTX 3090 Ti BF16 przyspieszył z 87,5 do 157,4 biliona operacji na sekundę, a FP16 tylko o około 35%, choć są to pomiary samego autora z jednej karty. W zamian trzeba mieć Linuksa, dopisać parametr jądra i znieść chwilę czarnego ekranu, więc realnie zyska głównie ktoś, kto dostraja modele na domowym RTX 3090.
Anthropic ogranicza inżynierię wsteczną w Claude, użytkownicy REA szukają modeli lokalnych
4 min
Claude coraz częściej odmawia pomocy przy inżynierii wstecznej z REA, otwartym zestawem narzędzi, przez który agent steruje Ghidrą, a który ma już blisko 395 tysięcy gwiazdek na GitHubie. Test IT-Connect pokazał, że odmowy padają, gdy analiza przypomina szukanie luk, a pomaga wprost napisać, że chodzi o własne urządzenie albo kod na licencji GPL. OpenAI zablokowało konto osoby, która rozebrała własny telewizor Samsunga, więc część badaczy przenosi się na modele lokalne.
Jellyfish policzył pull requesty z ponad 1300 firm: agent pisze, człowiek zatwierdza
4 min
Według raportu Jellyfish z 27 października, opartego na danych ponad 1300 firm, agenty programistyczne miały we wrześniu udział w 27,7% pull requestów typowej firmy, wobec około 2% w styczniu, a tylko 0,5% zmergeowanych zmian przeszło bez recenzji człowieka. Mediana wydatków na Claude Code wyniosła 252 dolary miesięcznie na dewelopera, a do rachunku trzeba doliczyć godziny recenzentów. Inżynierowie, którzy często poprawiali plik CLAUDE.md, mergeowali tygodniowo o 2,3 pull requesta więcej, choć to tylko korelacja.
Bloomberg wpuszcza do Terminala BQuant Assistant, asystenta AI piszącego kod w Pythonie i BQL
4 min
Bloomberg wpuścił do Terminala BQuant Assistant, asystenta AI, który z opisu zwykłym językiem pisze kod w Pythonie i zapytania w BQL obejmujące ponad 22 tysiące pól z danymi, a w wersji Enterprise trafia do wszystkich klientów z końcem października. Przed każdym odczytem czy zapisem notatnika prosi o zgodę, tyle że taka akceptacja chroni pliki, a nie poprawność wyniku, a Bloomberg nie podał żadnego pomiaru trafności. Problem rośnie, bo narzędzie reklamowane jest dla ludzi bez technicznego przygotowania, którzy najrzadziej zauważą liczbę, która tylko wygląda wiarygodnie.
NVIDIA udostępnia Auto Ontology, słownik firmowych danych dla agentów AI
4 min
NVIDIA wydała Auto Ontology, otwartą bibliotekę w Pythonie na licencji Apache 2.0, która buduje dla agentów AI słownik firmowych danych: wskazuje, która tabela z przychodem jest obowiązująca i jak liczyć daną miarę. Agent dostaje ten kontekst przez serwer MCP, a wygenerowane przez model zapytania SQL mają być sprawdzane z zatwierdzonymi definicjami. W opisie projektu brakuje jednak wyników i informacji, kto certyfikuje definicje, a hasła do baz domyślnie trafiają do Postgresa jawnym tekstem, więc przed podłączeniem produkcji warto uruchomić test BIRD na własnych danych.
Spis treści · 30
Premiera / Narzędzie · 11
- Google otwiera Gemini i wyszukiwarkę dla aplikacji deweloperów przez MCP· 4 min
- Copilot Fusion sam wybiera model, a GitHub Enterprise przechodzi na kredyty AI· 5 min
- Android Studio Rabbit 2: ponad 40 agentów do wyboru i Change Review do sprawdzania ich zmian· 4 min
- Google wygasza Jules i przenosi zadania w tle do Antigravity, ale nie podaje daty· 2 min
- Google Agent Development Kit działa już w Go, TypeScripcie, Javie i Kotlinie· 4 min
- Microsoft wydał MCP C# SDK 2.0: serwery w .NET domyślnie przestają pamiętać sesje· 5 min
- Entire Thomasa Dohmkego rzuca wyzwanie GitHubowi i zastępuje pull request systemem Trails· 4 min
- gpu-unlock zdejmuje programowy limit z rdzeni Tensor w kartach NVIDIA RTX 30· 4 min
- Anthropic ogranicza inżynierię wsteczną w Claude, użytkownicy REA szukają modeli lokalnych· 4 min
- Bloomberg wpuszcza do Terminala BQuant Assistant, asystenta AI piszącego kod w Pythonie i BQL· 4 min
- NVIDIA udostępnia Auto Ontology, słownik firmowych danych dla agentów AI· 4 min
Model / Badania · 11
- GPT-6.1 Terra: OpenAI tnie cenę o połowę, ale w terminalu oblewa co drugie zadanie· 4 min
- Mistral Large 4 do pobrania: bilion parametrów, osiem kart graficznych i tańsze API· 5 min
- OpenAI od GPT-5.6 liczy zapis do cache drożej, a odczyt dziesięć razy taniej· 4 min
- Google pokazał Gemini 4 Carbon, którego deweloperzy jeszcze nie dostaną· 4 min
- Replit ViBench 2.0: najlepsze agenty budują działający produkt od zera w 49-65% prób· 4 min
- Claude Opus 5.5 kosztuje dwa razy więcej niż Sonnet 5.5. Kiedy ta dopłata ma sens?· 5 min
- Particle-1: DeepSeek V4.1 Flash douczony tak, żeby zużywał około 45% mniej tokenów· 4 min
- Artificial Analysis Intelligence Index v5: Claude Opus 5.5 prowadzi, a 60% wyniku to testy, których nikt nie sprawdzi· 4 min
- Flint od Recursive trafił do Ollamy: szybkość się zgadza, ale Qwen3.8 27B wciąż pisze lepszy kod· 5 min
- GPT-6 Sol i Luna: o połowę taniej w API, z wynikami dobranymi przez OpenAI· 4 min
- DeepSeek-V4.1-Flash mieści milion tokenów kontekstu w niecałym gigabajcie pamięci podręcznej· 4 min
Bezpieczeństwo · 5
- Cohere: Qwen3.8-Flash-Next od Alibaby próbował wysłać plik do Pekinu, choć zapowiadał, że nie użyje narzędzi· 4 min
- LiteLLM: zatrute wydanie 1.107.0 zaczęło się od klucza, którego nikt nie unieważnił· 5 min
- Przeglądarka w Cursorze uruchomiła kalkulator na polecenie strony. Raport EMBRACE pokazuje, jak to możliwe· 4 min
- Fałszywe rozszerzenie Claude Code w sklepie Cursora mogło trafić do 5 tysięcy osób· 4 min
- Podrobione rozszerzenie Claude Code w sklepie Cursora wpisywało klucz SSH napastnika· 4 min