Model / Badania
DeepSeek wygasza własnego flagowca, bo tańszy model wypada lepiej
DeepSeek od zeszłego poniedziałku przekierowuje ruch z flagowego V4-Pro na tańszy V4.1-Flash i rozlicza go po niższych stawkach, więc w konfiguracji masz jeden model, a odpowiada inny. Firma tłumaczy to wynikami: 90,6 punktu na Terminal-Bench 2.1, prawie dwa oczka przed GPT-5.6 Sol i trzy przed własnym V4-Pro, przy pamięci ściętej z 3514 do 890 bajtów na token. Przy agencie, który pracuje godzinami nad jednym zadaniem, to właśnie pamięć bywa największą pozycją rachunku, więc czterokrotna oszczędność waży więcej niż miejsce w rankingu. Tyle że tabelkę mierzył sprzedawca, a wyboru już nie ma.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Model / Badania · 3 min ·
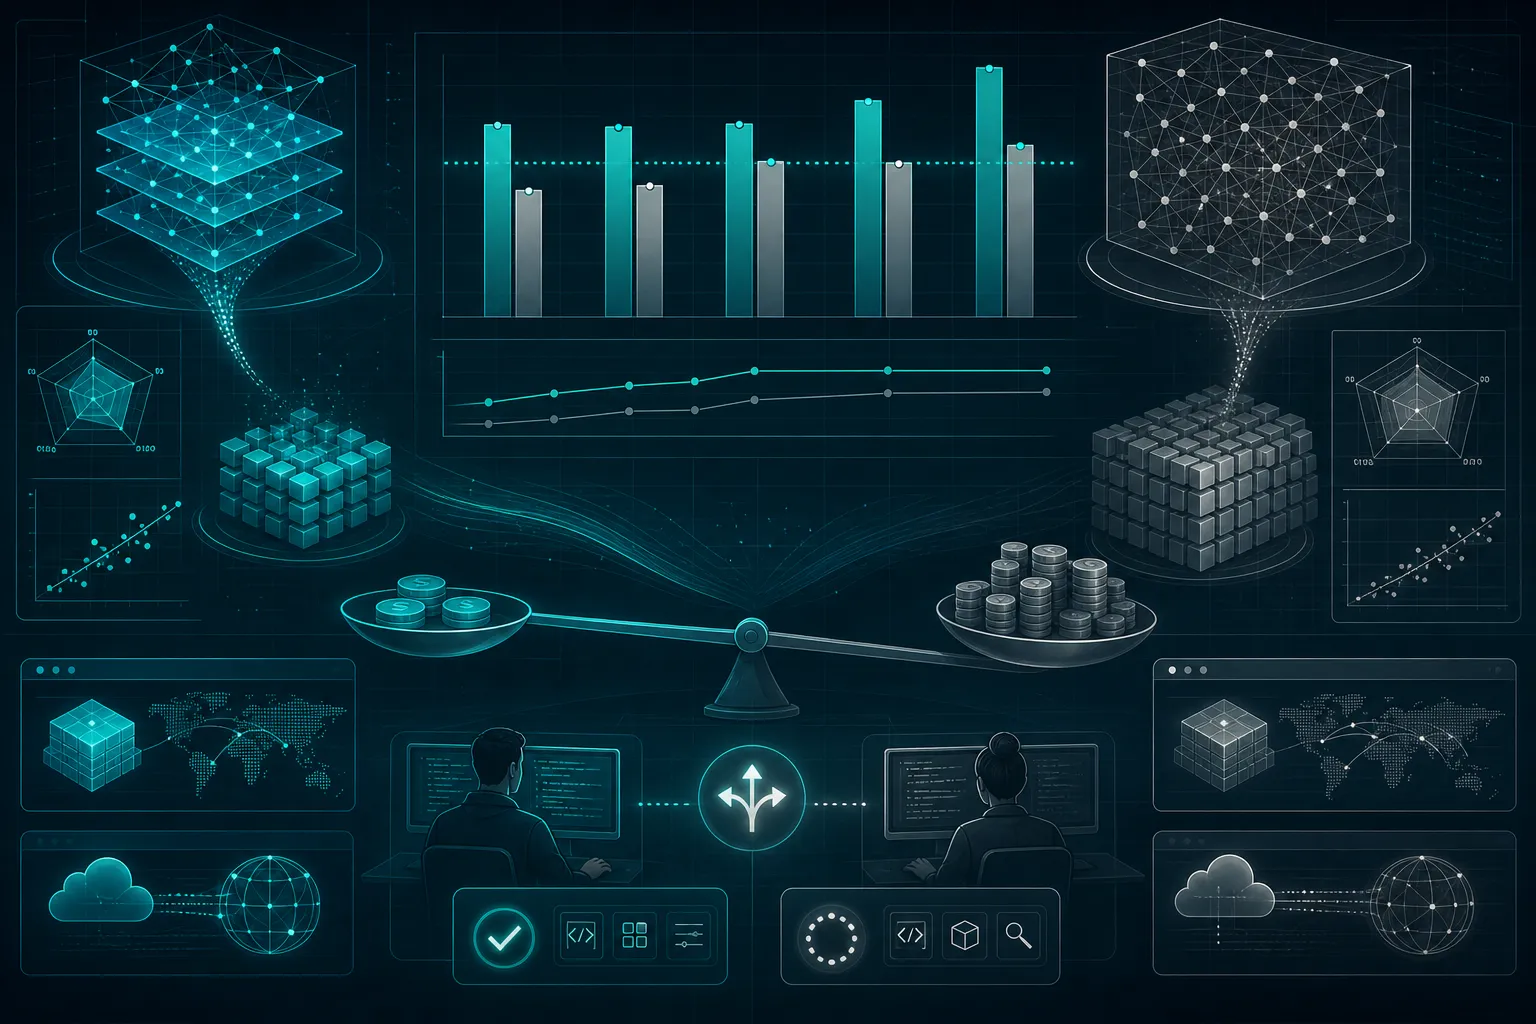
W zeszły poniedziałek o czwartej nad ranem czasu UTC zapytanie wysłane do deepseek-v4-pro przestało trafiać do V4-Pro. DeepSeek przekierował ruch swojego flagowego modelu na mniejszy i tańszy V4.1-Flash, a rozlicza ten ruch według stawek tego tańszego. Nic się przy tym nie psuje, żadnego błędu nie zobaczysz, po prostu od tego dnia odpowiada ci inny model, niż masz wpisany w konfiguracji.
Żeby zrozumieć, dlaczego to dziwne, trzeba wiedzieć, jak DeepSeek dzielił dotąd ofertę. V4-Pro był tym drogim i mocnym, po który sięgało się przy trudnych zadaniach, a linia Flash tą szybką i tanią, dobrą na całą resztę. W czwartek 10 września firma pokazała V4.1-Flash, ogłosiła, że tańsza linia wyprzedziła droższą we wszystkich mierzonych kategoriach, i na tej podstawie wygasza droższą, przynajmniej do premiery V4.1-Pro. Z tego ogłoszenia kupuję jedno: arytmetykę pamięci. Tabelkę z wynikami mierzył sprzedawca.
Najwięcej zmieniło się jednak w pamięci. Agent, który godzinę dłubie przy jednym zadaniu, przegląda pliki, odpala testy i czyta ich wyniki, musi to wszystko pamiętać, więc każdy przeczytany token zostaje w pamięci podręcznej modelu, nazywanej w branży cache KV. Ta pamięć rośnie razem z sesją i zajmuje najdroższe miejsce, jakie ma serwer, czyli RAM karty graficznej. V4.1-Flash potrzebuje na token 890 bajtów zamiast 3514 w poprzednim Flashu, co ścina zapotrzebowanie na pamięć karty do ćwiartki.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.