Model / Badania
Ile programowania zostaje w modelu po wycięciu połowy ekspertów?
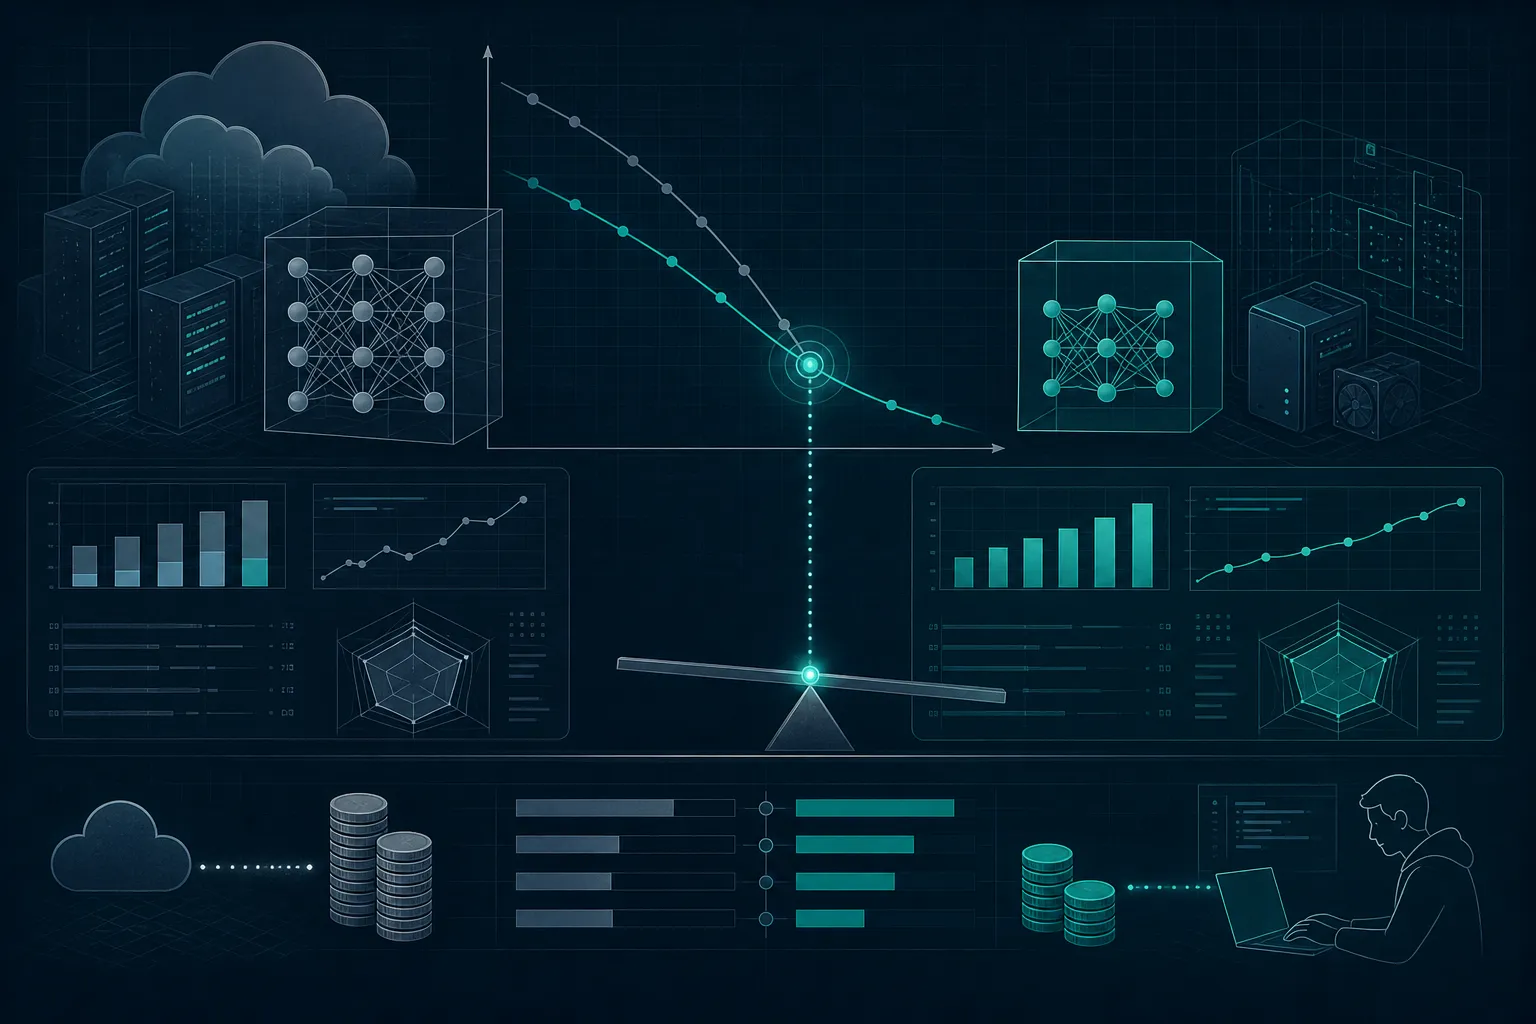
Zespół DASLab z ISTA wyciął z modelu Qwen3.8-Flash-Next od Alibaby 256 z 512 ekspertów w każdej warstwie, a resztę wag zapisał z dokładnością 3,5 bita, dzięki czemu wersja do programowania mieści się na jednej karcie z 32 GB zamiast 354 GB. Metoda RCO zachowuje tylko to, co było w próbce kalibracyjnej, przez co pierwsza wersja straciła widzenie, a testy kodu tego nie zauważyły. Na LiveCodeBench zostaje 98,7% wyniku, ale na SWE-bench Verified spadek z 82,8% do 75,6% pokazuje, że w pracy agenta cięcie kosztuje więcej.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Model / Badania · 4 min ·
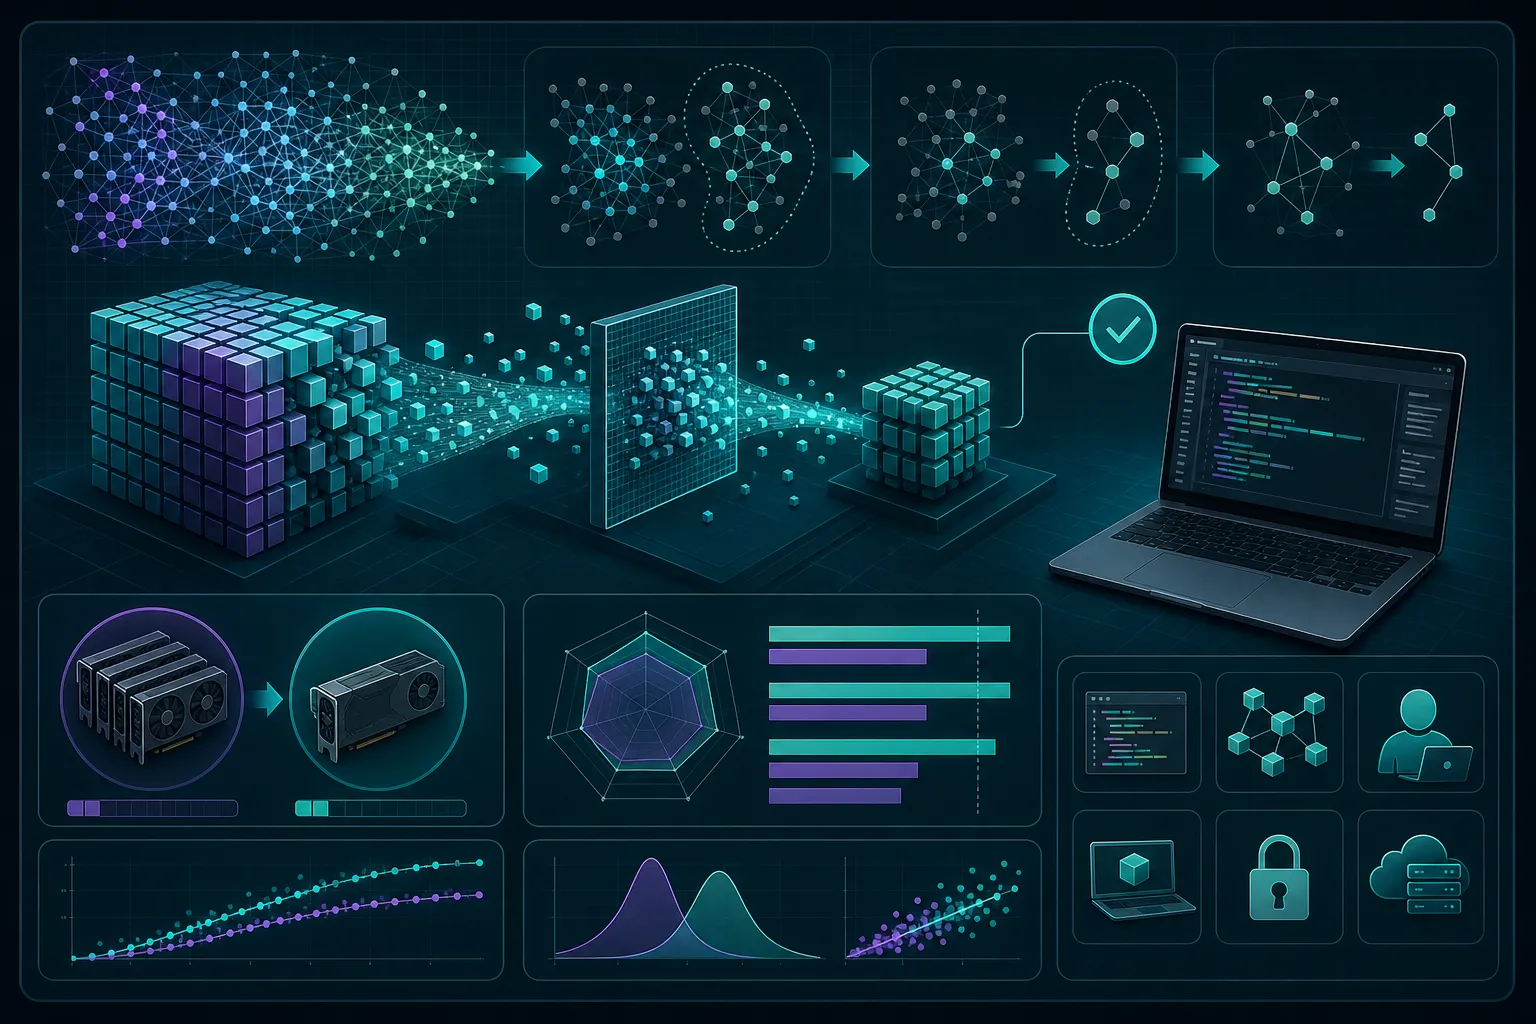
Qwen3.8-Flash-Next to model z rodziny Qwen od Alibaby, uniwersalny, bo oprócz tekstu rozumie też obrazy. Zapisany bez zaokrąglania liczb, z których się składa, waży 354 GB, więc kto chciałby go uruchomić u siebie, potrzebowałby kilku serwerowych kart graficznych. Zespół DASLab z Institute of Science and Technology Austria wrzucił na Hugging Face wersję tego modelu nastawioną na programowanie, która według autorów mieści się na jednym akceleratorze z 32 GB pamięci. Badacze nie osiągnęli tego samym ściskaniem liczb. Wycięli połowę modelu, tę, której ich zdaniem programista nie potrzebuje.
Ceną za zmieszczenie się na jednej karcie jest więc połowa modelu, a autorzy opisali tę wymianę wyjątkowo uczciwie, dlatego warto ją zrozumieć przed pobraniem. Dostajesz model, który zachował to, co kazano mu zachować, i nic więcej.
Pół modelu mniej
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.