SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Poradnik / Praktyka

Jak zmieścić dwa modele Llama 3.1 8B na jednym GPU H100

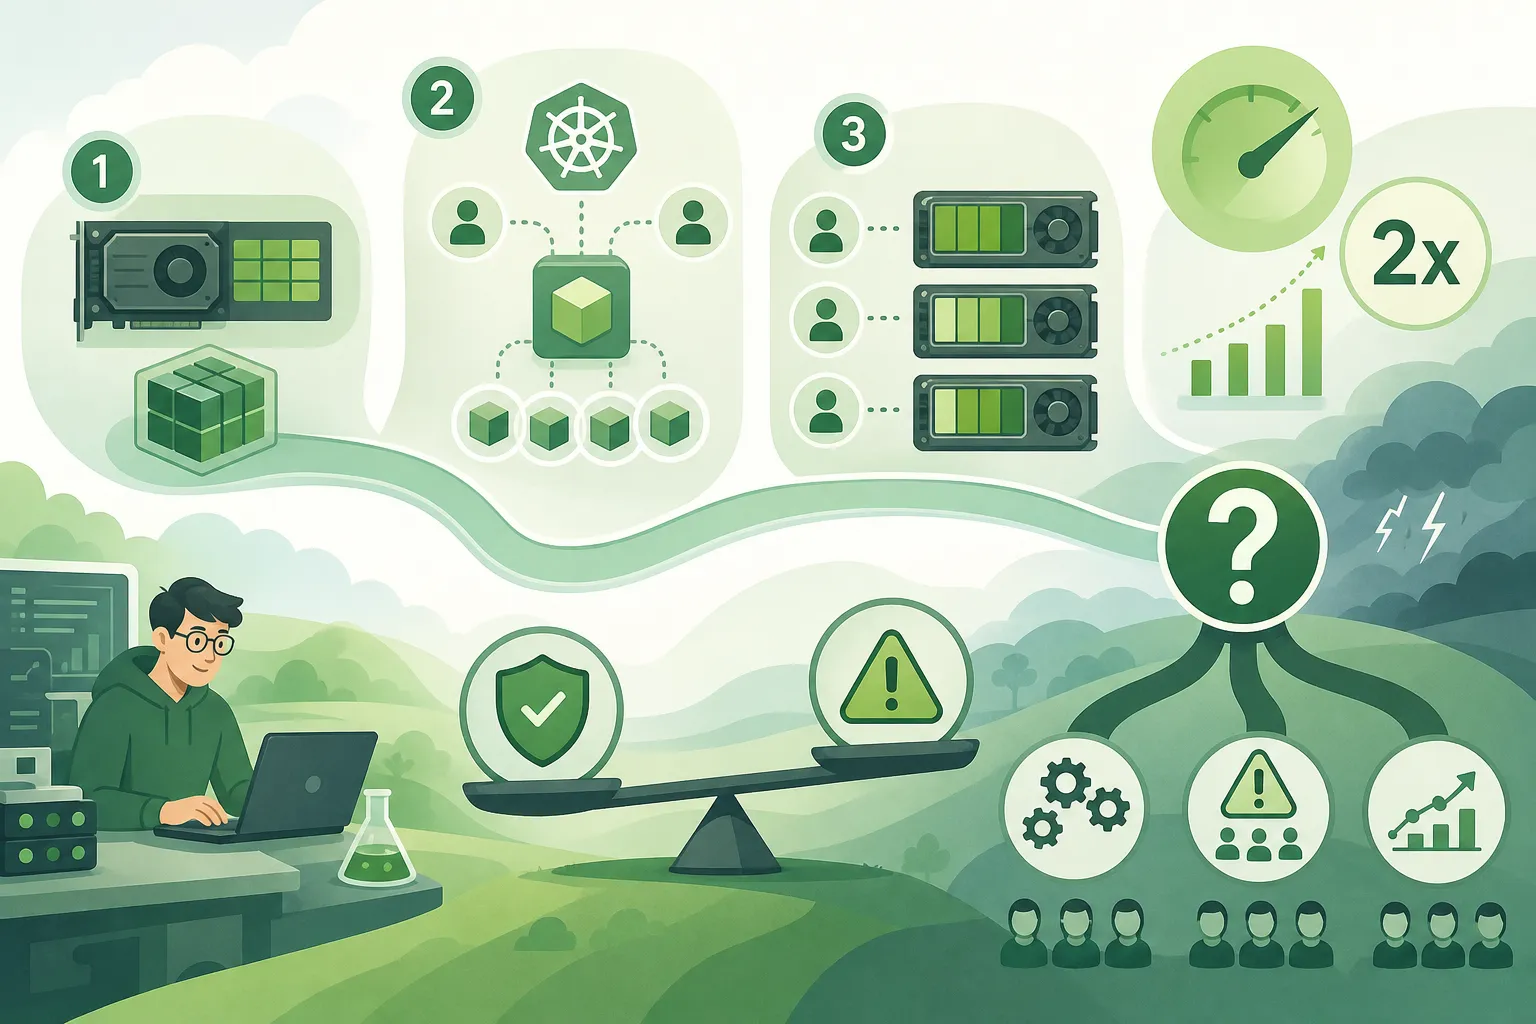
Red Hat pokazał, jak zmieścić dwa osobne modele Llama 3.1 8B, każdy zajmujący około 15 GB, na jednej karcie NVIDIA H100 z 80 GB pamięci, zamiast blokować dwie karty. Recepta łączy technologię NVIDIA MIG, która tnie układ na sprzętowo odizolowane wycinki po 40 GB, z mechanizmem Kubernetesa DRA, który zarządza nimi bez kolizji. To jednak dopiero laboratoryjne demo: funkcja jest w Kubernetesie 1.34 w fazie alpha, na OpenShifcie domyślnie ma wejść od wersji 5.0, a podwojenie działa tylko dla tej konkretnej pary model plus karta.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Poradnik / Praktyka  ·  4 min  · 
Jak zmieścić dwa modele Llama 3.1 8B na jednym GPU H100
Ilustrację przygotowała AI.

Pojedynczy model Llama 3.1 8B potrzebuje mniej więcej 15 GB pamięci na wagi i obliczenia. Karta NVIDIA H100 ma jej 80 GB. Mimo to w standardowym Kubernetesie taki model zajmuje całą kartę, bo planista traktuje GPU jako zasób niepodzielny: dostajesz jedną kartę albo nic. Reszta pamięci stoi pusta, rachunek za chmurę rośnie, a kolega czeka w kolejce, bo ktoś zablokował cały węzeł na lekki test.

Red Hat pokazał na swoim blogu dla deweloperów, jak zmieścić na tej jednej karcie dwie osobne usługi inferencyjne, każda z własnym modelem Llama 3.1 8B i twardą, sprzętową granicą między nimi. Recepta to połączenie dwóch rzeczy: technologii NVIDIA o nazwie MIG, która fizycznie tnie kartę na kawałki, oraz mechanizmu Kubernetesa zwanego dynamic resource allocation, w skrócie DRA, który tymi kawałkami zarządza. Na papierze wygląda to jak darmowe podwojenie mocy karty. Od razu jednak zaznaczę, bo jeszcze do tego wrócę: to wynik z demonstracji, z laboratoryjnie dobranej pary model plus karta, a nie gotowa recepta na produkcję.

Karta pocięta na sprzętowe wycinki

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Po co trzymać dwa modele naraz, skoro jeden potrafi podpowiadać sam sobie? Model / Badania

Po co trzymać dwa modele naraz, skoro jeden potrafi podpowiadać sam sobie?

4 min

NVIDIA pokazała Nemotron-Labs-Diffusion, model, w którym jeden zestaw wag pełni obie role znane z dekodowania spekulacyjnego: sam sobie podpowiada blok tokenów i sam je weryfikuje, dzięki czemu nie trzeba trzymać w pamięci drugiego, pomocniczego modelu. W teście SPEED-Bench przyjmował średnio 6,82 tokenu na krok wobec 2,75 u Eagle3, a wariant 8B dawał czterokrotnie wyższą przepustowość niż Qwen3-8B przy niemal niezmienionej jakości, 62,81% wobec 63,61%. To na razie preprint samej NVIDIA, bez recenzji, ale wagi w wersjach 3B, 8B i 14B leżą już na Hugging Face na licencji komercyjnej.

Model do RAG, który zmieści się na jednej karcie Model / Badania

Model do RAG, który zmieści się na jednej karcie

3 min

NVIDIA wypuściła 16 lipca Nemotron-3-Embed-1B, model osadzeń do RAG, którego atutem nie jest jakość, tylko rozmiar: 1,14 miliarda parametrów mieści się na jednej karcie GPU, więc cały etap wyszukiwania po dokumentach można trzymać u siebie, razem z danymi. Wersja ściśnięta do 4 bitów traci na benchmarku RTEB ledwie 0,38 punktu, a wektor da się obciąć z 2048 do 512 liczb, oszczędzając miejsce w bazie wektorowej. Wśród 34 przetestowanych języków nie ma jednak polskiego, więc jakość na polskich dokumentach trzeba sprawdzić samemu.

NVIDIA rozbija model na dwie części, żeby pisał tekst 2,42 raza szybciej Model / Badania

NVIDIA rozbija model na dwie części, żeby pisał tekst 2,42 raza szybciej

4 min

NVIDIA pokazała Nemotron-Labs-TwoTower, model, który generuje tekst całymi blokami po 16 słów naraz zamiast token po tokenie, dzięki czemu pisze 2,42 raza szybciej przy zachowaniu 98,7% jakości modelu bazowego. Sztuczka polega na rozbiciu sieci na dwie wieże: zamrożoną kontekstową i odszumiającą, która równolegle wypełnia puste miejsca. Płaci się za to drugą kartą GPU i spadkiem jakości tam, gdzie liczy się precyzja, bo na HumanEval wynik spada z 79,27 do 75,58. Prawdziwa wartość to nie sam model, ale recepta na przyspieszenie gotowych modeli autoregresyjnych bez trenowania od zera.