SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Mapa kodu, którą agent pyta, zamiast czytać repozytorium plik po pliku

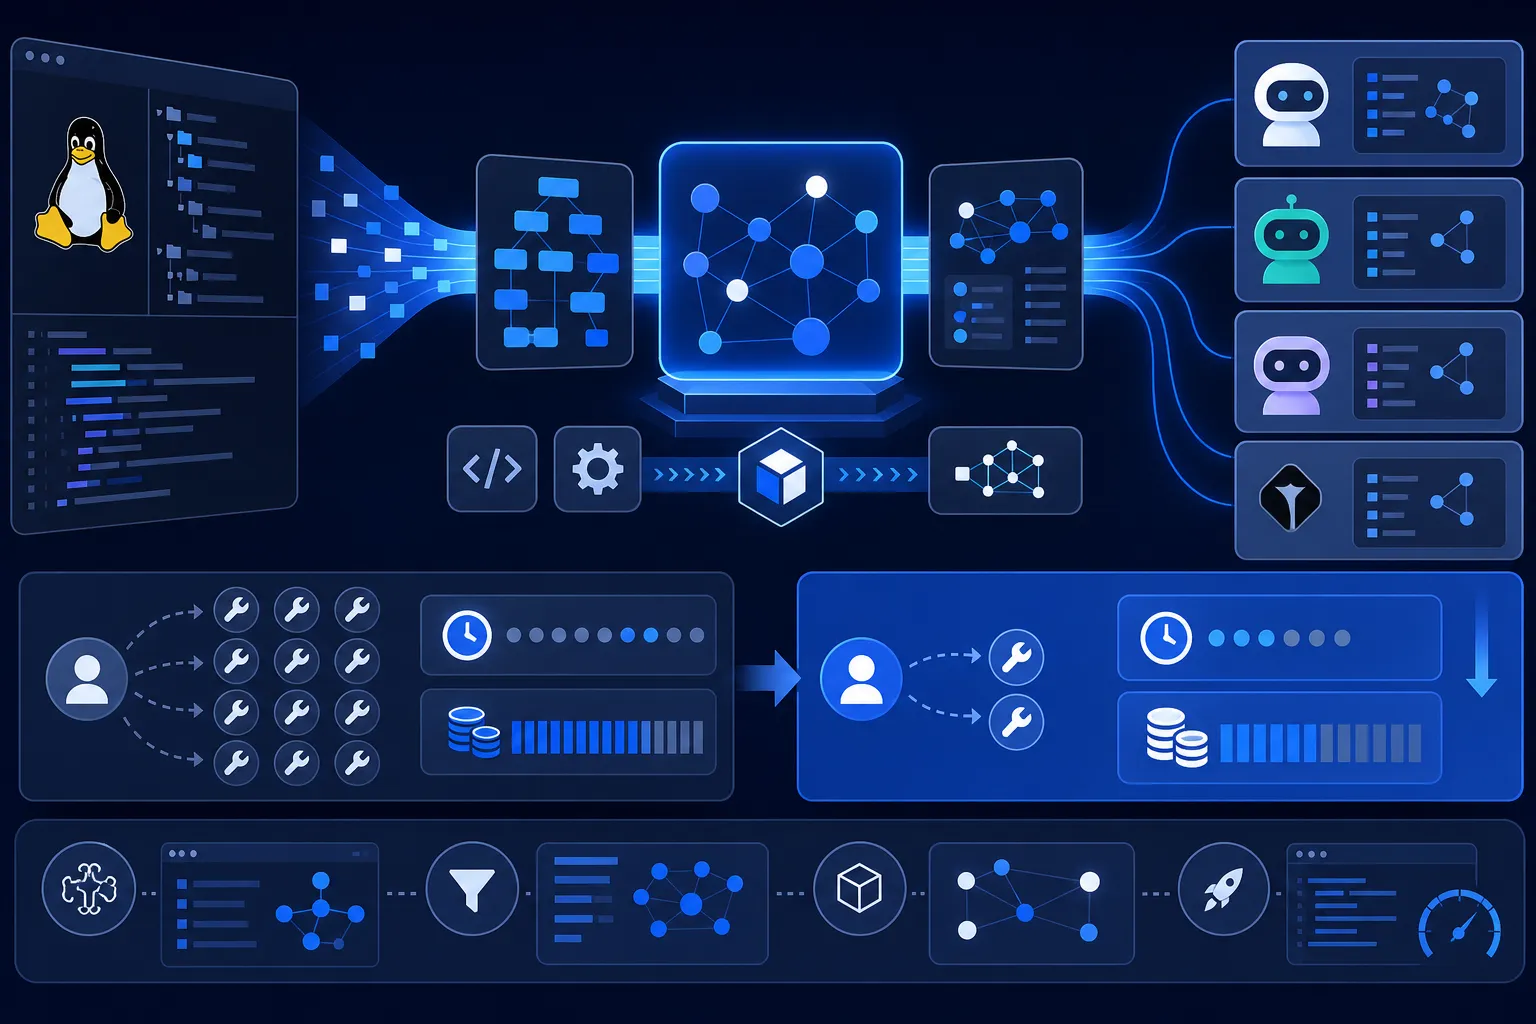
codebase-memory-mcp od DeusData raz indeksuje całe repozytorium w graf funkcji, klas i wywołań, dzięki czemu agent pyta gotową mapę, zamiast czytać plik po pliku i palić tokeny. Jądro Linuksa ogarnia w trzy minuty, a na zapytanie o strukturę odpowiada w niecałą milisekundę. Twórcy chwalą się oszczędnością do 99,2% tokenów w wybranym teście, ale ich preprint z 31 repozytoriów podaje skromniejsze 10× mniej tokenów i 2,1× mniej wywołań, a wszystkie te liczby pochodzą od nich i nikt ich jeszcze nie zrecenzował.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
Mapa kodu, którą agent pyta, zamiast czytać repozytorium plik po pliku
Ilustrację przygotowała AI.

Kiedy agent do kodu ma odpowiedzieć na pytanie "co wywołuje tę funkcję" w dużym repozytorium, robi to mniej więcej tak jak czytelnik szukający jednego zdania w książce bez indeksu: otwiera plik, przeszukuje go pod kątem nazwy, otwiera następny i tak w kółko. Każde takie zajrzenie to osobne wywołanie narzędzia i kolejna porcja tokenów wrzucona do kontekstu. Przy kilku plikach to nie ma znaczenia. Przy jądrze Linuksa, które ma 28 milionów linii kodu w 75 tysiącach plików, agent gubi się, zanim zdąży cokolwiek zrozumieć.

codebase-memory-mcp, wydany przez DeusData, próbuje ten problem obejść od innej strony. Zamiast pozwalać agentowi błądzić plik po pliku, raz indeksuje całe repozytorium w graf: mapę funkcji, klas i tego, co kogo wywołuje. Potem agent, zamiast czytać dziesiątki plików, zadaje jedno pytanie do tej mapy. Jądro Linuksa narzędzie indeksuje w trzy minuty, a na zapytanie o strukturę odpowiada w niecałą milisekundę.

MCP pozwala agentowi wołać zewnętrzne narzędzia po jednym protokole, który Anthropic otworzył pod koniec 2024 roku, i na nim to wszystko stoi. codebase-memory-mcp jest właśnie takim narzędziem: sam nie ma w sobie modelu, tylko buduje i przeszukuje graf, a inteligencję dokłada agent, z którym już rozmawiasz. Podpina się pod Claude Code, Codex CLI, Gemini CLI i osiem innych jednym poleceniem instalacji.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Jeden plik Pythona zamiast bazy wektorowej: mind próbuje dać agentom pamięć Premiera / Narzędzie

Jeden plik Pythona zamiast bazy wektorowej: mind próbuje dać agentom pamięć

4 min

mind, jednoplikowe narzędzie Da7-Tech, próbuje dać agentom do kodu pamięć między sesjami bez embeddingów, bazy wektorowej czy zapytań do LLM: opiera się na wyszukiwaniu leksykalnym, grafie pojęć i ręcznym słowniku 83 mapowań, a nieużywane fakty gasną według krzywej Ebbinghausa. Autor podaje recall@1 równy 1,00 przy medianie 2,9 ms na grafie 1000 węzłów, choć sam przyznaje, że to tylko 20 zapytań na sztucznych danych. Największe pytanie nie dotyczy algorytmu, lecz tego, czy agent w ogóle zechce sięgnąć do pamięci wszytej w pliki CLAUDE.md i AGENTS.md.

Repozytorium z 286 umiejętnościami radzi włączyć tylko garstkę Premiera / Narzędzie

Repozytorium z 286 umiejętnościami radzi włączyć tylko garstkę

5 min

Repozytorium ECC wystawia na licencji MIT 286 gotowych umiejętności dla agenta, ale jego własny README radzi trzymać się poniżej 10 serwerów MCP i 80 narzędzi, bo po włączeniu wszystkiego z okna na 200 tysięcy tokenów zostaje około 70 tysięcy na kod i rozmowę. Do tego lutowy audyt blisko 4 tysięcy publicznych umiejętności znalazł lukę w 36% z nich, część ze wstrzykniętymi instrukcjami dla modelu. Więcej daje więc własny zestaw testów, jak ten z bloga Agentailor za 0,42 dolara za przebieg, który po każdej zmianie mówi, czy agent nadal zatrzymuje się przed nieodwracalną akcją.

Ponad 20% drożej i ani jednego zadania więcej Analiza / Opinia

Ponad 20% drożej i ani jednego zadania więcej

3 min

Zespół z laboratorium SRI na ETH w Zurychu sprawdził, czy pliki kontekstowe w repozytorium, jak AGENTS.md, realnie pomagają agentom do programowania, i wyszło, że nie: skuteczność mierzona odsetkiem ukończonych zadań ani drgnęła, a rachunek za pracę agenta urósł o ponad 20%. Wynik trzyma się także wtedy, gdy kontekst pisali ręcznie sami deweloperzy, nie tylko model. Pliki zmieniają zachowanie agenta: więcej testuje i dokładniej przegląda repozytorium, co spala tokeny, ale nie zamyka więcej zgłoszeń. Autorzy nie każą wyrzucać AGENTS.md, tylko skrócić go do rzeczy, których agent sam nie zgadnie.