SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Model / Badania

Model mieści się na laptopie, ale nie uruchomisz go na zwykłym llama.cpp

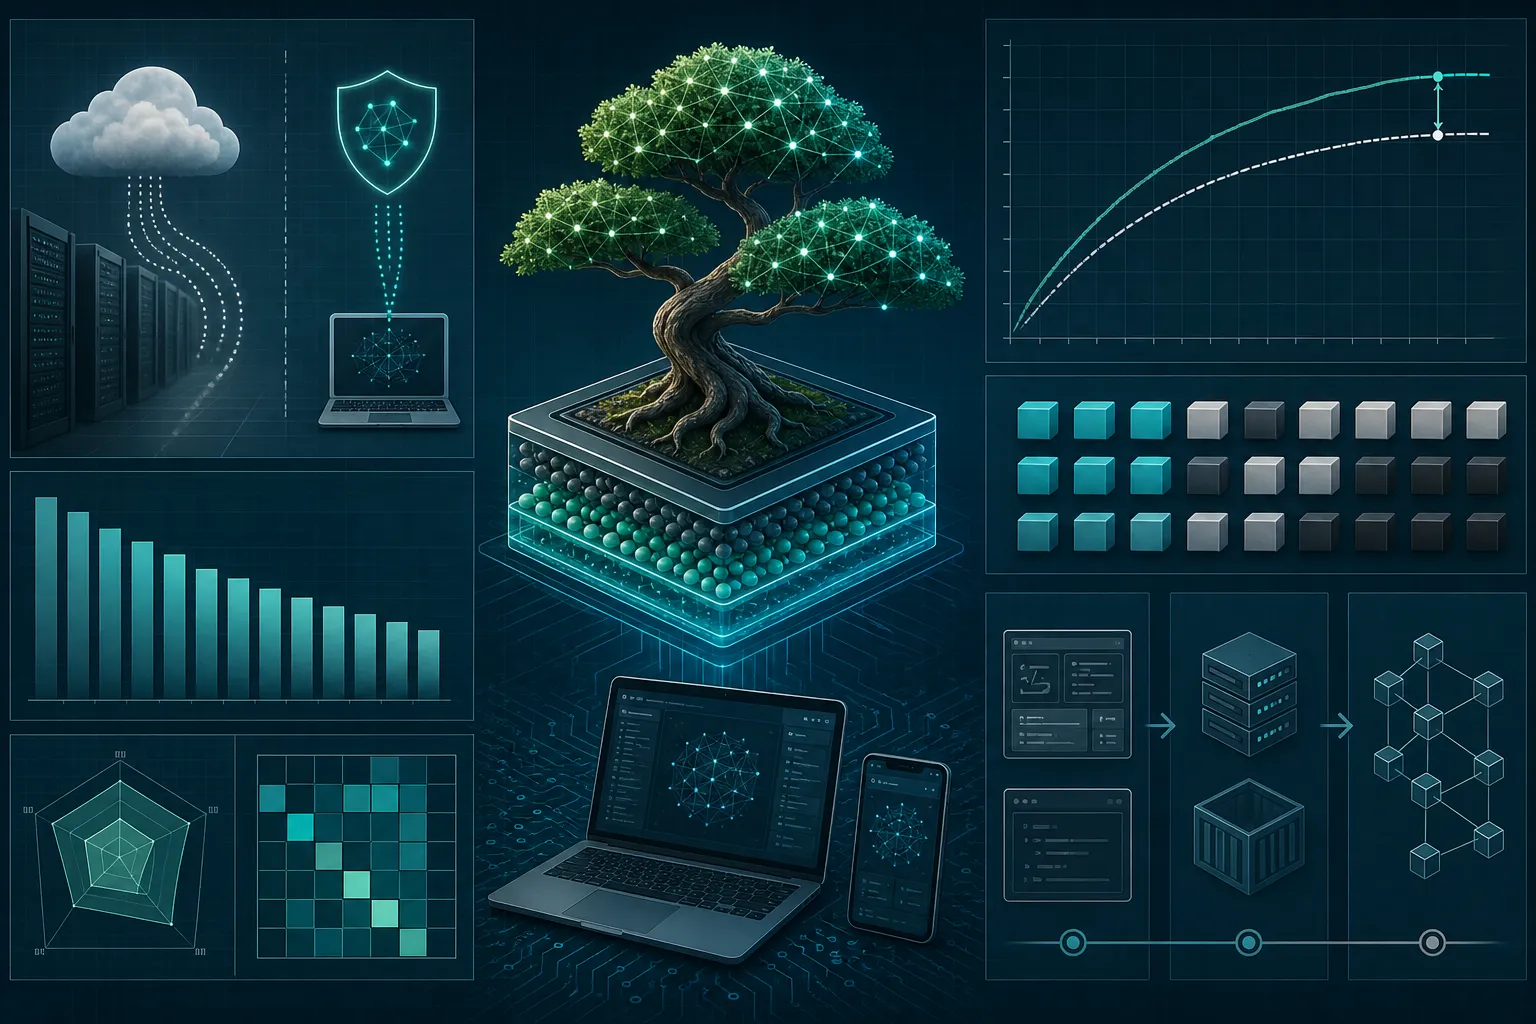
PrismML wypuścił 17 września Bonsai 2 27B, czyli model Alibaby ściśnięty do 5,9 GB z deklarowaną stratą 1,8% na benchmarkach, bo każda waga przyjmuje w nim już tylko trzy wartości zamiast szesnastobitowej liczby. Brakujący punkt procentowy jest tu najmniej ciekawy: prawdziwą przeszkodą jest to, że główna gałąź llama.cpp tego formatu nie obsługuje, więc do czasu przyjęcia poprawki trzeba korzystać z forka PrismML. Domyślna instalacja waży zresztą 7,8 GB razem z modułem do obrazów, a długa rozmowa w oknie 256 tysięcy tokenów potrafi zająć w pamięci więcej miejsca niż sam model.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Model / Badania  ·  3 min  · 
Model mieści się na laptopie, ale nie uruchomisz go na zwykłym llama.cpp
Ilustrację przygotowała AI.

Tydzień temu pisałem, ile pamięci naprawdę potrzebuje Qwen3.8 27B: pełny model waży prawie 48 GB, po ścięciu wag do czterech bitów schodzi do niespełna 16 GB i dopiero wtedy mieści się na domowej karcie. PrismML wypuścił 17 września Bonsai 2 27B, tę samą sieć Alibaby upakowaną w 5,9 GB, z deklarowaną stratą 1,8% na zbiorczym wyniku benchmarków. Liczba, którą wszyscy będą cytować, to te 98,2%. Nie ona jednak zdecyduje o tym, czy ktokolwiek uruchomi ten model u siebie.

Do tych 5,9 GB trzeba dopisać gwiazdkę. Domyślnie skrypt instalacyjny ściąga cięższe upakowanie, 7,8 GB razem z modułem do obrazów, bo szybciej przetwarza prompt. Kontekst to osobny rachunek: okno sięga 256 tysięcy tokenów, ale długa rozmowa potrafi zająć w pamięci więcej miejsca niż sam model, więc obietnica o laptopie dotyczy modelu, nie całej sesji.

Plik chudnie mniej więcej dziewięciokrotnie, bo PrismML pozwala każdej wadze przyjąć już tylko trzy wartości: plus jeden, minus jeden albo zero, zamiast szesnastobitowej liczby, jaką sieć zapamiętała podczas trenowania. Reszta precyzji znika, a model dalej rozwiązuje zadania matematyczne z dokładnością do pół punktu względem pełnej precyzji i pisze kod na poziomie oryginału.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Silnik w jednym pliku C uruchamia 744-miliardowy model bez GPU Premiera / Narzędzie

Silnik w jednym pliku C uruchamia 744-miliardowy model bez GPU

3 min

Colibrì, jednoosobowy projekt open-source w jednym pliku C, uruchamia GLM-5.2 z 744 miliardami parametrów na zwykłym laptopie z 25 GB RAM, bez karty graficznej. Dzięki mieszance ekspertów silnik trzyma gęsty rdzeń w pamięci, a wyspecjalizowanych ekspertów podczytuje z dysku dopiero na żądanie. Ceną jest prędkość: od 0,05 do 0,1 tokena na sekundę na skromnym sprzęcie, choć na MacBooku M5 Max dochodzi do około 1 tokena. Pierwszy pomiar na skwantyzowanych do czterech bitów wagach dał 62,5%, a całość pokazuje, że sprzętowa ściana wokół modeli klasy frontier to kwestia inżynierii, nie prawo fizyki.

Liquid AI zmieścił agenta w 2,5 GB i puścił go bez chmury Model / Badania

Liquid AI zmieścił agenta w 2,5 GB i puścił go bez chmury

4 min

Liquid AI wypuściło 4 sierpnia LFM2.5-2.6B, model o 2,6 miliarda parametrów, który mieści się w niecałych 2,5 GB i działa lokalnie na laptopie, telefonie czy Raspberry Pi, bez ani jednego zapytania do chmury. Kluczowa jest metoda: model dotrenowano wprost w harnessie agenta i nagradzano za faktyczny wynik, dzięki czemu na teście ToolSandbox wyprzedził trzykrotnie większego Qwen3.5-9B, choć na BFCLv4 już przegrywa. Skoro nie płacisz za tokeny do API, każde uruchomienie kosztuje zero, a firma otwarcie przyznaje, że do trudniejszych zadań programistycznych lepszy bywa większy model.

Dziesięć awarii między działającym modelem a czystym bełkotem Poradnik / Praktyka

Dziesięć awarii między działającym modelem a czystym bełkotem

4 min

Deweloper tonyd2wild uruchomił GLM-5.2, otwarty model o 753 miliardach parametrów, na dwóch biurkowych DGX Spark, osiągając około 15 tokenów na sekundę. Zmieściło się to dzięki architekturze mixture-of-experts i kwantyzacji ekspertów do 2 bitów, kosztem jakości odpowiedzi. Sednem nie są jednak liczby, tylko lista 10 awarii dzielących "teoretycznie się da" od "faktycznie działa": różne nazwy użytkowników rozbiły ścieżkę do biblioteki NCCL, a brakujący plik z wagami sprawił, że model wstawał czysto i wypluwał bełkot. Główny wniosek: "wstało bez błędów" nie znaczy "działa poprawnie".