Model / Badania
Opus 5.5 domyślnym modelem Anthropica, Fable 5.1 dwa i pół raza droższy
Anthropic ustawił Claude Opus 5.5 jako domyślny model, a po Fable 5.1 radzi sięgać dopiero wtedy, gdy Opus zawodzi nawet na wyższym poziomie wysiłku. Różnica w cenie jest duża: Opus kosztuje 4 i 20 dolarów za milion tokenów wejścia i wyjścia, Fable 10 i 50, więc zadanie agenta, które na Opusie kosztuje 12 dolarów, na Fable kosztuje 30. Kto buduje aplikację na API, musi też czytać flagi z Models API, bo na przykład Sonnet 5.5 nie pozwala całkiem wyłączyć myślenia i odpowie błędem 400.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Model / Badania · 4 min ·
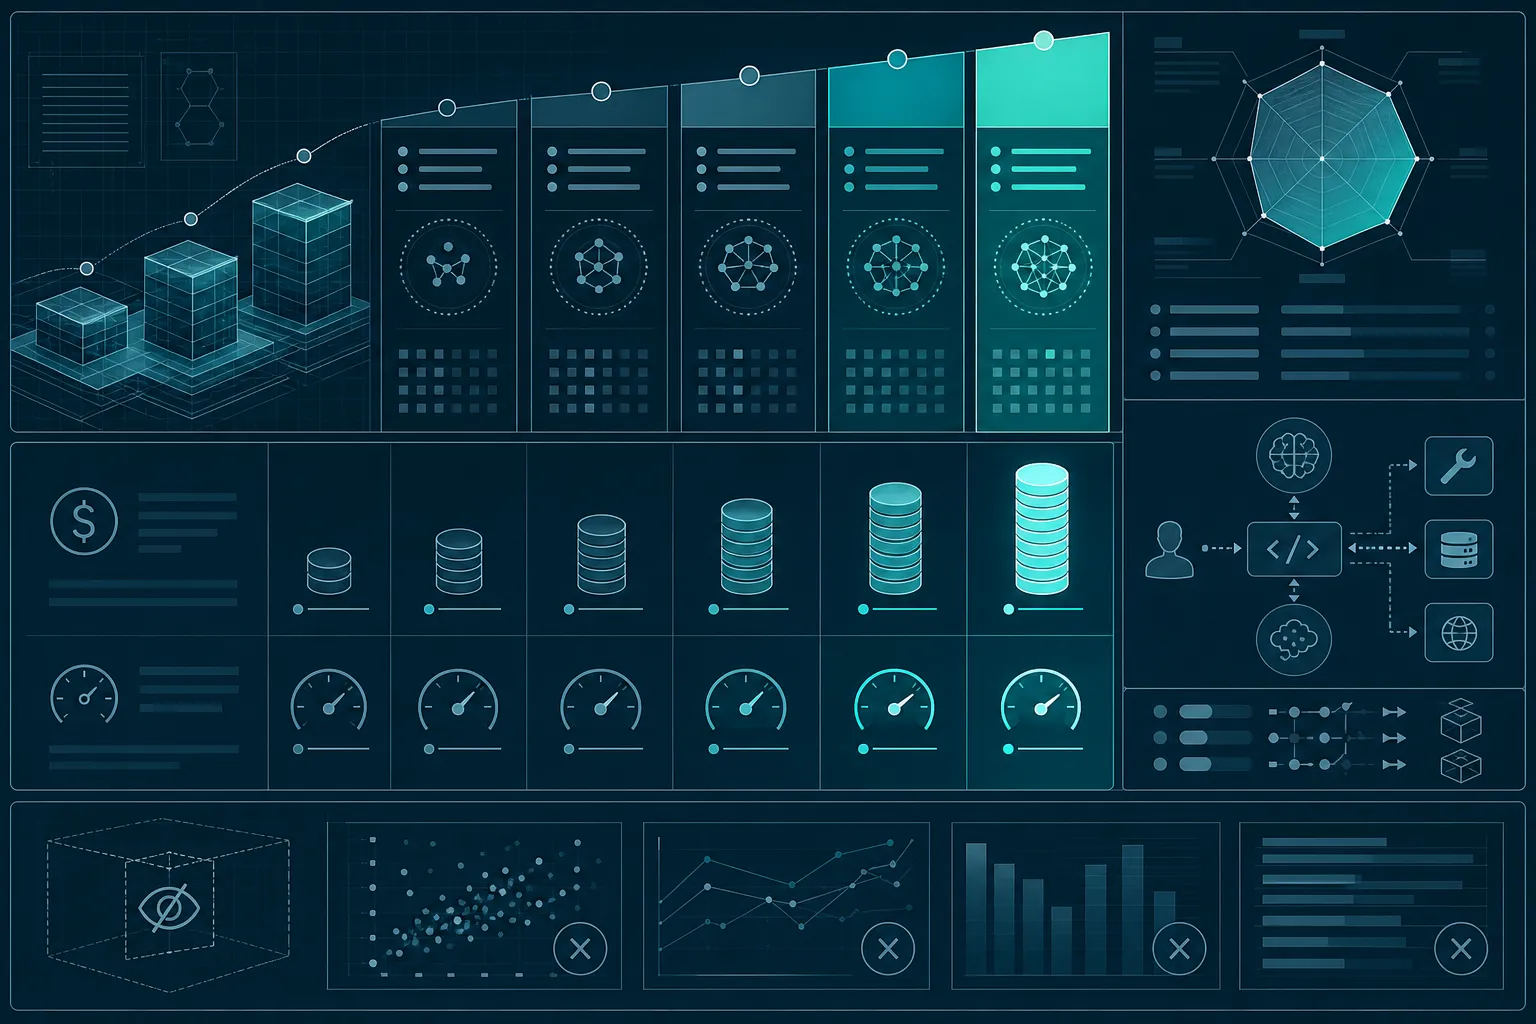
Anthropic zmienił odpowiedź na pytanie, od którego modelu zacząć. W przeglądzie modeli w dokumentacji platformy Claude domyślnym wyborem jest teraz Claude Opus 5.5. Po Claude Fable 5.1, droższy model, firma radzi sięgać przy najtrudniejszym rozumowaniu i długiej pracy agentów albo wtedy, gdy wasze własne testy na Opusie, nawet ustawionym na większy wysiłek, nadal wypadają za słabo. Benchmarków na tej stronie nie ma ani jednego, więc czytam ją jak cennik z instrukcją obsługi, nie jak dowód, że któryś model lepiej pisze kod.
Ile kosztuje zadanie na Opusie 5.5, a ile na Fable 5.1
Anthropic przeznacza Opusa 5.5 do długich, samodzielnych zadań programistycznych. Model liczy tekst w tokenach, czyli małych kawałkach słów, i to za nie płacicie: na Opusie 4 dolary za milion tokenów wejścia i 20 dolarów za milion tokenów wyjścia. Fable 5.1, przeznaczony do najtrudniejszego rozumowania i wielodniowej pracy agentów, kosztuje 10 i 50 dolarów, czyli dwa i pół raza więcej, a do tego tabela oznacza go jako wolniejszy. Niżej stoją jeszcze Sonnet 5.5 za połowę ceny Opusa i najtańszy Haiku 5.5 do klasyfikacji i kierowania zapytań.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.