SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Model / Badania

Otwarty model decyzyjny na Macu, prawie tak celny jak zamknięty Jev

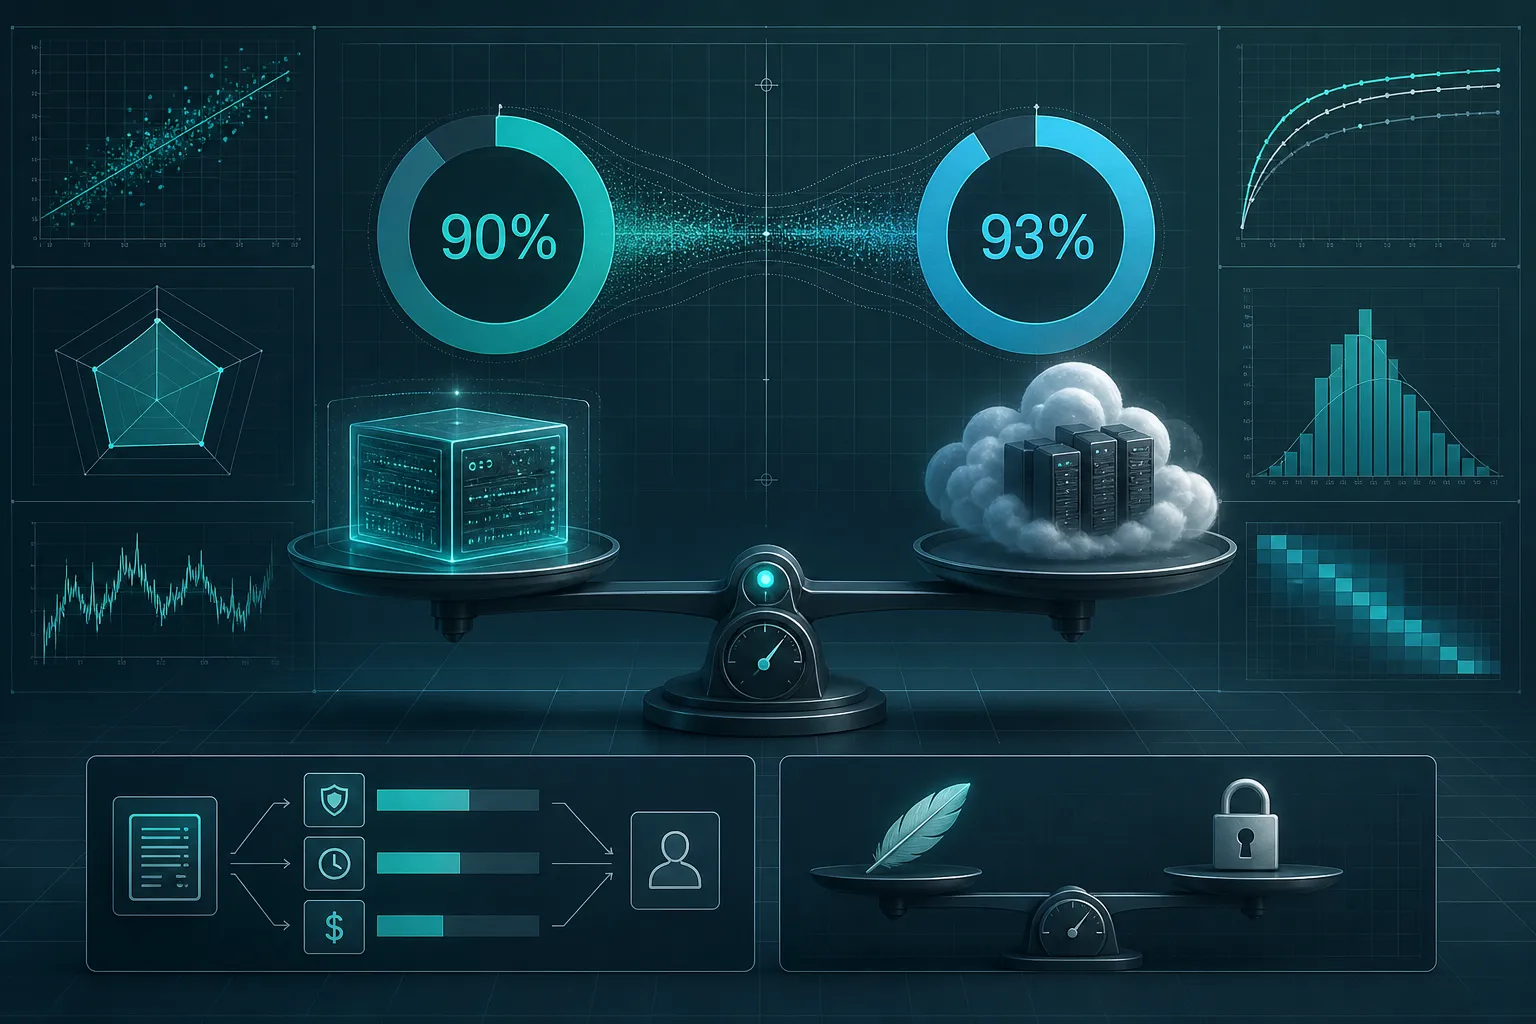
Bespoke Labs wydało Nimble, otwarty model zbudowany na Qwen3.5-9B, który wybiera odpowiedź z listy opcji lokalnie, na Macu albo karcie NVIDIA, więc nie trzeba parsować JSON-a zwróconego przez API. Na 324 przykładach testowych zgodził się z etykietami w 90,1% przypadków, a zamknięty Jev firmy TypeSafe w 93,2%, tyle że etykiety są syntetyczne, a test wąski. Do wstępnej klasyfikacji zgłoszeń to rozsądny wybór, ale przy decyzjach o pieniądzach lepiej najpierw sprawdzić go na własnych danych, bo bywa zbyt pewny siebie.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Model / Badania  ·  4 min  · 
Otwarty model decyzyjny na Macu, prawie tak celny jak zamknięty Jev
Ilustrację przygotowała AI.

Weźmy zgłoszenie, które trafia do systemu obsługi klienta: "Usługa płatności nie działa u żadnego klienta". Aplikacja musi szybko zdecydować, czy to sprawa pilna i czy ktoś z zespołu powinien ją przejrzeć. Zwykle wysyłamy taki tekst do dużego modelu przez API, prosimy o odpowiedź w JSON-ie i piszemy kod, który ją parsuje, licząc, że pole z priorytetem nie wróci w formie, której nikt nie przewidział. Bespoke Labs, firma, która wcześniej wydała mały model do sprawdzania, czy twierdzenie wynika z tekstu, opublikowała Nimble: otwarty model, który podejmuje takie decyzje lokalnie, na Macu z procesorem Apple albo na karcie NVIDIA.

Punktem odniesienia jest Jev, zamknięty model firmy TypeSafe, dostępny tylko przez API i zbudowany właśnie do takich decyzji: tak jak Nimble, od razu wybiera odpowiedź z listy i nie rozpisuje przy tym rozumowania. Autorzy Nimble podkreślają, że nie uczyli swojego modelu na odpowiedziach Jeva, i zamiast tego pokazują, jak samodzielnie zbudować dane, wytrenować model i uruchomić coś podobnego. Moim zdaniem to jest najcenniejsza część tej publikacji, bo sam wynik pochodzi z testu, który autorzy nazywają wąskim.

Odpowiedź bez jednego wygenerowanego słowa

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Kev: model decyzyjny w stylu Jev, który postawisz na własnym serwerze Premiera / Narzędzie

Kev: model decyzyjny w stylu Jev, który postawisz na własnym serwerze

4 min

Jared Palmer, pracując z agentem Devin, odtworzył w otwartym projekcie Kev model decyzyjny w stylu płatnego Jev od TypeSafe, który zamiast akapitu tekstu zwraca prawdopodobieństwa dla pytań typu tak lub nie albo wyboru z listy. Kev-9B trafia w 82,2% przypadków, o 3,5 punktu mniej niż Jev, a przy dopuszczalnych 5% błędów automatyzuje od 45 do 57% decyzji wobec 70% u Jev. Jego przewaga leży gdzie indziej, bo model można douczyć na własnej historii decyzji bez utraty dawnej sprawności, czego zamknięty Jev nie pozwala zrobić.

Po co trzymać dwa modele naraz, skoro jeden potrafi podpowiadać sam sobie? Model / Badania

Po co trzymać dwa modele naraz, skoro jeden potrafi podpowiadać sam sobie?

4 min

NVIDIA pokazała Nemotron-Labs-Diffusion, model, w którym jeden zestaw wag pełni obie role znane z dekodowania spekulacyjnego: sam sobie podpowiada blok tokenów i sam je weryfikuje, dzięki czemu nie trzeba trzymać w pamięci drugiego, pomocniczego modelu. W teście SPEED-Bench przyjmował średnio 6,82 tokenu na krok wobec 2,75 u Eagle3, a wariant 8B dawał czterokrotnie wyższą przepustowość niż Qwen3-8B przy niemal niezmienionej jakości, 62,81% wobec 63,61%. To na razie preprint samej NVIDIA, bez recenzji, ale wagi w wersjach 3B, 8B i 14B leżą już na Hugging Face na licencji komercyjnej.

Otwarte modele kodują już jak zamknięte. Zatrzymuje je droga na produkcję. Analiza / Opinia

Otwarte modele kodują już jak zamknięte. Zatrzymuje je droga na produkcję.

4 min

Doroczny raport Mozilli o otwartym AI pokazuje, że różnica w jakości między najlepszymi otwartymi a zamkniętymi modelami skurczyła się średnio do 3,3%, a na samym kodowaniu modele się zrównały. Cała gra przenosi się teraz do harnessu, czyli warstwy dookoła modelu: na Terminal-Benchu te same wagi Anthropica dawały 79,8% z niezależnym harnessem i tylko 58% w firmowym Claude Code. Otwarte wagi tną też koszty, bo Stripe przeniósł 50 milionów dziennych wywołań na własną infrastrukturę i ściął rachunek o 73%.