SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Ręczny bufor promptu w GPT-5.6: kiedy naprawdę tnie rachunek?

GPT-5.6 trafił do ogólnej dostępności na Amazon Bedrock, a AWS dołożył ręczne sterowanie buforem promptu: sam wyznaczasz koniec powtarzalnego prefiksu, który potem czytasz z pamięci o 90% taniej przez 30 minut. Nowość ma drugą stronę, bo zapis do bufora, dotąd darmowy na GPT-5.5 i 5.4, kosztuje teraz 1,25 raza więcej niż zwykły token wejściowy, więc realnie oszczędzasz dopiero, gdy odczyty stanowią około 20% ruchu. To wygrana dla pętli agenta, gdzie ten sam prompt systemowy wraca dziesiątki razy, a przy pojedynczych zapytaniach najwięcej zyskujesz, zostając przy trybie automatycznym.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
Ręczny bufor promptu w GPT-5.6: kiedy naprawdę tnie rachunek?
Ilustrację przygotowała AI.

Buforowanie promptu na Amazon Bedrock działało do tej pory samo z siebie i nic nie kosztowało. Wraz z premierą modeli OpenAI GPT-5.6 (Sol, Terra i Luna), które trafiły właśnie do ogólnej dostępności na Bedrocku, AWS dołożył do tego mechanizmu ręczne sterowanie i przy okazji zmienił rachunek. To dobra wiadomość dla jednego konkretnego wzorca pracy i właściwie obojętna dla całej reszty.

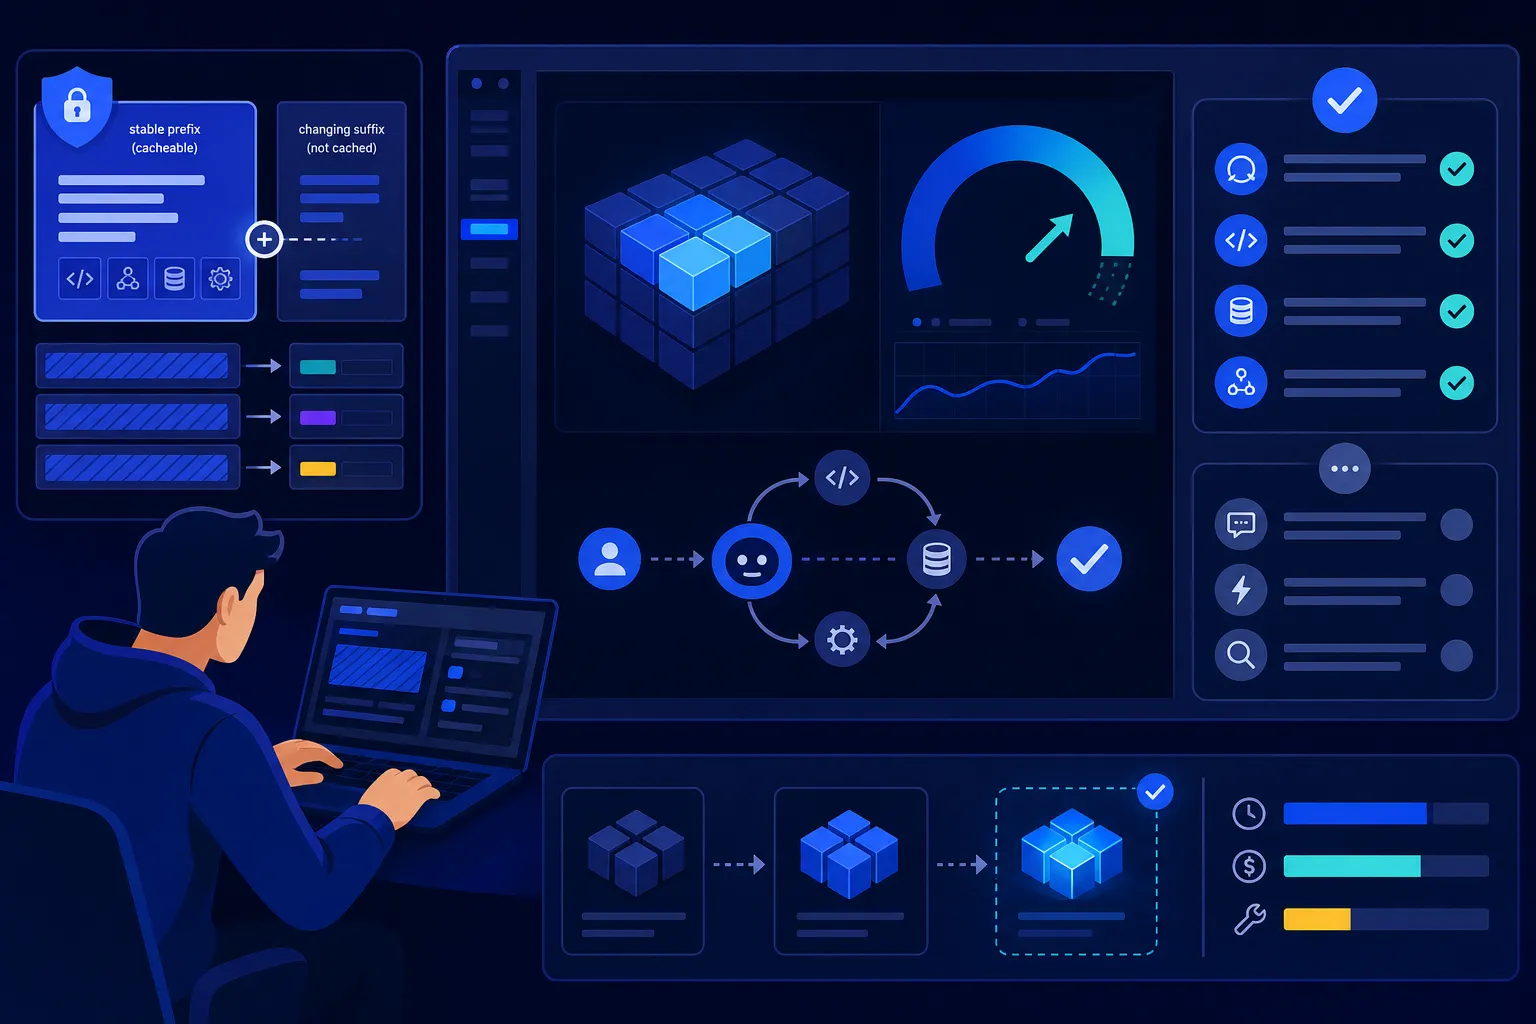
Zacznę od tego, co buforowanie w ogóle daje. Przy każdym wywołaniu model przetwarza cały prompt od nowa, a ty płacisz za każdy token, nawet jeśli połowa z nich to te same instrukcje systemowe i definicje narzędzi wysyłane w kółko przy każdym zapytaniu. Bufor zapamiętuje raz policzony fragment i przy kolejnym wywołaniu czyta go z pamięci, zamiast liczyć drugi raz. Na GPT-5.6 token odczytany z bufora kosztuje 90% mniej niż zwykły token wejściowy (stawki są na stronie z cennikiem Bedrocka), a zapamiętany fragment zostaje dostępny przez 30 minut.

Nowość polega na tym, że teraz sam wskazujesz, gdzie kończy się powtarzalna część promptu. Służy do tego parametr prompt_cache_breakpoint: wszystko przed tą granicą i razem z nią ląduje w buforze, a wszystko po niej może zmieniać się przy każdym zapytaniu. Drugi parametr, prompt_cache_key, to stały identyfikator, który kieruje kolejne zapytania do tego samego bufora. Prefiks musi mieć co najmniej 1024 tokeny i w jednym zapytaniu możesz postawić do czterech takich granic.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Sześć razy drożej za szybsze tokeny: komu opłaca się Astra Ultrafast
Model / Badania

Sześć razy drożej za szybsze tokeny: komu opłaca się Astra Ultrafast

4 min

OpenAI dało GPT-6 Astrze tryb Ultrafast, który dzięki kartom Nvidia Blackwell generuje tokeny do ośmiu razy szybciej, ale kosztuje sześć razy więcej: 300 zamiast 50 dolarów za milion tokenów wyjścia. Przyspiesza jednak tylko samo pisanie, a agent programistyczny większość czasu czeka na testy, CI i człowieka, więc dopłata ma sens głównie przy awarii albo sesji na żywo. Rozsądniejszą drogą jest GPT-6.1 Sol w tym samym trybie, pięć razy tańszy i z przetwarzaniem danych w UE, którego Astra Ultrafast nie oferuje.

OpenAI od GPT-5.6 liczy zapis do cache drożej, a odczyt dziesięć razy taniej
Model / Badania

OpenAI od GPT-5.6 liczy zapis do cache drożej, a odczyt dziesięć razy taniej

4 min

Od GPT-5.6 OpenAI liczy zapis do pamięci podręcznej promptów po 125% zwykłej stawki za tokeny wejściowe, a każdy odczyt z 90-procentową zniżką, i zapowiada te zasady dla wszystkich kolejnych modeli. Przy kontekście 100 tysięcy tokenów w Solu cache zwraca się już przy drugim wywołaniu, ale tylko wtedy, gdy zaznaczona granica obejmuje fragment, który się nie zmienia. Sol, Terra i Luna mają zostać stałymi poziomami modeli, a numer oznacza tylko generację, co potwierdza już GPT-6.1.

OpenAI zabiera GPT-5.5 i nie zostawia furtki dla spóźnialskich
Premiera / Narzędzie

OpenAI zabiera GPT-5.5 i nie zostawia furtki dla spóźnialskich

4 min

Od 14 października GPT-5.5 przestaje odpowiadać w ChatGPT i w Codexie na wszystkich planach, ale wywołania przez API OpenAI działają dalej, więc zacznij od sprawdzenia, którędy twoje zadania wołają model. Podmiana na gpt-5.6-sol zajmuje chwilę, gorzej z miejscami, których nikt nie ogląda: zadaniem wrzuconym kiedyś do harmonogramu albo krokiem w CI z flagą --model gpt-5.5, bo takie wywołanie nie przełączy się po cichu, tylko wróci błędem. Sol jest o jedną trzecią tańszy na tokenach wyjściowych od modelu, który znika, tyle że ta promocyjna stawka obowiązuje tylko do 21 listopada.