Poradnik / Praktyka
Stare praktyki, wyższa stawka: czego LY Corporation nauczyło się, puszczając agenty na kod
Inżynierowie z LY Corporation, twórcy Flava API Gateway, opisali, że agenty kodujące nie psują starych zasad dobrego programowania, tylko je obnażają: to, co człowiek nadrabiał uwagą, agentowi trzeba podać wprost, jako automatyczne kontrole. Ich trzy filary to spisanie specyfikacji przed kodem, szybka weryfikacja przez testy i lintery (2754 testów w jakieś 15 sekund dzięki izolacji schematów) oraz powtarzalne środowisko na Devenv i Nix. Dyscyplina, którą dawniej można było po cichu wyciąć pod presją terminu, przy agencie przestaje być opcją.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Poradnik / Praktyka · 5 min ·
Inżynierowie z LY Corporation, japońskiej firmy powstałej z połączenia LINE i Yahoo Japan, opisali coś, co brzmi nudno, a okazuje się jedną z ciekawszych rzeczy o pracy z agentami kodującymi w tym roku. Budowali Flava API Gateway, wewnętrzną bramę, przez którą zespoły wystawiają i monitorują swoje API, i doszli do wniosku, że agent nie psuje starych zasad dobrego programowania. On je obnaża. To, co człowiek mógł sobie odpuścić, bo nadrabiał uwagą i doświadczeniem, agentowi trzeba podać wprost, automatycznie i w kilka sekund.
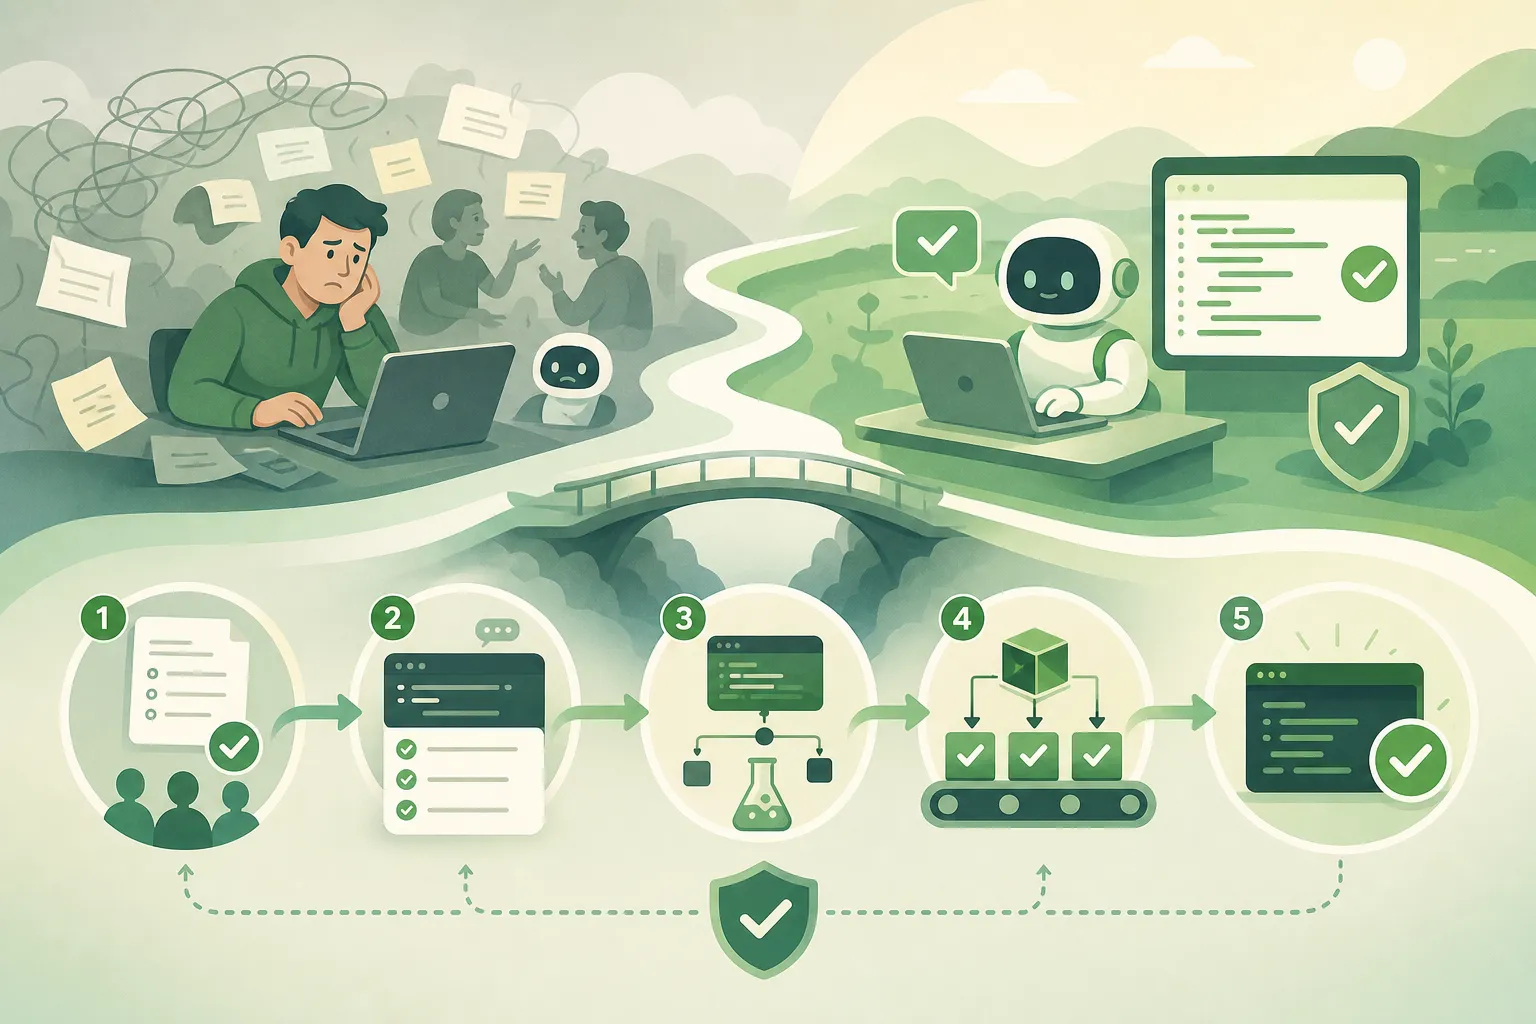
Zacznijmy od tego, jak wygląda praca z agentem, gdy nic się nie pilnuje. Zespół opisuje to bez owijania: agenty pisały kod, który się nie kompilował, odwoływały się do nieistniejących funkcji w API i podejmowały decyzje projektowe w trakcie pisania, bo nikt ich wcześniej nie ustalił. Do tego ten sam prompt potrafi dać inny wynik przy każdym uruchomieniu, więc trudno nawet powiedzieć, na co agent naprawdę stać. Pierwszy odruch zespołu był taki, jaki miałby pewnie każdy z nas: dorzućmy do promptu długą listę rzeczy, których agent ma unikać. Nie zadziałało, a prawdopodobnie pogorszyło sprawę, bo im więcej ograniczeń wrzucisz modelowi naraz, tym bardziej jakość się sypie.
To jest sedno, które LY Corporation rozpisuje na trzy filary, ale wszystkie sprowadzają się do jednej myśli. Człowiek przy klawiaturze działa w sieci niepisanych reguł: kultura code review, wspólne wyobrażenie o tym, jak powinien wyglądać kod, rzeczy, których nikt nigdy nie zapisał. Agent nie ma dostępu do żadnej z tych rzeczy. Inżynierowie z LY Corporation mówią to wprost: jedyne konwencje, jakich agent jest w stanie się trzymać, to te zapisane jako automatyczne kontrole. Cała reszta artykułu to odpowiedź na pytanie, jak takie kontrole zbudować, żeby agent uczył się na nich sam, bez człowieka stojącego nad nim przy każdym kroku.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.