Model / Badania
Transformer, który przestaje wyrzucać własne obliczenia
Preprint "Full-bandwidth transformer" z arXiv, zgłoszony 9 sierpnia 2026, proponuje latent feedback: zamiast wyrzucać stan ukryty, który transformer liczy na każdym kroku, wyuczona bramka zawraca go na dół stosu, bez zmiany architektury i niemal bez narzutu. Na modelach o miliardzie parametrów dorównuje zwykłemu transformerowi uczonemu na około 1,5 raza więcej tokenów i daje krótsze ślady rozumowania, czyli mniej tokenów na odpowiedź. To jednak sam abstrakt bez niezależnej weryfikacji na małym modelu, więc nie wiadomo, czy przewaga utrzyma się przy czołowych.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Model / Badania · 3 min ·
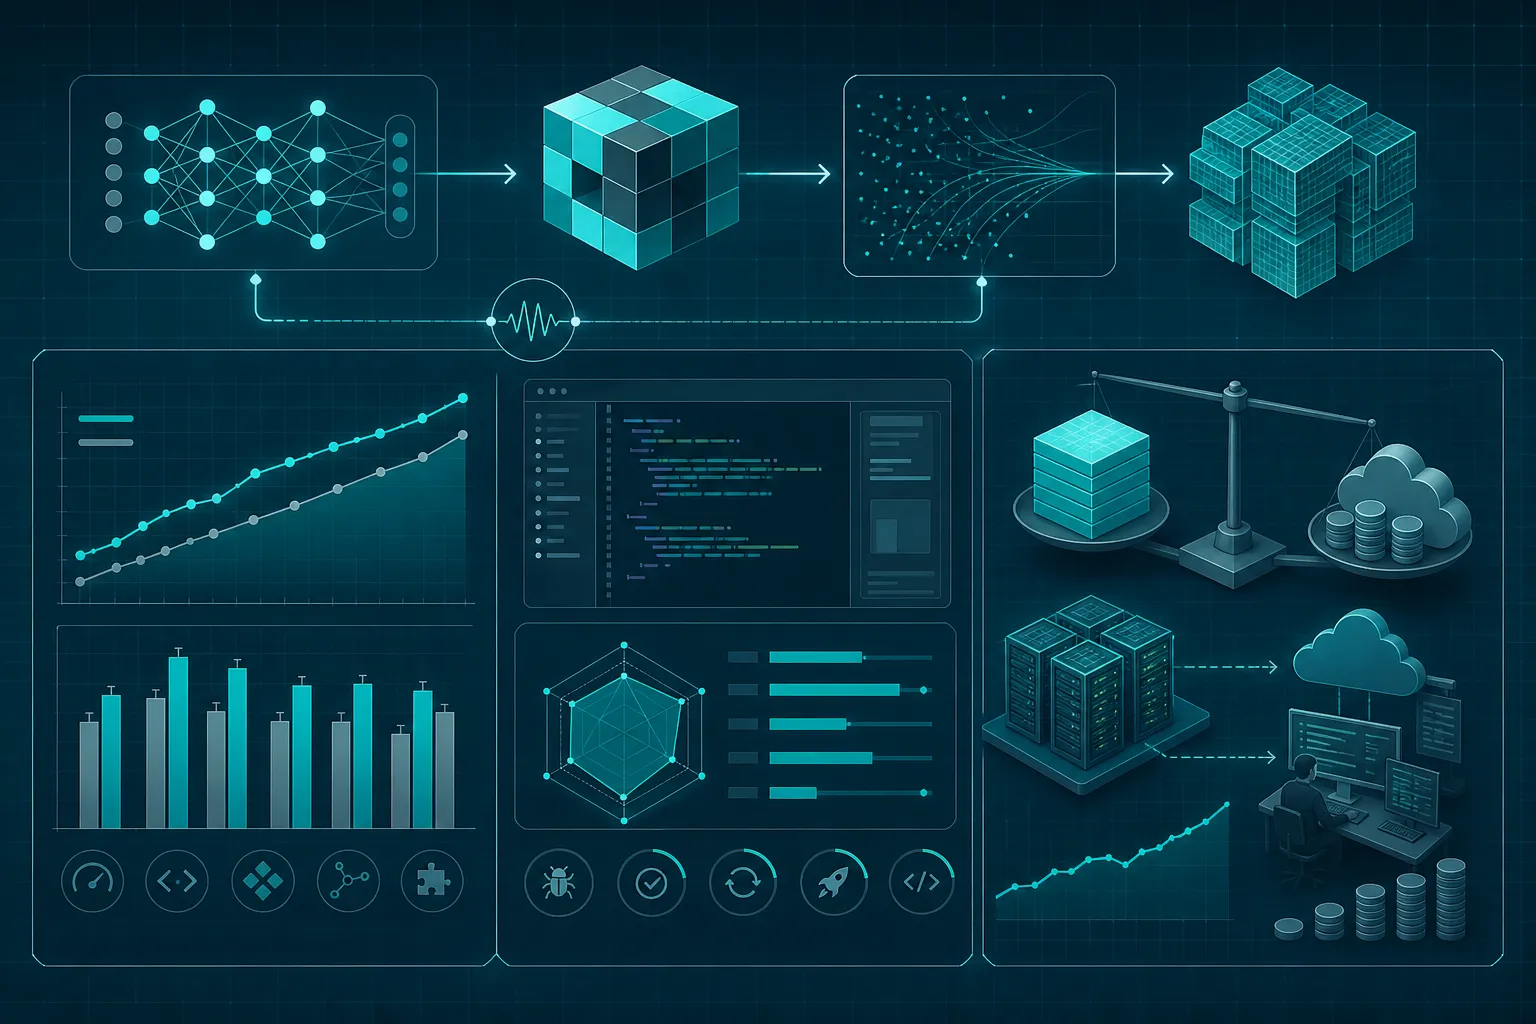
Autoregresyjny transformer, czyli ten sam typ modelu, który stoi za dzisiejszymi asystentami do kodu, przy każdym kroku generowania wykonuje mnóstwo pracy, a potem większość jej wyrzuca. Kontekst przechodzi przez kilkadziesiąt warstw, a na samej górze model wypracowuje bogatą reprezentację tego, co właśnie "przemyślał", po czym wybiera z niej jeden token, jedno słowo albo kawałek słowa, i tylko ten token wraca na dół stosu jako wejście do następnego kroku. Cała reszta, ten górny stan ukryty, ląduje w koszu. Świeży preprint z arXiv "Full-bandwidth transformer", zgłoszony 9 sierpnia 2026, proponuje, żeby przestać go marnować.
Pomysł autorzy nazywają latent feedback, sprzężeniem zwrotnym, które zawraca warstwę ukrytą do modelu. Mechanizm jest prosty. Przed kolejnym krokiem dekodowania biorą poprzedni górny stan ukryty i zszywają go z właśnie wybranym tokenem zapisanym w postaci liczb, na których pracuje model. Robi to niewielka wyuczona bramka, która decyduje, ile z każdego sygnału przepuścić dalej. Tak zszyte wejście trafia z powrotem na dół i jeszcze raz przechodzi przez wszystkie warstwy. Model dostaje więc to, co autorzy nazywają odnowionym budżetem głębokości: obliczenia, których nie zdążył zamienić w konkretny token, mogą wrócić do stosu i popracować dłużej, zamiast zniknąć bez śladu.
Dla kogokolwiek, kto myśli o wdrożeniu, ważne jest to, że zmiana nie burzy architektury. Zostaje standardowy transformer, zostaje KV cache, zostaje ten sam cel uczenia języka, a narzut na pojedynczy token przy dekodowaniu autorzy opisują jako pomijalny. Trudniejsze okazało się samo trenowanie. Normalnie model uczy się wszystkich pozycji w tekście naraz, równolegle, bo z góry zna poprawną kontynuację, a sprzężenie zwrotne tę równoległość psuje, bo każdy krok zależy od poprzedniego. Obejściem jest wprowadzenie latent feedback dopiero pod koniec trenowania wstępnego i tylko na niewielkiej części kroków, tych, w których model przepuszcza wejście przez warstwy po raz drugi, żeby całość się nie rozjechała.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.