Premiera / Narzędzie
Unsloth pakuje lokalne trenowanie modeli w aplikację, którą po prostu instalujesz
Unsloth, biblioteka znana od 2023 roku z trenowania modeli dwa razy szybciej i przy 70% mniejszym zużyciu pamięci karty, wypuścił aplikację desktopową na Windows, macOS i Linux, która wycina walkę z konfiguracją CUDA i PyTorch. Jedną komendą `unsloth start claude` podłączasz Claude Code albo Codex do modelu na własnej maszynie, a że jest on wystawiany przez API zgodne z OpenAI, przełączenie z płatnej chmury to podmiana adresu. Argumentem są koszt i prywatność, choć liczby pochodzą z testów samego Unslotha, a aplikacja jest wciąż w wersji beta.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 3 min ·
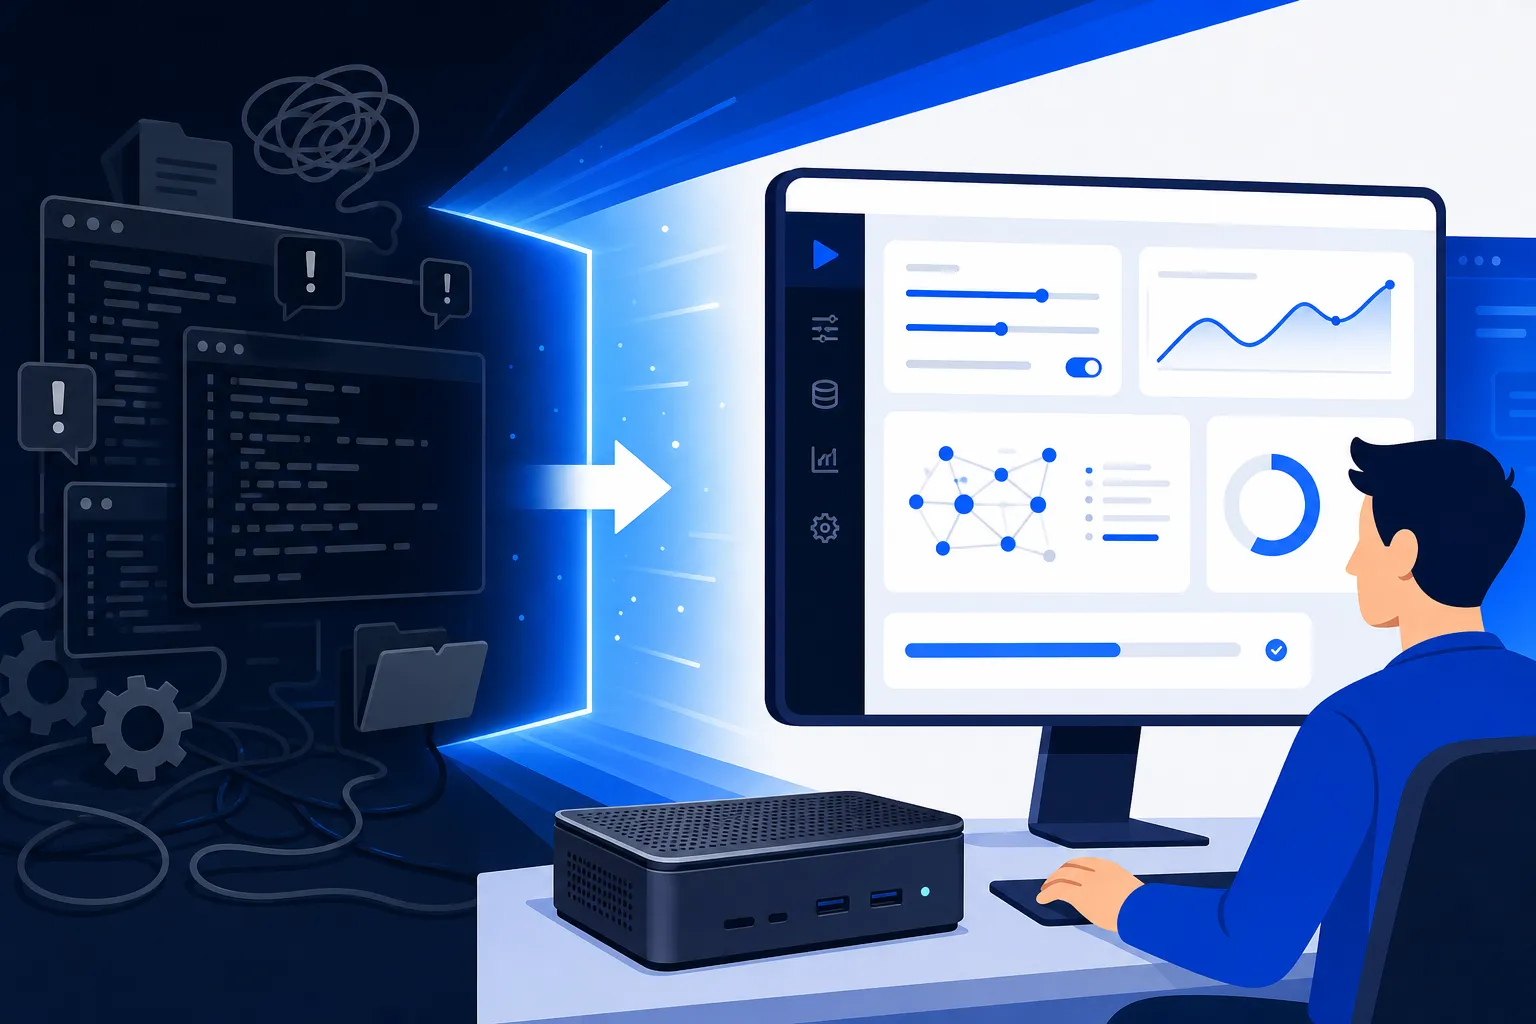
Żeby wytrenować albo w ogóle odpalić własny model na swoim komputerze, do tej pory trzeba było przejść przez to samo: zainstalować właściwą wersję CUDA, dopasować do niej PyTorch, zbudować środowisko wirtualne, a potem odkryć, że sterownik karty gryzie się z jedną z bibliotek. Większość deweloperów odpadała na tym etapie i nigdy nie dochodziła do momentu, w którym cokolwiek by trenowała. Unsloth właśnie wypuścił aplikację desktopową, która ten cały wstęp wycina: pobierasz plik, instalujesz go jak każdy inny program i masz gotowe środowisko do uruchamiania oraz trenowania modeli lokalnie, na Windowsie, macOS albo Linuksie.
Dwie rzeczy trzeba tu rozdzielić, bo łatwo je pomylić. Unsloth jako biblioteka istnieje od 2023 roku i zdobył uznanie w środowisku dzięki jednej konkretnej rzeczy: potrafi trenować i douczać modele dwa razy szybciej, zużywając przy tym o 70% mniej pamięci karty graficznej. Dzięki temu douczenie gotowego modelu na własnych danych, znane jako fine-tuning, mieści się na sprzęcie średniej klasy, a nie dopiero w serwerowni. To nie jest nowość z tego tygodnia. Nowa jest droga dostarczenia: Unsloth Desktop, aplikacja, która zamienia bibliotekę odpalaną z linii poleceń na zwykłe okno z przyciskami.
I tu dochodzimy do części, która moim zdaniem znaczy więcej niż samo trenowanie. Jedną komendą, unsloth start claude, podłączasz Claude Code albo Codex, czyli dwa popularne agenty do kodowania, do modelu działającego na twojej maszynie. Agent do kodowania, którego normalnie odpytujesz przez płatne API i któremu po drodze wysyłasz swój kod na cudze serwery, nagle rozmawia z modelem stojącym obok, na tym samym dysku. Możesz go wpiąć również jako lokalny subagent, czyli pomocnika głównego modelu: ten mocniejszy zostaje w chmurze i prowadzi całą robotę, a lokalnemu oddajesz drobne, powtarzalne zadania w rodzaju formatowania czy prostych poprawek, za które przy płatnym API płaciłbyś od każdego wywołania osobno.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.