SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

37,5 tysiąca dolarów za małego Qwena obudowanego konsolą Pythona

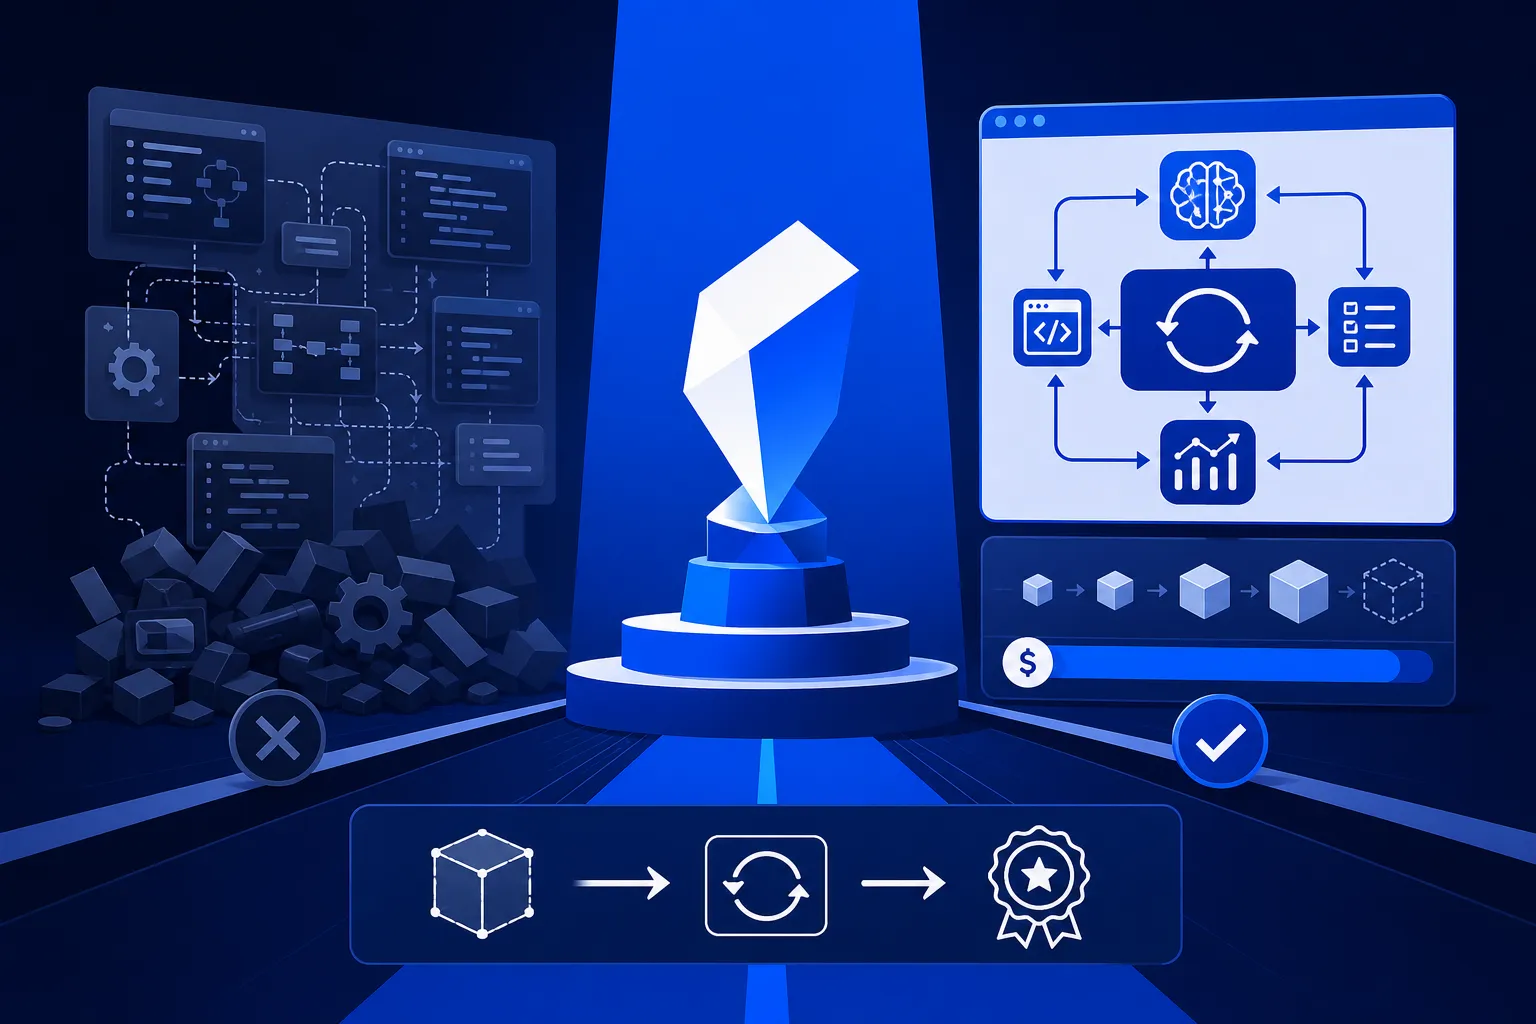
Tufa Labs wygrało pierwszy etap konkursu ARC-AGI-3 i pulę 37,5 tysiąca dolarów rozwiązaniem zaskakująco skromnym: małym, otwartym modelem Qwen obudowanym prostym agentem, którego jedynym narzędziem była interaktywna konsola Pythona. Pobiło tym podejścia oparte na modelach wizyjno-językowych, choć samą grę jako pierwszy przeszedł dopiero większy GPT-5.6 Sol. Sedno brzmi nie "mały bije dużego", tylko subtelniej: gdy modele do kodu stają się towarem, prawdziwą przewagą jest harness, czyli minimalna pętla sterująca wokół modelu, którą da się złożyć samemu na laptopie.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
37,5 tysiąca dolarów za małego Qwena obudowanego konsolą Pythona
Ilustrację przygotowała AI.

Tufa Labs zajęło pierwsze miejsce w konkursie ARC-AGI-3 o puli nagród 37,5 tysiąca dolarów za rozwiązanie, które na tle rywali wygląda niemal zbyt skromnie: mały, otwarty model z rodziny Qwen, obudowany prostym agentem do pisania kodu, którego jedynym narzędziem była interaktywna konsola Pythona. Model pisał w niej kod, od razu widział wynik i próbował dalej. Żadnej wyspecjalizowanej warstwy, żadnego wielkiego modelu.

Warto zatrzymać się na chwilę przy tym, czym jest ARC-AGI-3, bo bez tego wynik nic nie mówi. To nie jest benchmark do kodu, w którym zadanie jest z góry znane. To zestaw nieznanych gier, w których agent trafia do środowiska, którego nigdy wcześniej nie widział, i musi sam rozgryźć reguły, eksperymentować i działać. Mierzy się tu radzenie sobie z nowością, a nie wiedzę wyuczoną podczas trenowania. Dlatego dobry wynik małego modelu zaskakuje: to właśnie takie zadania miały być domeną największych i najdroższych modeli.

Ciekawiej robi się, gdy zestawimy Tufa Labs z konkurencją. ARC Prize wyróżnił trzy podejścia. Zespół Reki postawił na model wizyjno-językowy, który odczytuje planszę i zwraca ruchy jako gotowe polecenia. Md Boktiar Mahbub Murad zapakował podobnego, opartego na obrazie agenta w konfigurowalny framework. Wygrało to najprostsze rozwiązanie, bez warstwy wizyjnej, za to z modelem, który po prostu pisze i uruchamia kod.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Lokalny agent do kodu, który celowo mniej myśli
Model / Badania

Lokalny agent do kodu, który celowo mniej myśli

3 min

Jackrong wypuścił Qwopus-3.6-35B-A3B-Coder, model do kodu oparty na Qwen3.6, w którym rozumowanie jest domyślnie wyłączone. To mieszanka ekspertów z 35 miliardami wag, z których przy każdym tokenie pracuje tylko około 3 miliardów, więc działa lokalnie i zebrał 45 tysięcy pobrań miesięcznie. Autorzy chwalą się wynikiem 62,4% na SWE-bench, ale to przebieg policzony przez sam zespół na 300 zadaniach, bez potwierdzenia. Bez rozumowania model pewniej trzyma się poleceń i stabilniej ciągnie stan przez tury, za to w kompetencji inżynierskiej przegrywa z rywalem tej samej wielkości, 81 do 94.

OpenAI sprzedaje klawiaturkę za 230 dolarów, żeby doglądać agentów
Premiera / Narzędzie

OpenAI sprzedaje klawiaturkę za 230 dolarów, żeby doglądać agentów

4 min

OpenAI wypuściło swój pierwszy sprzęt z własnym logo i nie jest to zapowiadany głośnik Jony'ego Ive'a, tylko Codex Micro, podświetlana klawiaturka za 230 dolarów zrobiona z Work Louder. Sześć kolorowych klawiszy pokazuje na żywo, na jakim etapie jest każdy agent Codexa, do tego dochodzi pokrętło do regulacji poziomu myślenia i joystick do gotowych scenariuszy. Całą konstrukcję trzyma teza, że praca programisty przestała polegać na pisaniu kodu, a zaczęła na doglądaniu floty agentów. Te same skróty odtworzysz jednak na Stream Decku za ułamek ceny.

GPT-6 Sol i Luna: OpenAI tnie ceny o połowę, ale liczyć trzeba koszt zadania
Model / Badania

GPT-6 Sol i Luna: OpenAI tnie ceny o połowę, ale liczyć trzeba koszt zadania

4 min

OpenAI wypuściło 22 września modele GPT-6 Sol i Luna o połowę tańsze od poprzedników, ale przy agencie programistycznym liczy się koszt całego zadania, a nie cena tokenu. Sol zdobywa 68,8% na DeepSWE, teście agentów naprawiających prawdziwe repozytoria, czyli niewiele mniej niż Claude Fable 5 przy rachunku niższym o około 80%. Niezależne pomiary studzą jednak entuzjazm, bo Artificial Analysis daje Solowi 48 punktów wobec 58 dla Claude Opus 5.5, a tańszy DeepSeek V4.1 Flash wyprzedza Lunę w programowaniu.