SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Poradnik / Praktyka

Co naprawdę poprawia rozumowanie modelu, gdy nie możesz sięgnąć po większy?

NVIDIA rozegrała na Kaggle konkurs, w którym ponad 5000 uczestników dostało ten sam model Nemotron-3-Nano-30B, mogło doszkalać tylko adapter LoRA i musiało zmieścić rozumowanie w sztywnym budżecie tokenów bez internetu. Z pięciu wniosków wraca jeden: model uczy się tak dobrze, jak dobrze da się sprawdzić każdy krok jego rozumowania, bo prawidłowa odpowiedź potrafi ukrywać zepsutą drogę, a jedna uśredniona liczba zamiata pod dywan słabości w konkretnych zadaniach. To podsumowanie NVIDIA, promujące jej model i karty Blackwell, ale kto dostraja własny model, dostaje gotową listę do sprawdzenia.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Poradnik / Praktyka  ·  3 min  · 
Co naprawdę poprawia rozumowanie modelu, gdy nie możesz sięgnąć po większy?
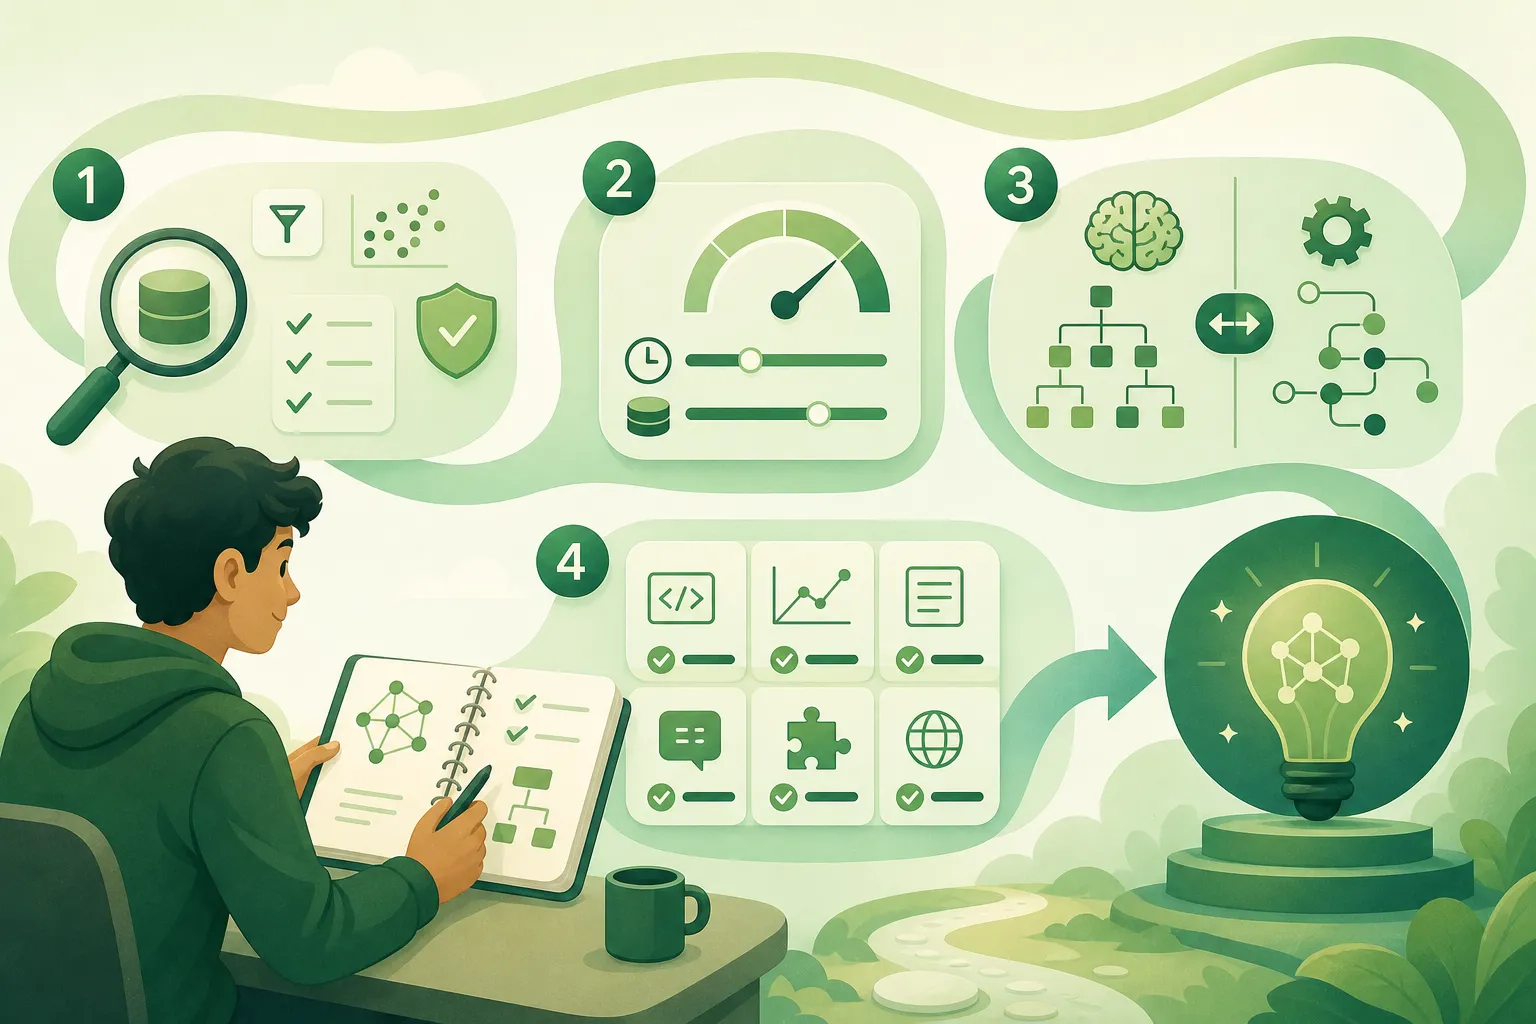
Ilustrację przygotowała AI.

NVIDIA rozegrała na Kaggle konkurs, w którym ponad 5000 uczestników dostało ten sam otwarty model i ten sam komplet ograniczeń, a wygrać mógł tylko ten, kto najlepiej przygotował dane treningowe. Nemotron Model Reasoning Challenge był ułożony tak, żeby odciąć wszystkie zwykłe drogi na skróty. Każdy zaczynał od modelu Nemotron-3-Nano-30B, trenować dało się wyłącznie mały adapter LoRA, lekką nakładkę doszkalaną zamiast całego modelu. W trakcie oceny nie było dostępu do internetu, a całe rozumowanie razem z odpowiedzią musiało zmieścić się w sztywnym budżecie tokenów, czyli w z góry ustalonym limicie tekstu, jaki model może przeczytać i wygenerować. Nie da się tu wygrać większym modelem ani wyszukiwarką. Zostaje jedno: nauczyć model lepiej myśleć.

Po 4000 zespołów i ponad 1000 wpisów na forum NVIDIA spisała pięć wniosków. Uderzyło mnie, jak mało w nich magii. Nie ma jednego promptu ani jednej sztuczki treningowej. Jest za to jedna myśl, która wraca w czterech na pięć lekcji: model uczy się dokładnie tak dobrze, jak dobrze da się sprawdzić ślad jego rozumowania. Nie sama końcowa odpowiedź, ale każdy krok do niej.

Prawidłowa odpowiedź potrafi ukrywać zepsute rozumowanie

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Po co trzymać dwa modele naraz, skoro jeden potrafi podpowiadać sam sobie?
Model / Badania

Po co trzymać dwa modele naraz, skoro jeden potrafi podpowiadać sam sobie?

4 min

NVIDIA pokazała Nemotron-Labs-Diffusion, model, w którym jeden zestaw wag pełni obie role znane z dekodowania spekulacyjnego: sam sobie podpowiada blok tokenów i sam je weryfikuje, dzięki czemu nie trzeba trzymać w pamięci drugiego, pomocniczego modelu. W teście SPEED-Bench przyjmował średnio 6,82 tokenu na krok wobec 2,75 u Eagle3, a wariant 8B dawał czterokrotnie wyższą przepustowość niż Qwen3-8B przy niemal niezmienionej jakości, 62,81% wobec 63,61%. To na razie preprint samej NVIDIA, bez recenzji, ale wagi w wersjach 3B, 8B i 14B leżą już na Hugging Face na licencji komercyjnej.

NVIDIA rozbija model na dwie części, żeby pisał tekst 2,42 raza szybciej
Model / Badania

NVIDIA rozbija model na dwie części, żeby pisał tekst 2,42 raza szybciej

4 min

NVIDIA pokazała Nemotron-Labs-TwoTower, model, który generuje tekst całymi blokami po 16 słów naraz zamiast token po tokenie, dzięki czemu pisze 2,42 raza szybciej przy zachowaniu 98,7% jakości modelu bazowego. Sztuczka polega na rozbiciu sieci na dwie wieże: zamrożoną kontekstową i odszumiającą, która równolegle wypełnia puste miejsca. Płaci się za to drugą kartą GPU i spadkiem jakości tam, gdzie liczy się precyzja, bo na HumanEval wynik spada z 79,27 do 75,58. Prawdziwa wartość to nie sam model, ale recepta na przyspieszenie gotowych modeli autoregresyjnych bez trenowania od zera.

Model nie musi kończyć każdej próby, żeby się czegoś nauczyć
Analiza / Opinia

Model nie musi kończyć każdej próby, żeby się czegoś nauczyć

4 min

Luke Bailey ze współautorami opisał 30 września na arXiv metodę AC2, w której model uczony przez wzmacnianie nie musi kończyć każdej próby, bo dopisuje krótki odcinek do wcześniejszego początku, a ocenę daje mu wyuczony krytyk zamiast sprawdzarki. Na modelu Qwen3-4B i teście IMO-ProofBench AC2 przebiło najlepszy wynik GRPO, czyli 18,5%, przy 2,5 raza mniejszym nakładzie obliczeń na generowanie. To jednak jeden mały model i jedna dziedzina, więc z wdrażaniem poczekałbym na niezależną powtórkę.