SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Analiza / Opinia

Model nie musi kończyć każdej próby, żeby się czegoś nauczyć

Luke Bailey ze współautorami opisał 30 września na arXiv metodę AC2, w której model uczony przez wzmacnianie nie musi kończyć każdej próby, bo dopisuje krótki odcinek do wcześniejszego początku, a ocenę daje mu wyuczony krytyk zamiast sprawdzarki. Na modelu Qwen3-4B i teście IMO-ProofBench AC2 przebiło najlepszy wynik GRPO, czyli 18,5%, przy 2,5 raza mniejszym nakładzie obliczeń na generowanie. To jednak jeden mały model i jedna dziedzina, więc z wdrażaniem poczekałbym na niezależną powtórkę.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Analiza / Opinia  ·  4 min  · 
Model nie musi kończyć każdej próby, żeby się czegoś nauczyć
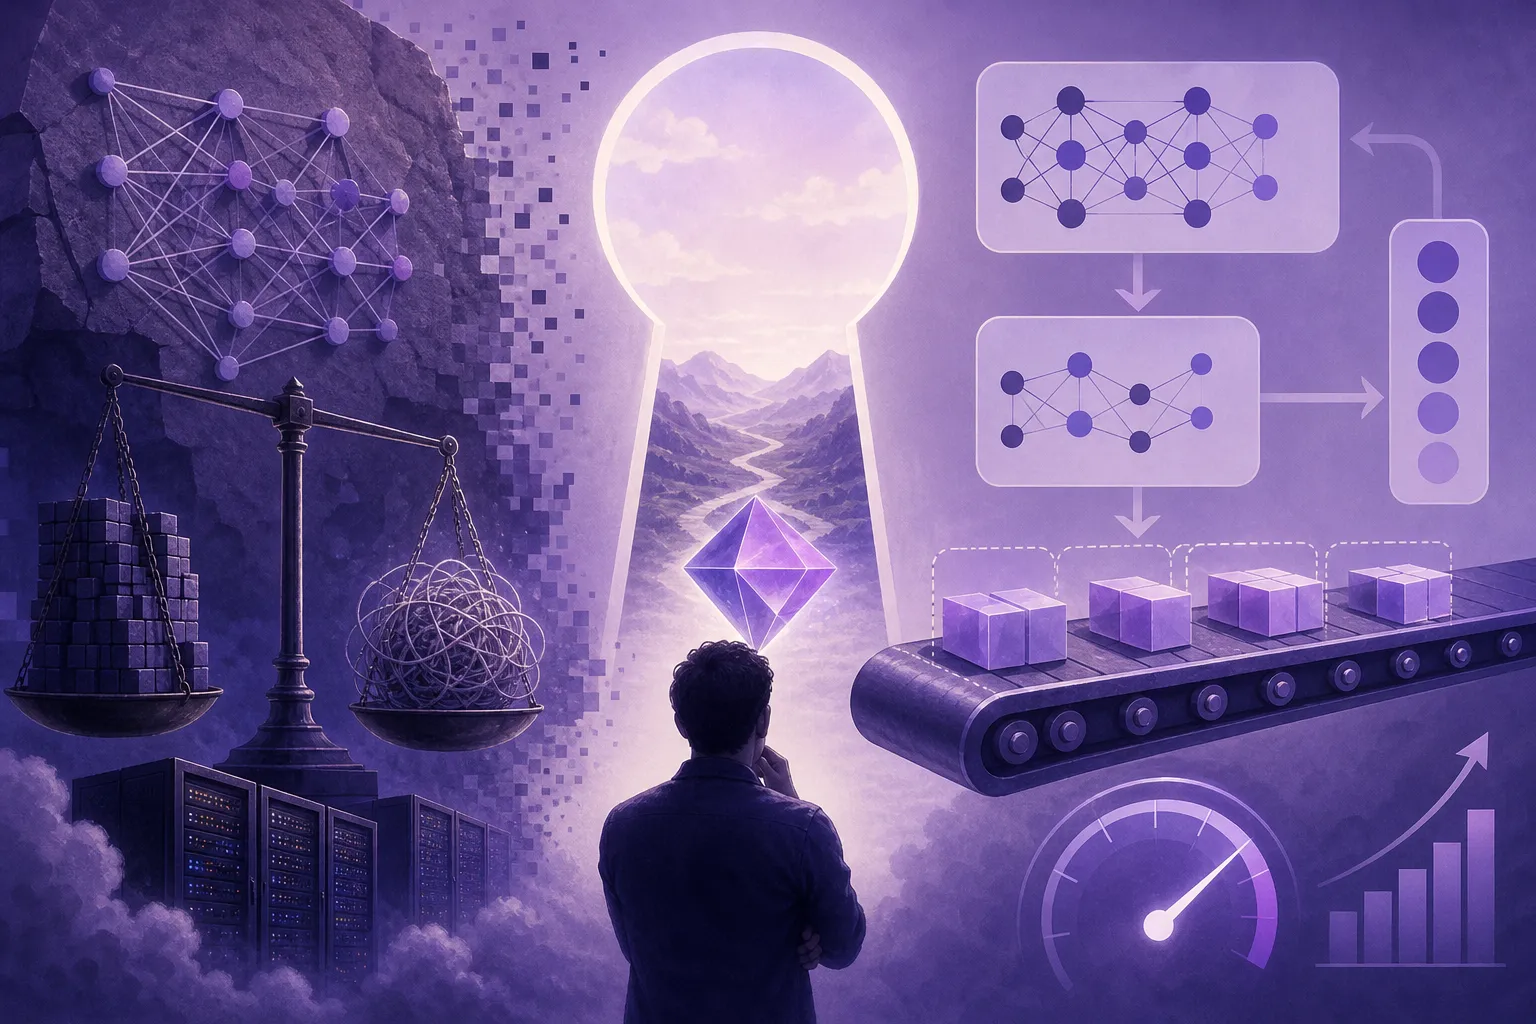
Ilustrację przygotowała AI.

Kiedy model językowy uczy się metodą prób i błędów, najwięcej kosztuje go samo pisanie. Każda próba to pełne rozwiązanie, często na dziesiątki tysięcy tokenów, a ocenę model dostaje dopiero na końcu, gdy sprawdzarka orzeknie, czy wynik jest dobry. Luke Bailey ze współautorami opisał 30 września na arXiv metodę AC2, która tego końca nie musi za każdym razem oglądać, a do wyniku standardowego podejścia dochodzi przy 2,5 raza mniejszym nakładzie obliczeń na generowanie tekstu. Moim zdaniem ta praca jest ciekawsza jako dowód, że da się inaczej, niż jako gotowy przepis dla zespołu, który dziś dostraja własny model.

Jedna ocena na cały dowód

Wyobraźcie sobie nauczyciela, który pod dziesięciostronicowym dowodem stawia jedną ocenę, a ta sama ocena trafia zarówno do błyskotliwego pomysłu z drugiej strony, jak i do pomyłki z dziewiątej. Tak według autorów działają standardowe algorytmy uczenia przez wzmacnianie dla modeli językowych: każdy token długiej próby dostaje tę samą zasługę, wyliczoną z nagrody końcowej. Za punkt odniesienia praca bierze GRPO, popularną metodę z tej rodziny, w której model pisze kilka rozwiązań tego samego zadania, a każde z nich jest nagradzane albo karane zależnie od tego, czy wypadło lepiej, czy gorzej od średniej całej grupy. Tu też liczy się wyłącznie werdykt na samym końcu.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Pięć podejść agenta, jeden sędzia i żadnych testów
Premiera / Narzędzie

Pięć podejść agenta, jeden sędzia i żadnych testów

4 min

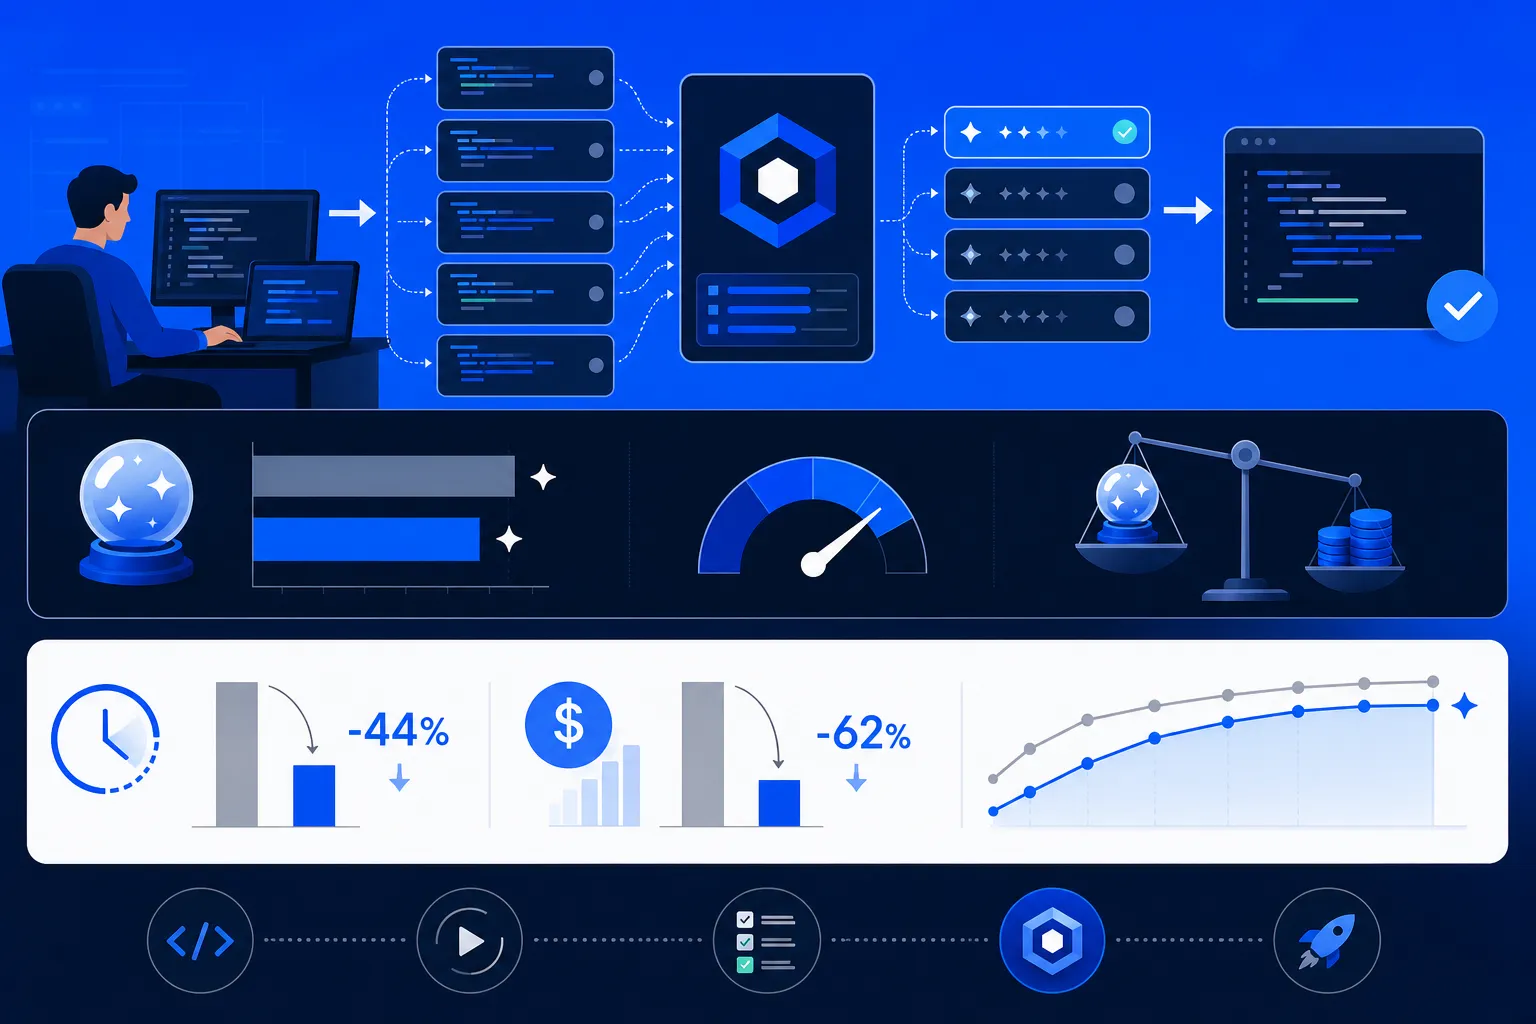
LLM-as-a-Verifier bierze pulę podejść agenta do jednego zadania i każe modelowi porównywać je parami, licząc przy tym nie samą notę, tylko pewność, z jaką model ją stawia. Na Terminal-Bench 2.1 model deepseek-v4-flash pojedynczym podejściem zaliczał 78,7% zadań, a wybór najlepszego z pięciu podniósł wynik do 88,0%, tyle że płaci się wtedy pięć razy zamiast raz. Ciekawszy jest drugi tryb, który ocenia jedno podejście krok po kroku, dzięki czemu beznadziejne da się przerwać po trzecim ruchu i ten rachunek raczej zbić niż napompować.

Co naprawdę poprawia rozumowanie modelu, gdy nie możesz sięgnąć po większy?
Poradnik / Praktyka

Co naprawdę poprawia rozumowanie modelu, gdy nie możesz sięgnąć po większy?

3 min

NVIDIA rozegrała na Kaggle konkurs, w którym ponad 5000 uczestników dostało ten sam model Nemotron-3-Nano-30B, mogło doszkalać tylko adapter LoRA i musiało zmieścić rozumowanie w sztywnym budżecie tokenów bez internetu. Z pięciu wniosków wraca jeden: model uczy się tak dobrze, jak dobrze da się sprawdzić każdy krok jego rozumowania, bo prawidłowa odpowiedź potrafi ukrywać zepsutą drogę, a jedna uśredniona liczba zamiata pod dywan słabości w konkretnych zadaniach. To podsumowanie NVIDIA, promujące jej model i karty Blackwell, ale kto dostraja własny model, dostaje gotową listę do sprawdzenia.

Zamiast pompować parametry, wydłużyli horyzont treningu agenta
Model / Badania

Zamiast pompować parametry, wydłużyli horyzont treningu agenta

3 min

InternScience pokazuje Agents-A1 — otwarty model o 35 miliardach parametrów, który na kilku benchmarkach dorównuje gigantom z bilionem parametrów, jak Kimi-K2.6 czy DeepSeek-V4-pro. Zamiast powiększać model, autorzy wydłużyli horyzont treningu, ucząc go na bardzo długich przebiegach i przelewając wiedzę sześciu wyspecjalizowanych nauczycieli do jednego ucznia. Przewaga leży jednak głównie w zadaniach naukowych, a nie w kodowaniu, a wszystkie liczby pochodzą od samych autorów i czekają na niezależne powtórzenie.