Premiera / Narzędzie
Copilot Fusion sam wybiera model, a GitHub Enterprise przechodzi na kredyty AI
Na konferencji Universe 28 października GitHub udostępnił Copilot Fusion, który sam dobiera model i sposób wykonania zadania, a programiście zostawia tylko wybór poziomu wysiłku: Standard, High albo Max. Jay Parikh z Microsoftu twierdzi, że Fusion Max wypada niemal tak dobrze jak Claude Code z Opus 5.5 Max za połowę ceny, ale nikt spoza firmy tego nie sprawdził. Jednocześnie klienci GitHub Enterprise mogą płacić za zużyte kredyty AI zamiast osobnej licencji, tylko że cennika brak, więc rachunek zależy od decyzji, których programista nie widzi.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 5 min ·
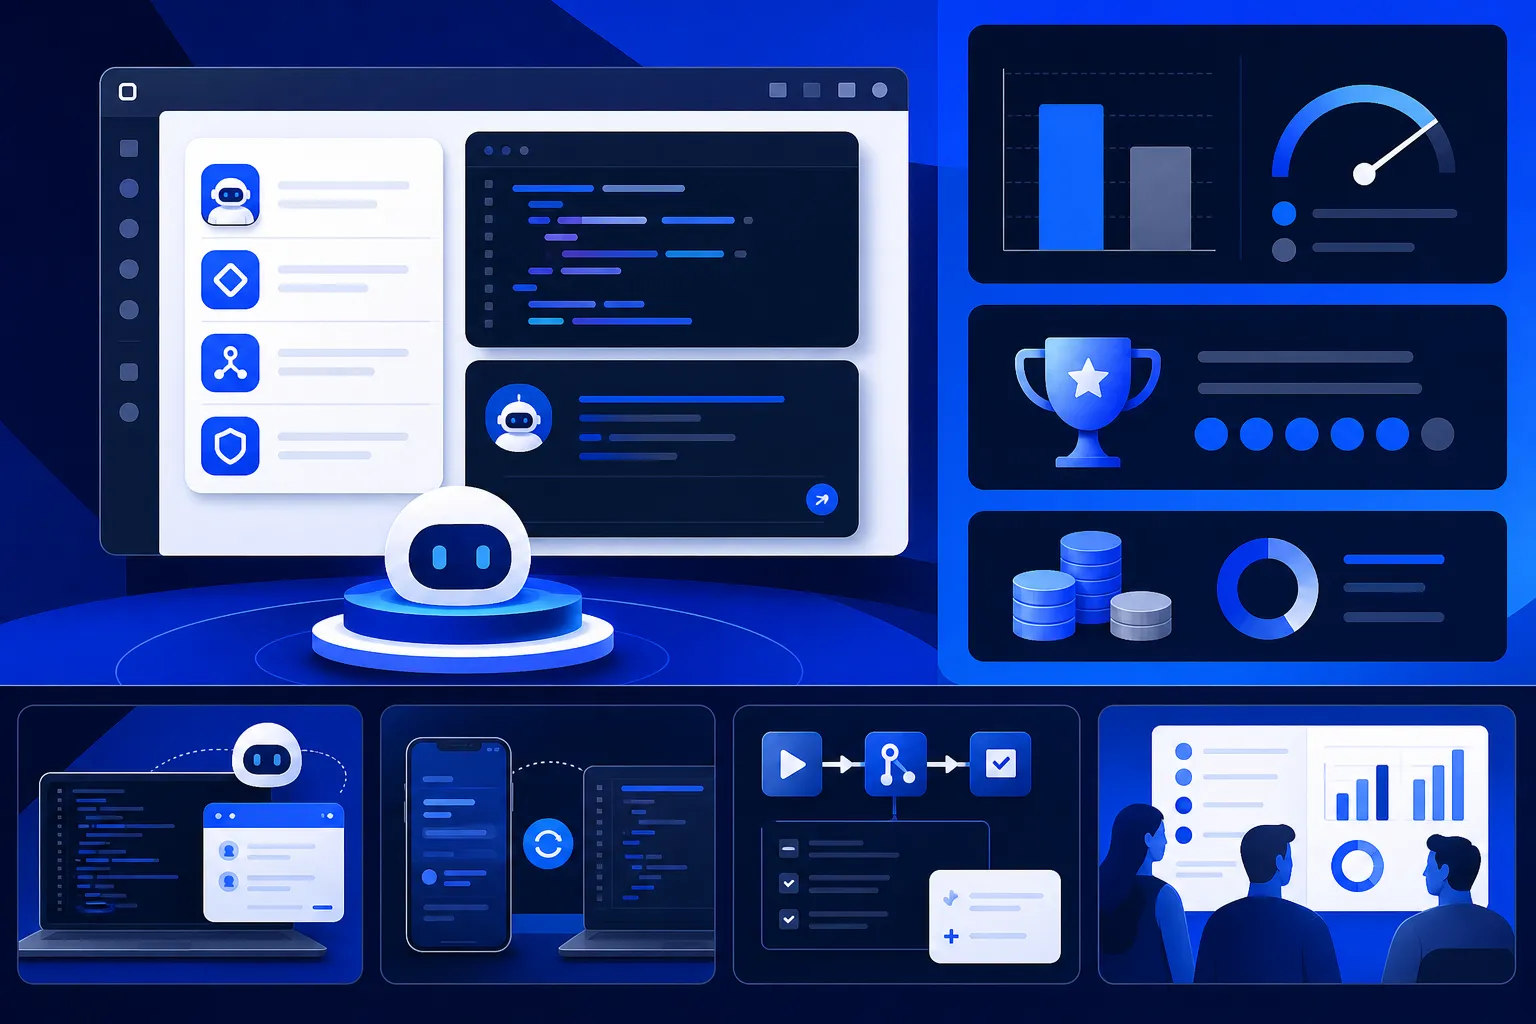
W środę 28 października GitHub otworzył w San Francisco swoją konferencję Universe i pokazał, jak wyobraża sobie Copilota na najbliższy rok. Do tej pory Copilot był asystentem, w którym programista sam wybierał z listy model do zadania. Teraz może ten wybór oddać systemowi Copilot Fusion, który jest ogólnie dostępny od dnia premiery. Obok niego GitHub zmienił sposób płacenia: firmy z GitHub Enterprise mogą korzystać z Copilota bez osobnej licencji i płacić za faktyczne zużycie. Wszystko to znam na razie wyłącznie z ust GitHuba i Microsoftu. Te dwie zmiany razem tworzą napięcie, które warto mieć w głowie od początku: skoro model wybiera system, a płaci się za zużycie, wysokość rachunku zależy od decyzji, których programista nie widzi. Liczb, którymi GitHub podparł obietnicę niższych kosztów, nikt jeszcze niezależnie nie sprawdził.
Copilot Fusion: programista wybiera wysiłek, a nie model
W praktyce Fusion zostawia ci jedną decyzję, czyli poziom wysiłku. Standard służy do codziennego kodu, High do trudniejszych zadań wymagających dłuższego rozumowania, a Max do najcięższej roboty, opisuje The New Stack. Resztę system ustala sam: ocenia, czego zadanie potrzebuje, wybiera model i jedną z trzech dróg. Na najprostszej jeden model wykonuje całe zadanie. Na drugiej odpowiedź trafia do bramki jakości, która ją przyjmuje, a gdy odpowiedź wypada za słabo, przekazuje zadanie mocniejszemu modelowi. Na trzeciej jeden model pisze, a drugi recenzuje jego pracę. We wrześniu pisałem o Project HydraFusion, eksperymencie, z którego ta orkiestracja wyrosła, i już wtedy było widać jej cenę: nie wiadomo, którą drogą poszło zadanie, więc przy słabszym wyniku trudno ustalić, czy zawiódł model, bramka, czy recenzent, a tym samym, co poprawić w poleceniu albo ustawieniach.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.