Analiza / Opinia
Copilot wygrywa w ReviewBench, ale wyniki rywali zmierzył sam GitHub
Copilot code review prowadzi w rankingu ReviewBench z wynikiem 40,1%, ale wyniki wszystkich rywali zmierzył sam GitHub, i to w różnych terminach: Copilota 1 października, a Cubic i Greptile jeszcze w czerwcu. W niezależnym benchmarku firmy Martian prowadzi Cubic z 64,9% F1, a Copilot jest czwarty, co pokazuje, jak mocno metoda ustawia kolejność. Z tej tabeli nie wybierałbym więc recenzenta dla zespołu, ale otwarty zbiór 219 pull requestów i ustawienia sędziego pozwalają sprawdzić własną konfigurację.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Analiza / Opinia · 4 min ·
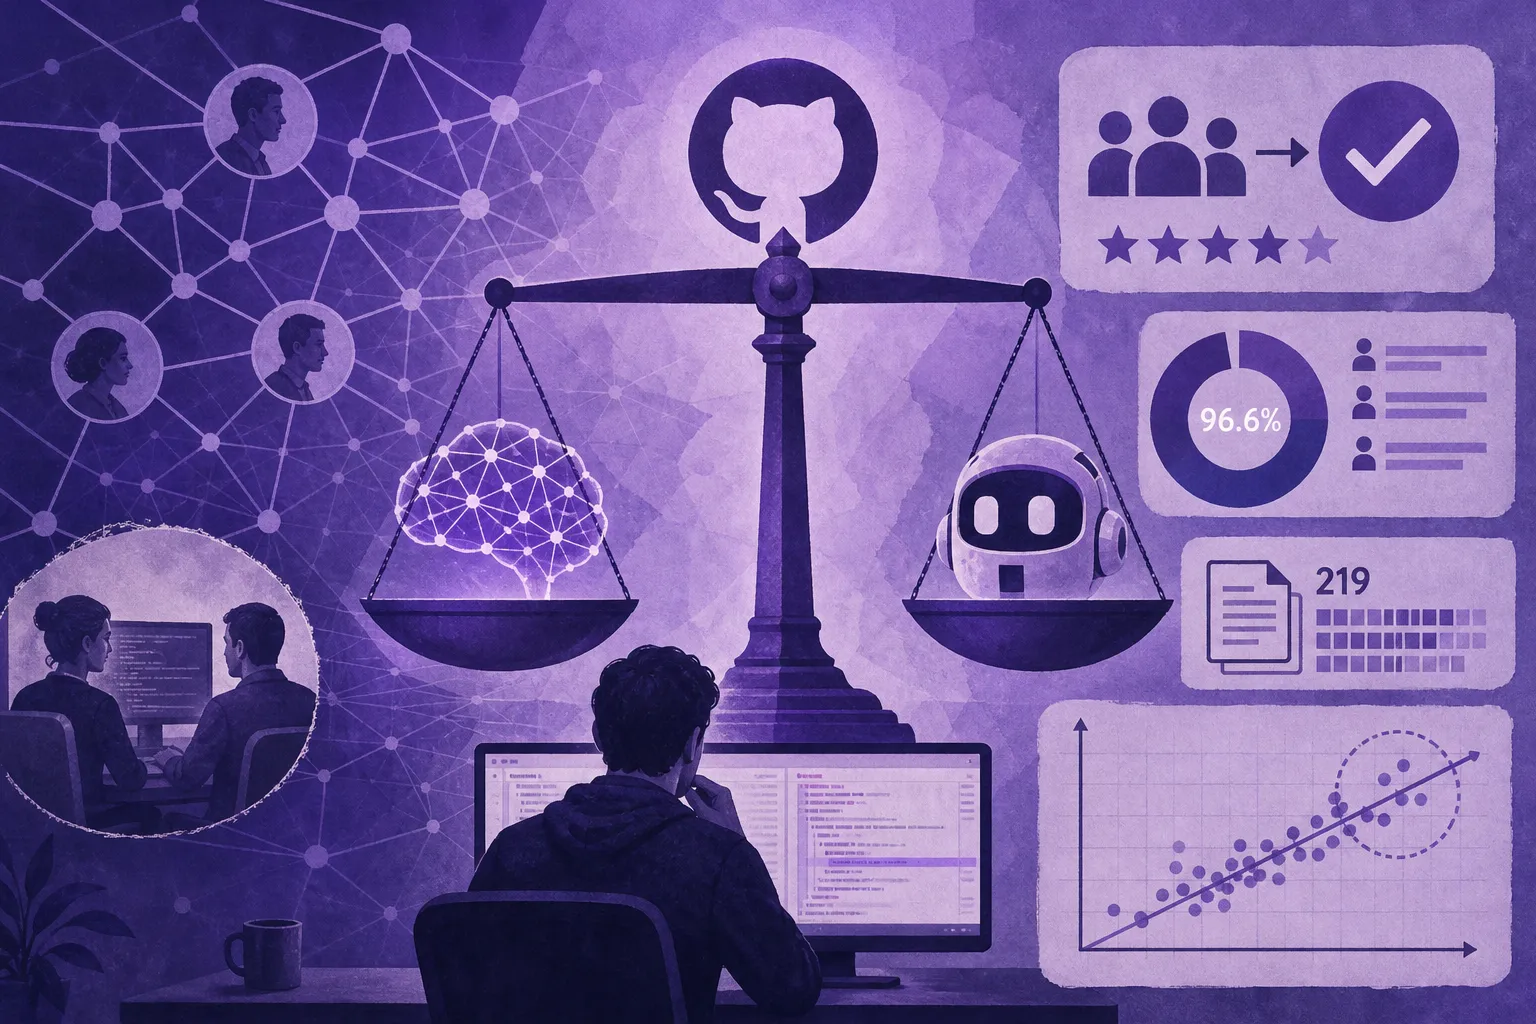
Wbudowany w GitHuba recenzent AI, Copilot code review, prowadzi w rankingu ReviewBench z wynikiem 40,1%. Wyniki wszystkich rywali w tym rankingu zmierzył jednak sam GitHub. Zwrócił na to uwagę Paul Sawers z The New Stack, zestawiając tabelę GitHuba z niezależnym benchmarkiem firmy Martian, w którym Copilot jest czwarty albo piąty, zależnie od tabeli.
Tydzień temu pisałem o samym ReviewBench. GitHub zebrał 219 dużych pull requestów ze 187 publicznych repozytoriów, przygotował do nich listę problemów, które dobry recenzent powinien wyłapać, a uwagi recenzentów AI ocenia Claude Sonnet 5 w roli sędziego. Wynik, tak zwane grounded F1, łączy dwie rzeczy: recenzent zyskuje za każdy problem z listy, który znalazł, i traci za każdą uwagę, która w żaden z nich nie trafiła. Wtedy zajmowało mnie, czy taki test przewidzi, jak recenzent sprawdzi się u ludzi. Teraz ważniejsze wydaje mi się pytanie, kto i kiedy przepuścił przez niego konkurencję.
Wszystkie pierwsze wpisy przygotował zespół GitHuba
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.