Premiera / Narzędzie
Czy agent kodujący pamięta, co zbudował czterdzieści kroków wcześniej?
LoopsBench, benchmark opisany przez Han Li i współautorów na arXiv, sprawdza, czy agent kodujący po czterdziestym kroku nie psuje tego, co zbudował w trzecim, bo testy ukończonych części muszą przechodzić aż do końca zadania. Najlepsza konfiguracja, czyli Opus 4.7 w Claude Code z pętlą wznawiającą, domyka tylko 25% ze 112 zadań. Plany agentów odtwarzają jedynie część zależności, a regresje pojawiają się w każdym wariancie pętli, więc przy własnym agencie warto w każdej iteracji uruchamiać cały zestaw testów.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 4 min ·
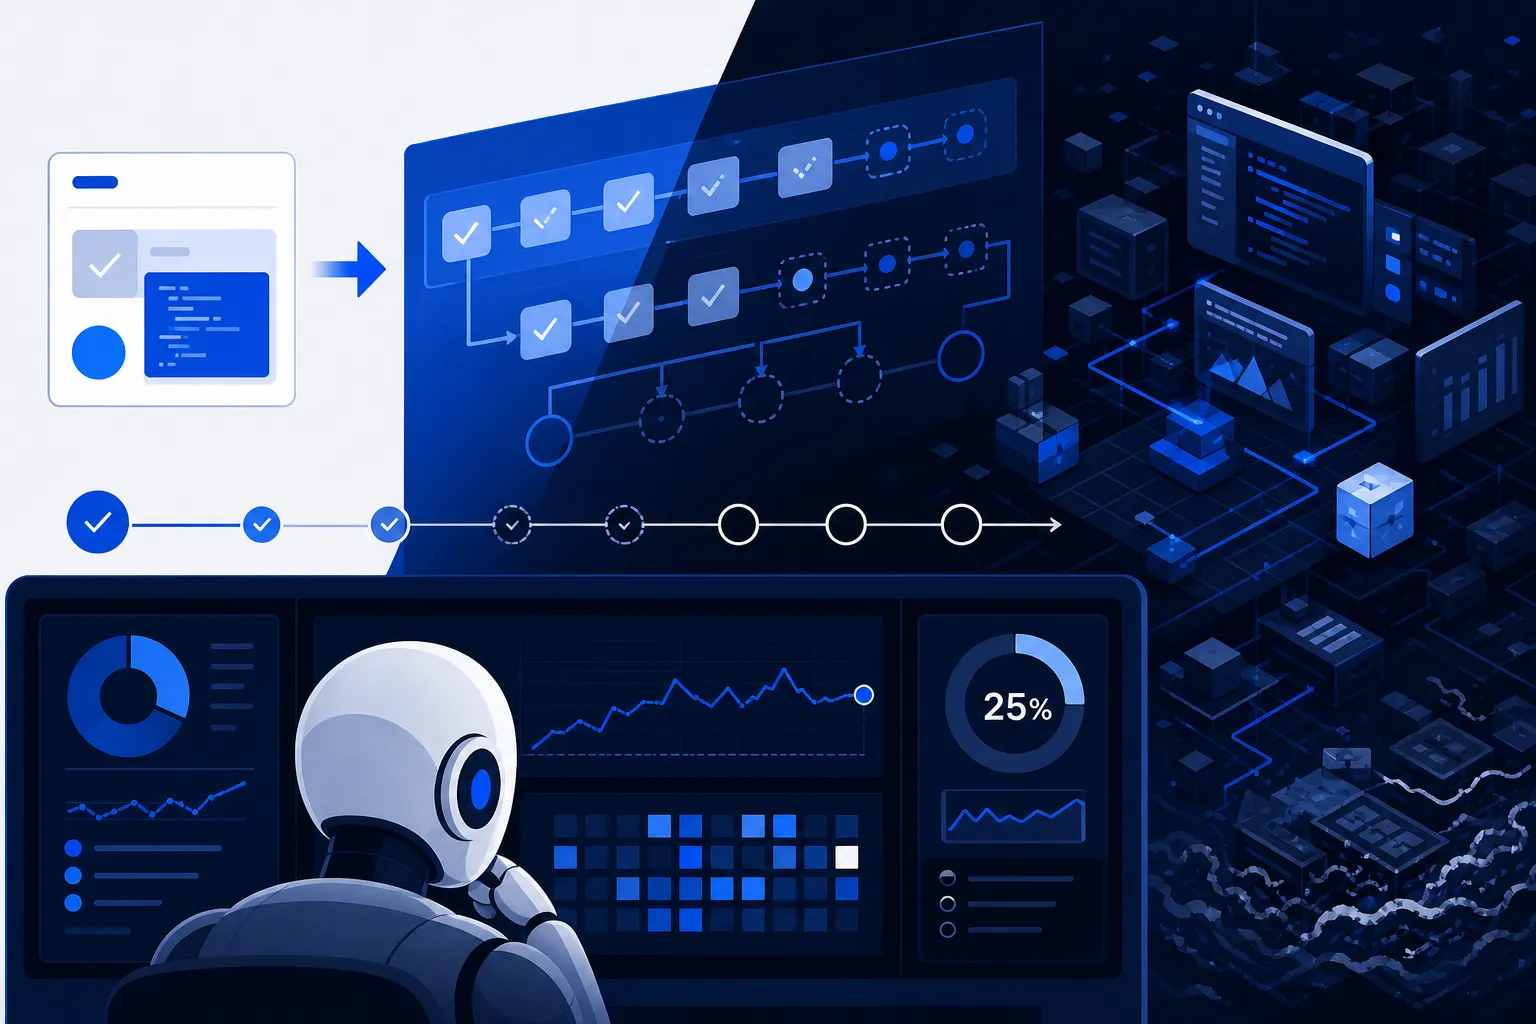
Większość testów dla agentów kodujących przypomina pojedyncze zgłoszenie w trackerze błędów. Jest usterka, jest test, który ją łapie, a agent ma sprawić, żeby test przeszedł. LoopsBench, benchmark opisany przez Han Li i dziesięciu współautorów w pracy opublikowanej na arXiv, mierzy coś, z czym zderza się każdy, kto zostawia agenta na całą noc: czy po czterdziestym kroku wciąż działa to, co agent zbudował w trzecim. Najlepsza konfiguracja domyka w tym teście 25% zadań. Jest nią Opus 4.7, model językowy firmy Anthropic, uruchomiony w Claude Code, narzędziu tej samej firmy, w którym model sam czyta i zmienia kod projektu. Do tego dochodzi pętla, która wznawia go po każdym zatrzymaniu.
Moim zdaniem ta liczba jest mniej ciekawa niż dwie rzeczy, które autorzy mierzą obok niej. Jedna dotyczy tego, jak agent planuje kolejność pracy, druga tego, ile po drodze psuje.
Od warstwy wokół modelu do pętli wokół agenta
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.