Analiza / Opinia
Agenty lepiej łatają cudzy kod, niż dopisują brakującą funkcję
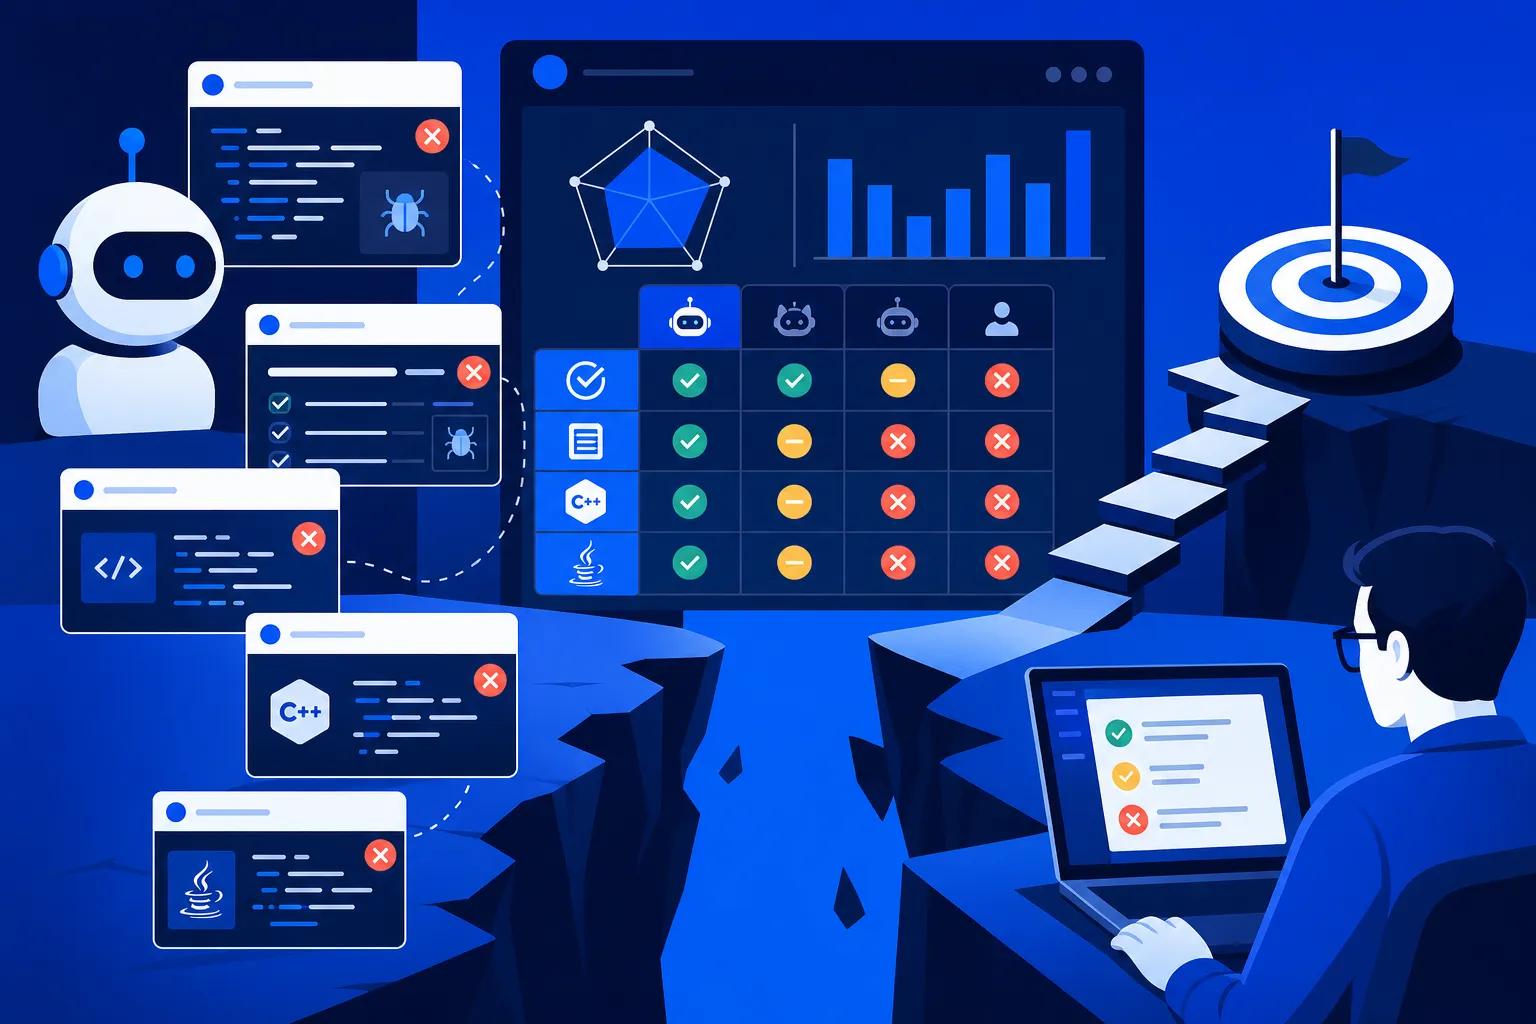
Claude Opus 4.5 zamyka 74,4% zadań na SWE-bench, a na nowym benchmarku FeatureBench dowozi 11%, choć model jest ten sam i zmieniło się tylko to, o co go poproszono. Qixing Zhou i współautorzy, w pracy zgłoszonej na ICLR 2026, wycięli z 24 repozytoriów open-source kod stojący za wybranymi testami, tak że agent ma odtworzyć brakującą funkcję bez wskazanego miejsca i bez gotowych granic zmiany. Agenty domykają pętlę, którą ktoś już otworzył i opisał, a dużo gorzej radzą sobie z wykrojeniem zadania od zera. Ostrożnie z tą liczbą, bo trudność dziur ustawia sam twórca benchmarku.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Analiza / Opinia · 3 min ·
Zespół, który wypuszcza nowy benchmark, zwykle pokazuje, jak wysoko sięgają na nim modele. Autorzy FeatureBench pokazali coś odwrotnego: Claude Opus 4.5, ten sam model, który zamyka 74,4% zadań na SWE-bench, dowozi u nich 11%. Qixing Zhou i jego współautorzy zgłosili tę pracę na ICLR 2026, jedną z głównych konferencji o uczeniu maszynowym, a cała jej siła bierze się z tej jednej różnicy, bo między dwoma wynikami nie zmienił się model, tylko to, o co go poproszono.
Żeby ta różnica coś znaczyła, trzeba wiedzieć, co właściwie mierzy SWE-bench, bo przez ostatnie lata to on wyznaczał, co znaczy "agent programistyczny działa". SWE-bench bierze prawdziwe zgłoszenie błędu z repozytorium na GitHubie i dokłada test, który po dobrej poprawce ma przejść. Agent dostaje więc zadanie już zlokalizowane, zwykle zamknięte w jednym pull requeście i w kilku plikach, z gotową linią mety. To naprawianie czegoś, co poza jednym miejscem działa.
Jak powstaje jedno zadanie
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.