Poradnik / Praktyka
Czy trzy LLM-y naprawdę wygrały Kaggle? Tylko w trybie Playground.
GPT-5.4 Pro, Gemini 3.1 Pro i Claude Opus 4.6 wygrały zawody Kaggle o przewidywanie odpływu klientów telekomu — 150 modeli wybranych z 850 eksperymentów, złożonych w stos. NVIDIA opisuje to jako triumf trójki agentów na jej GPU z cuDF i cuML, ale przemilcza dwie rzeczy: że "Playground" to seria edukacyjna bez medali i nagród, oraz że za sterami siedzi Grandmaster decydujący, którą hipotezę puścić dalej. Przepis jest realny dla problemów tabelarycznych, lecz bez człowieka u steru 850 iteracji zamienia się w losowe obroty.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Poradnik / Praktyka · 3 min ·
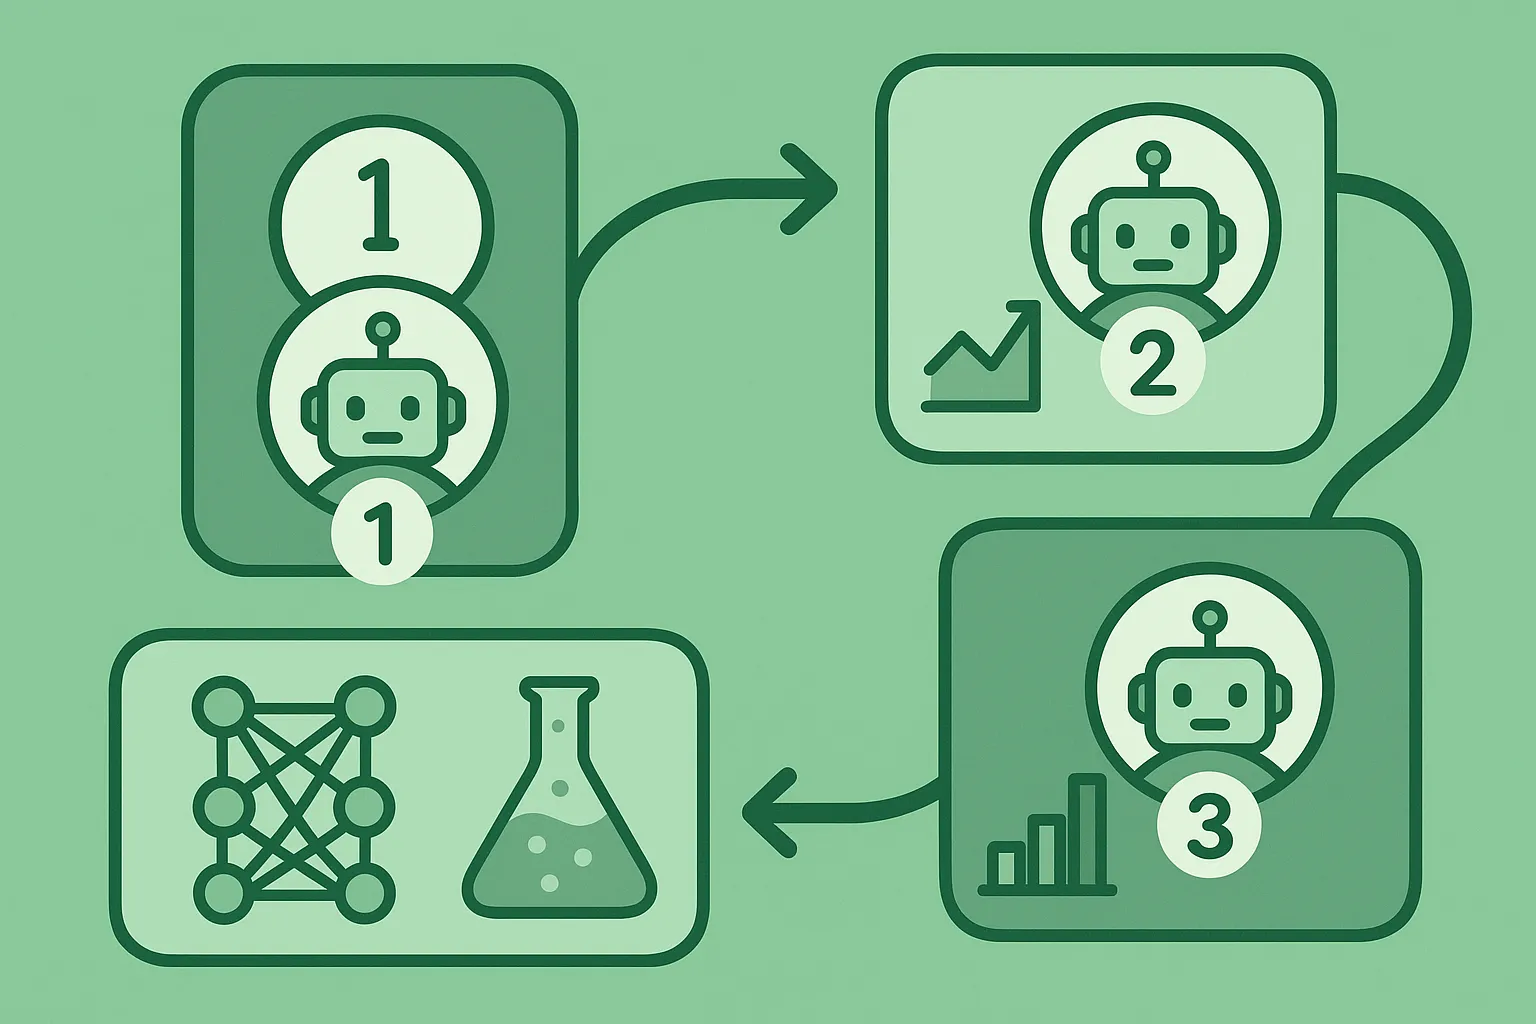
Trzy duże modele językowe wygrały zawody Kaggle Playground o przewidywanie odpływu klientów telekomu. Pierwsze miejsce zbudowane jest na 150 modelach, wybranych z 850 eksperymentów. Notatka na blogu NVIDII tłumaczy, jak GPT-5.4 Pro, Gemini 3.1 Pro i Claude Opus 4.6 razem dochodzą do takiego wyniku. Czytam ją z dwoma pytaniami: ile tu jest powtarzalnego przepisu, a ile niewidocznego know-how, którego notatka nie pokazuje.
Przepis spisany z "Grandmaster Playbook"
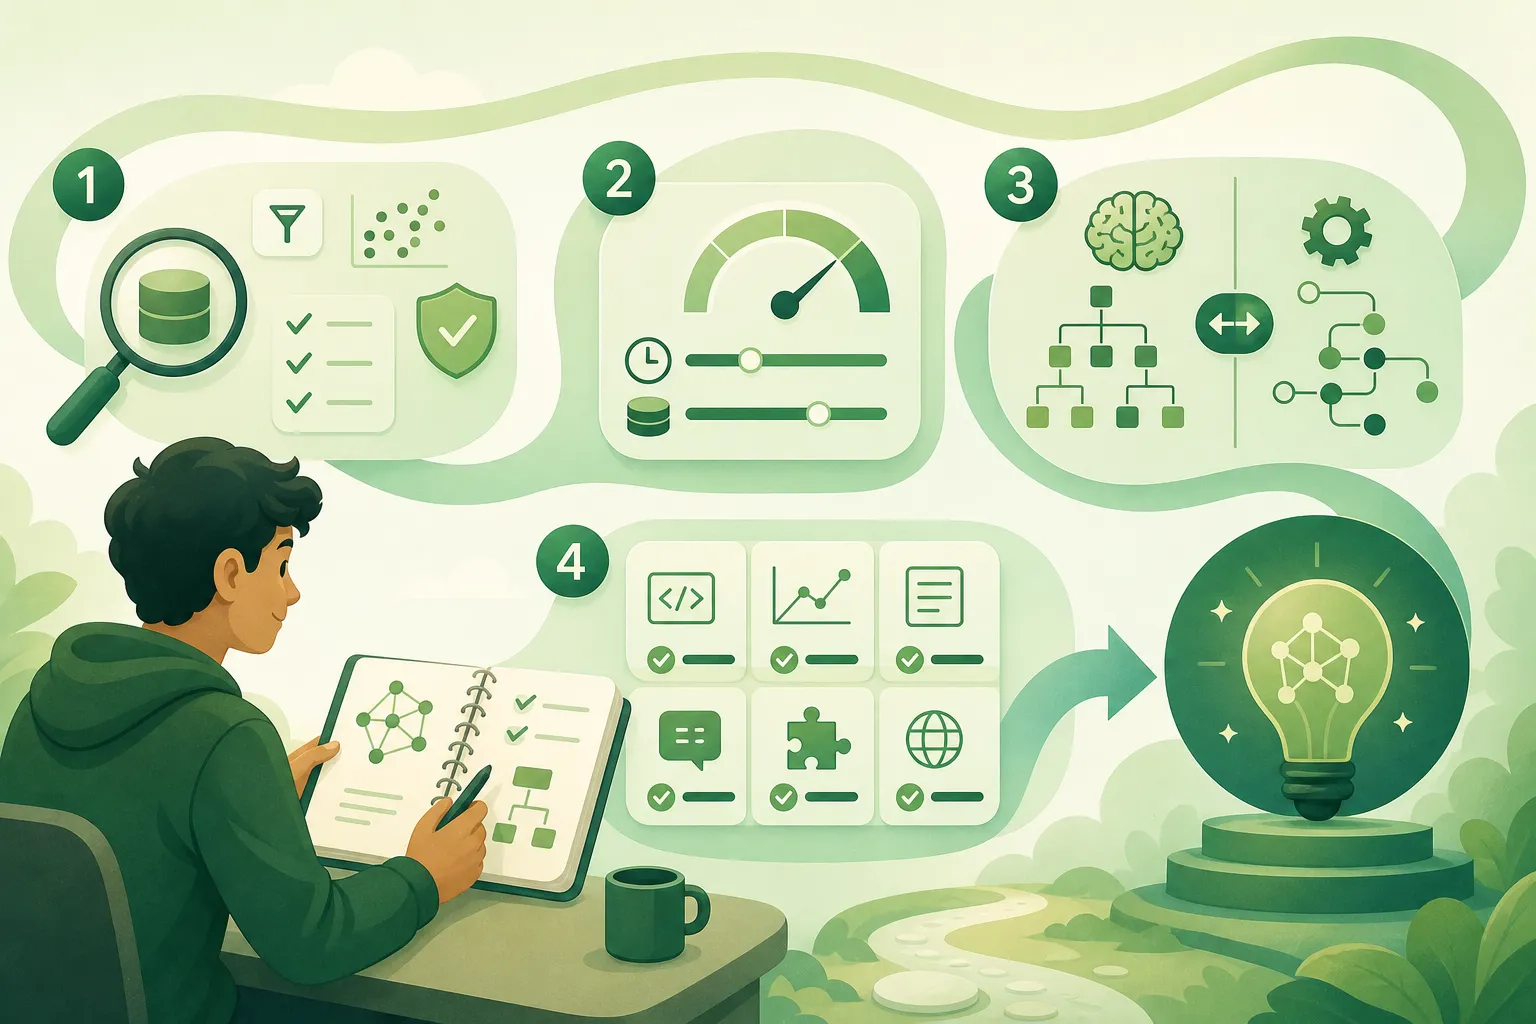
Procedura zaczyna się od luźnego rozeznania w danych: ile wierszy, jakie kolumny, co jest celem, gdzie braki. Potem agenty trenują pierwsze proste modele typu XGBoost, dzieląc dane na kilka równych fragmentów. Każdy fragment po kolei pełni rolę zbioru testowego, a model trenuje się na pozostałych, dzięki czemu wynik nie zależy od jednego losowego podziału. Następnie inżynieria cech: agent dostaje pomysł albo sam go wymyśla, pisze nowy wariant kodu, zapisuje predykcje na dysku. I tak setki razy. Na końcu wciska tę kolekcję w jedną odpowiedź. Jeden model uczy się na predykcjach poprzednich, drugi destyluje z nich wiedzę, kolejny łączy je w finalny stos.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.