Model / Badania
Dlaczego otwarty GLM-5.2 tak dobrze pisze kod? Zhipu uchyla przepis
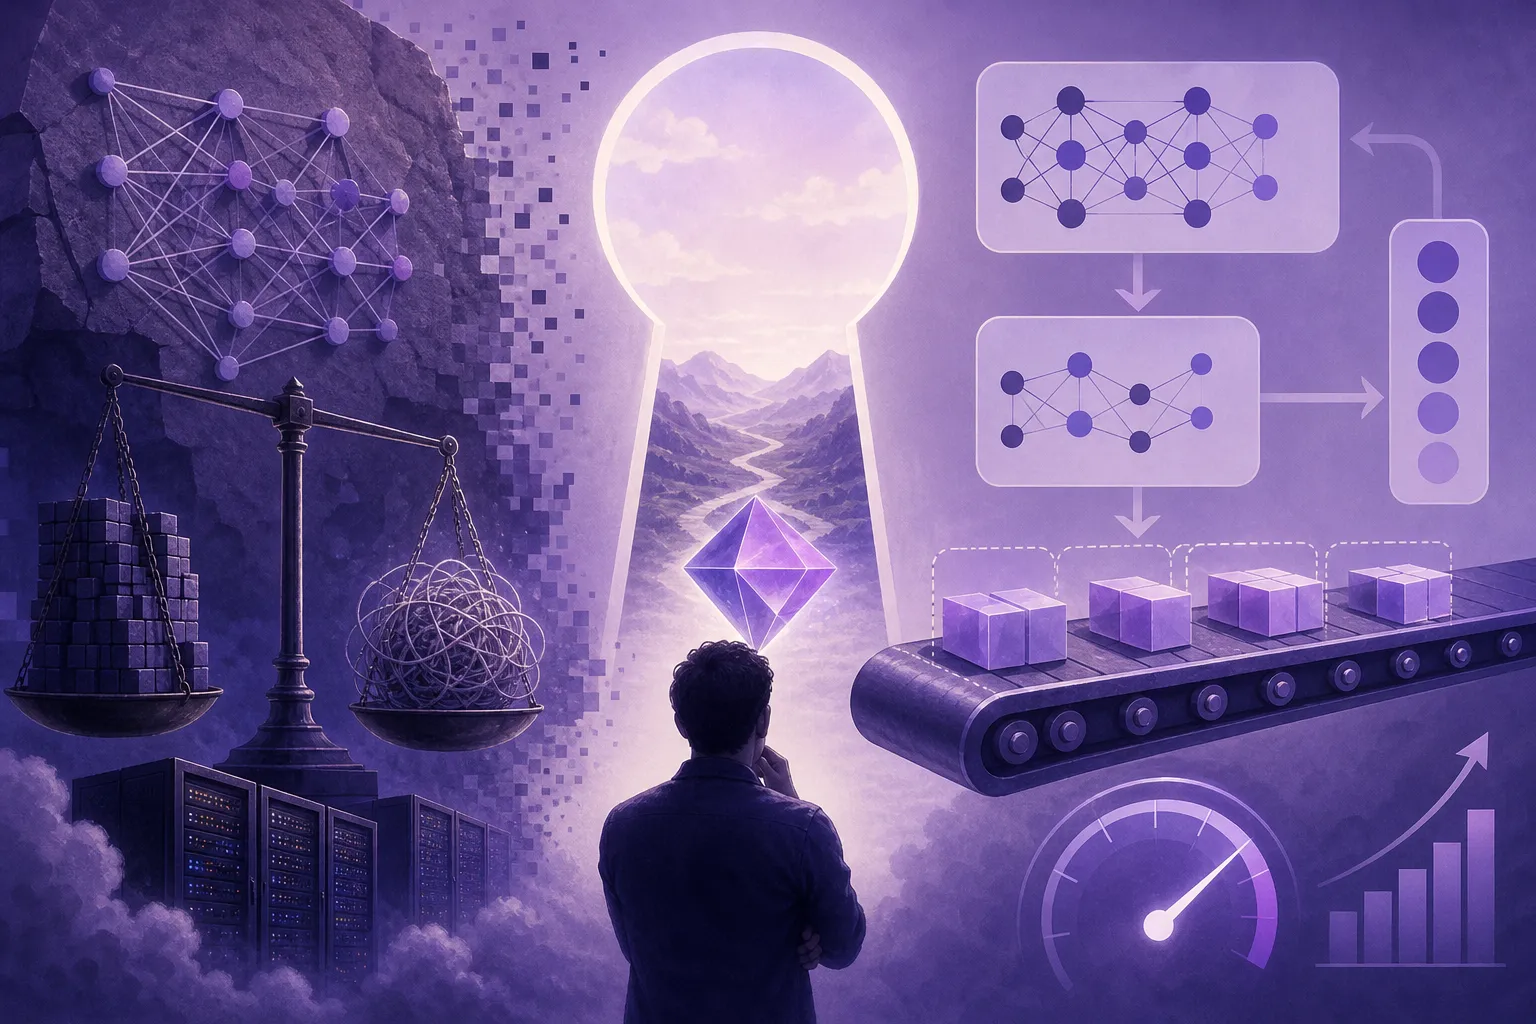
Zhipu AI opublikowało na arXiv pracę opisującą SAO, metodę trenowania przez uczenie ze wzmocnieniem, która stoi za dobrymi wynikami otwartego modelu GLM-5.2 na zadaniach kodowania. SAO rezygnuje z grupowego porównywania prób znanego z GRPO, bierze jedną próbę na zadanie i wraca do osobnego modelu wartości, dzięki czemu asynchroniczne trenowanie ma być stabilne i lepsze niż GRPO na benchmarkach kodowania. Autorzy nie podają jednak liczb ani marginesu przewagi, a nikt z zewnątrz wyników nie odtworzył. Najciekawsze jest to, że chińska firma w ogóle wyłożyła swój przepis na RL.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Model / Badania · 3 min ·
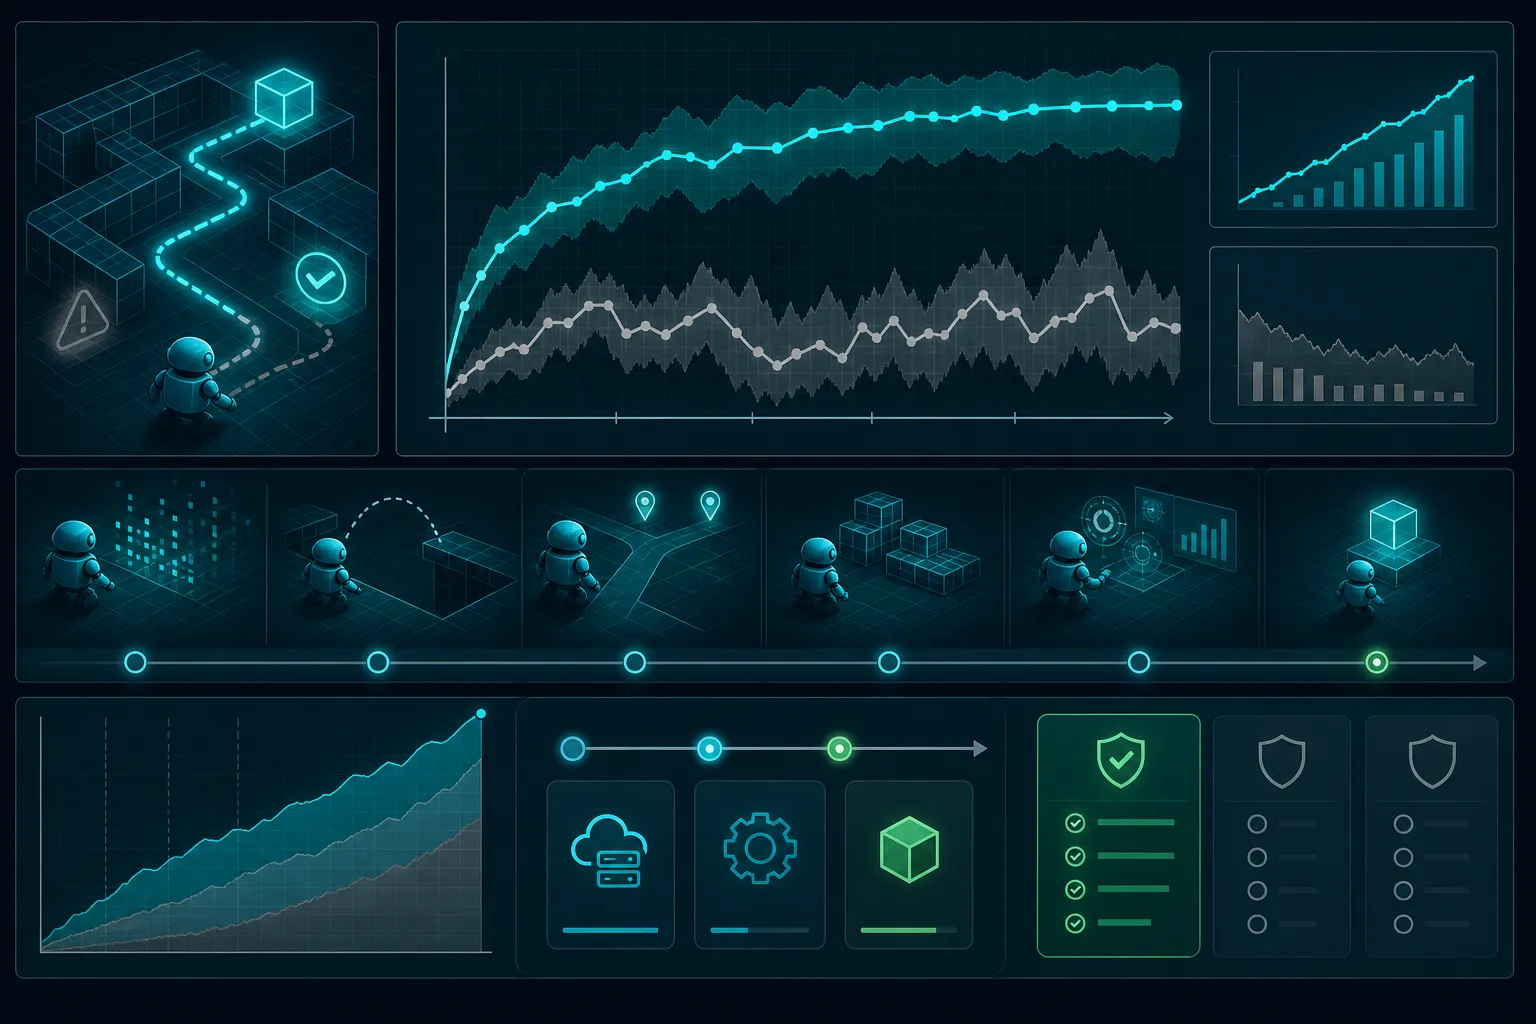
GLM-5.2 na benchmarkach kodowania depcze Claude'owi po piętach, a do tego ma otwarte wagi i spokojnie możecie go dziś użyć przez API. Zespół Zhipu AI, który za nim stoi, opublikował właśnie na arXiv pracę opisującą metodę, którą go wytrenował. Nazwali ją SAO. To jeden z tych tematów, które brzmią jak czysta hydraulika, a jednak mówią coś konkretnego o dwóch rzeczach: dlaczego ten model tak dobrze radzi sobie z naprawianiem błędów w cudzym repozytorium i dlaczego chińska firma w ogóle wykłada swój przepis na trenowanie, zamiast trzymać go dla siebie.
Duże modele po wstępnym trenowaniu douczają się przez uczenie ze wzmocnieniem, w skrócie RL: model dostaje zadanie, próbuje je rozwiązać, a za dobre rozwiązanie dostaje nagrodę, która popycha go w tę stronę. Przy krótkich pytaniach idzie to gładko, bo pojedyncza próba trwa moment. Gorzej przy zadaniach agentowych, gdzie model musi wykonać kilkanaście kroków po kolei: uruchomić kod, przeczytać komunikat o błędzie, poprawić, spróbować jeszcze raz. Jedna taka próba potrafi się ciągnąć, a klasyczne trenowanie każe czekać, aż zbierze się cała paczka prób, zanim zaktualizuje model. Przy długich zadaniach to zwyczajne marnowanie czasu.
Odpowiedzią był asynchroniczny RL: aktualizuj model na bieżąco, w miarę jak spływają kolejne próby, bez czekania na całą paczkę. Jest szybciej, ale wchodzi nowy problem, który według Zhipu uderza akurat w najpopularniejszą dziś metodę, GRPO. GRPO ocenia rozwiązania grupami: puszcza kilka prób na to samo zadanie i porównuje je między sobą, żeby wiedzieć, które wypadły lepiej. Kiedy próby spływają asynchronicznie i w różnym tempie, grupowanie się rozjeżdża, bo część z nich powstała na starszej wersji modelu niż ta, którą właśnie douczamy. Trenowanie robi się niestabilne i potrafi się posypać w połowie.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.