SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Poradnik / Praktyka

Gemma 4 rusza lokalnie na pięć sposobów, a przejście z chmury to jedna linijka

Gemma 4 od Google DeepMind ma już wagi na Hugging Face, a kurs Piyusha Thakura na PyImageSearch pokazuje pięć sposobów odpalenia jej lokalnie: Ollama, llama.cpp, MLX, LM Studio i Transformers.js, w większości bez sieci. Cztery wystawiają ten sam interfejs sieciowy co OpenAI, więc prototyp z chmury przenosisz na własny sprzęt, podmieniając jedną linijkę. Sens to nie sam offline, tylko prywatność danych i brak opłaty za token. Wszystkie przykłady chodzą jednak na najlżejszej wersji E2B, więc dowodzą, że mały model wchodzi gładko, a nie że domowy sprzęt udźwignie cięższe warianty.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Poradnik / Praktyka  ·  3 min  · 
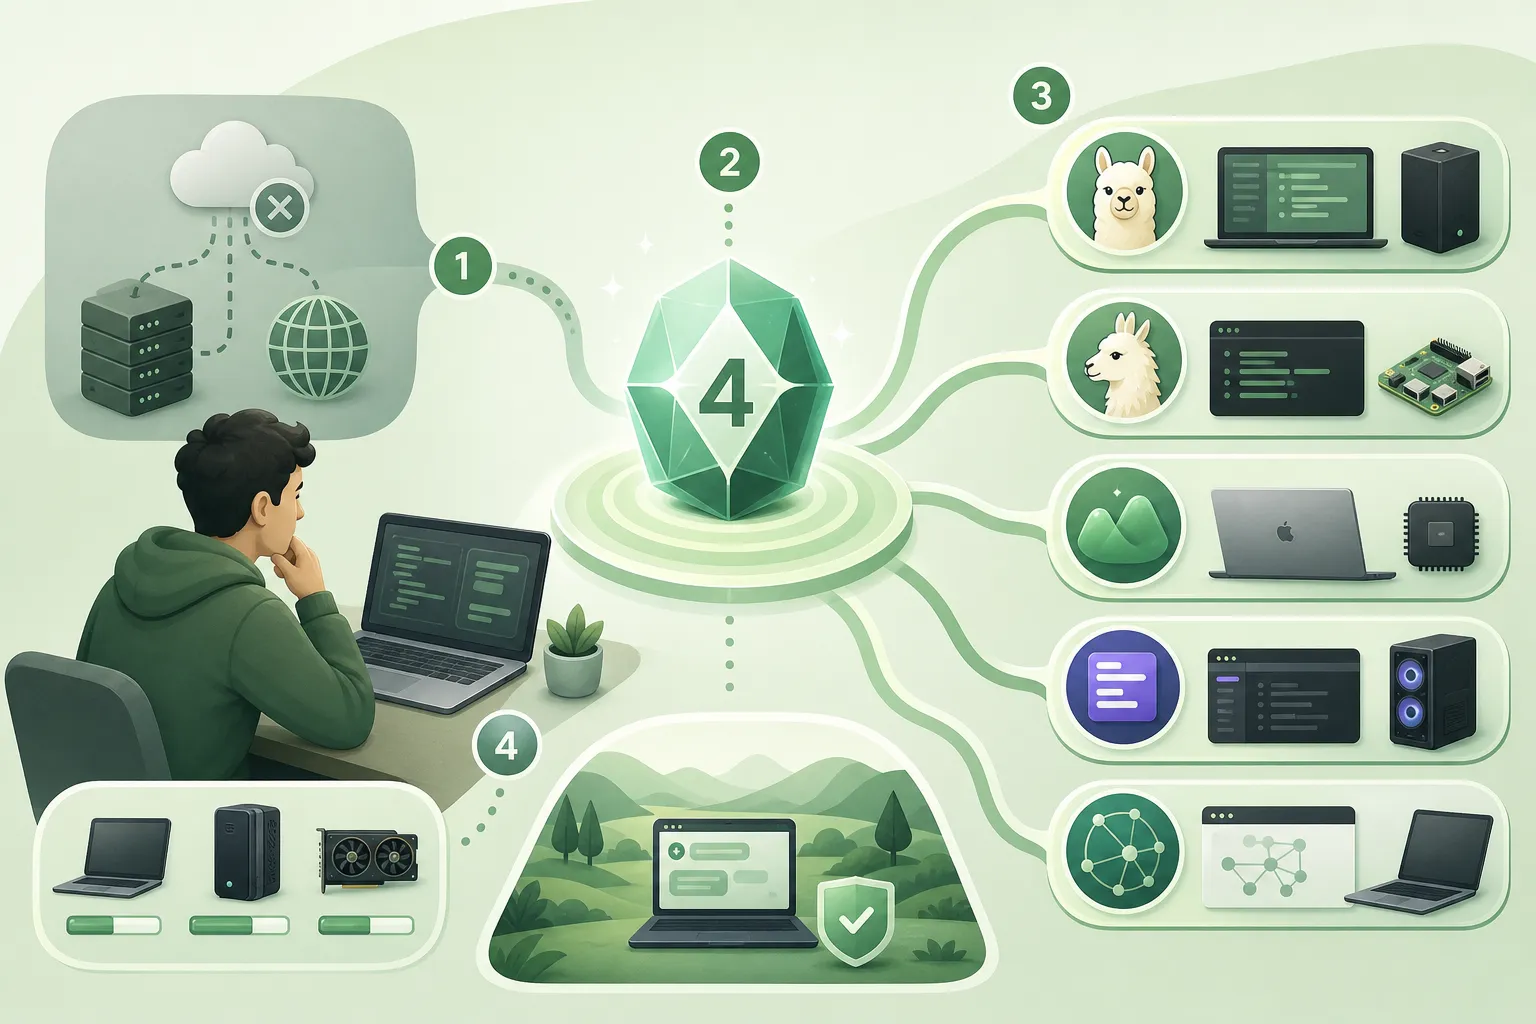
Gemma 4 rusza lokalnie na pięć sposobów, a przejście z chmury to jedna linijka
Ilustrację przygotowała AI.

Na początku lipca Gemma 4 była siedemnastostronicowym raportem na arXiv, bez wag do pobrania i bez jednej liczby z benchmarku. Pisałem wtedy, że to zapowiedź, a nie model, który odpalisz u siebie. Trzy tygodnie później jest inaczej. Wagi leżą na Hugging Face, a Piyush Thakur w trzeciej części kursu na PyImageSearch pokazuje, jak uruchomić model na własnym laptopie na pięć różnych sposobów, całkowicie bez sieci.

Jeszcze niedawno uruchomienie modelu na własnej maszynie oznaczało kompilowanie silnika inferencji, ręczną konwersję wag i sklejanie serwera, który to wszystko obsłuży. Teraz każde z pięciu opisanych narzędzi robi to za ciebie, a cztery z nich wystawiają ten sam interfejs sieciowy, co OpenAI.

Najdobitniej widać to w przykładzie z MLX. Serwer chodzi lokalnie, więc w kliencie OpenAI wpisujesz adres własnego komputera i zmyślony klucz, bo model na dysku nikogo nie sprawdza. Reszta kodu, który wcześniej rozmawiał z modelem w chmurze, zostaje bez zmian. I to jest realna wartość całego zestawu, a nie sam fakt, że model działa offline. Prototyp w chmurze i wersja na własnym sprzęcie potrafią być tą samą aplikacją z jedną podmienioną linijką.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Gemma 4 26B sprawdza się w lokalnych agentach. Google trzyma najszybszą wersję dla siebie.
Poradnik / Praktyka

Gemma 4 26B sprawdza się w lokalnych agentach. Google trzyma najszybszą wersję dla siebie.

4 min

Gemma 4 26B-A4B aktywuje tylko 3,8 miliarda parametrów na token, więc generuje z prędkością modelu 4B, a na AIME 2026 wyciąga 88,3%, punkt poniżej dużo cięższego 31B dense. Sześć specjalnych tokenów do narzędzi wbitych prosto w architekturę robi z niej pierwszy otwarty model, z którym lokalny agent realnie wie, kiedy zawołać funkcję. Tyle że głowice Multi-Token Prediction, dające niemal dwukrotne przyspieszenie, Google zostawił sobie w LiteRT. Wagi na Hugging Face są na Apache 2.0, ale najszybsza wersja zostaje w prywatnym stosie.

Google przerabia Gemmę 4 na model dyfuzyjny, a o cenie za jakość milczy
Model / Badania

Google przerabia Gemmę 4 na model dyfuzyjny, a o cenie za jakość milczy

3 min

Google DeepMind przerobił Gemmę 4 na model dyfuzyjny o nazwie DiffusionGemma, który zamiast pisać słowo po słowie odsłania średnio 20 tokenów na przejście i osiąga około 1500 tokenów na sekundę na jednej karcie H100, wyprzedzając nawet modele ze spekulatywnym dekodowaniem. Pod spodem siedzi wariant mixture-of-experts z 25,2 miliarda parametrów, z których na token aktywuje się tylko 3,8 miliarda. Kłopot w tym, że raport chwali się wyłącznie prędkością i nie podaje żadnej twardej liczby o jakości, zwłaszcza na kodzie.

Gemma 4 obiecuje rozumowanie w małym modelu z otwartymi wagami. Wag i liczb wciąż brak.
Model / Badania

Gemma 4 obiecuje rozumowanie w małym modelu z otwartymi wagami. Wag i liczb wciąż brak.

3 min

2 lipca Google wrzucił na arXiv 17-stronicowy raport zapowiadający Gemmę 4, nową rodzinę modeli z otwartymi wagami od 2,3 do 31 miliardów parametrów, w wariancie gęstym i Mixture-of-Experts. Ciekawie brzmi tryb myślenia w małym modelu, który postawisz u siebie, ale streszczenie nie podaje ani jednej liczby z benchmarku i ani słowem nie wspomina o kodowaniu, więc SWE-bench czy HumanEval tu nie znajdziesz. Wag do pobrania ani API na razie brak, więc to zapowiedź, a nie model, którego odpalisz w edytorze.