Poradnik / Praktyka
Gemma 4 26B sprawdza się w lokalnych agentach. Google trzyma najszybszą wersję dla siebie.
Gemma 4 26B-A4B aktywuje tylko 3,8 miliarda parametrów na token, więc generuje z prędkością modelu 4B, a na AIME 2026 wyciąga 88,3%, punkt poniżej dużo cięższego 31B dense. Sześć specjalnych tokenów do narzędzi wbitych prosto w architekturę robi z niej pierwszy otwarty model, z którym lokalny agent realnie wie, kiedy zawołać funkcję. Tyle że głowice Multi-Token Prediction, dające niemal dwukrotne przyspieszenie, Google zostawił sobie w LiteRT. Wagi na Hugging Face są na Apache 2.0, ale najszybsza wersja zostaje w prywatnym stosie.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Poradnik / Praktyka · 4 min ·
Adam Conway z XDA testuje Gemmę 4 od pierwszego dnia i z czterech modeli, które Google wypuścił 2 kwietnia, zostawia jeden: 26B-A4B w wersji Mixture of Experts. To nie jest najmądrzejszy model, jaki ma na dysku. Po prostu ten, do którego sięga, kiedy ma coś do roboty od ręki.
Liczba 26B mówi tyle, co cena katalogowa: tyle waży model na dysku. Sercem sprawy jest 3,8 miliarda. Tyle parametrów aktywuje się na pojedynczy token podczas inferencji. Reszta wag czeka w pamięci jako specjaliści, których model na tym konkretnym wejściu po prostu nie woła. Efekt: w prędkości generowania zachowuje się jak model 4B, jakościowo trzyma się wyższej półki. W Q4_K_M całość zajmuje około 18 GB pamięci, a na AIME 2026 dostaje 88,3%, jeden punkt mniej niż 31B dense, który gra dokładnie w tej samej lidze.
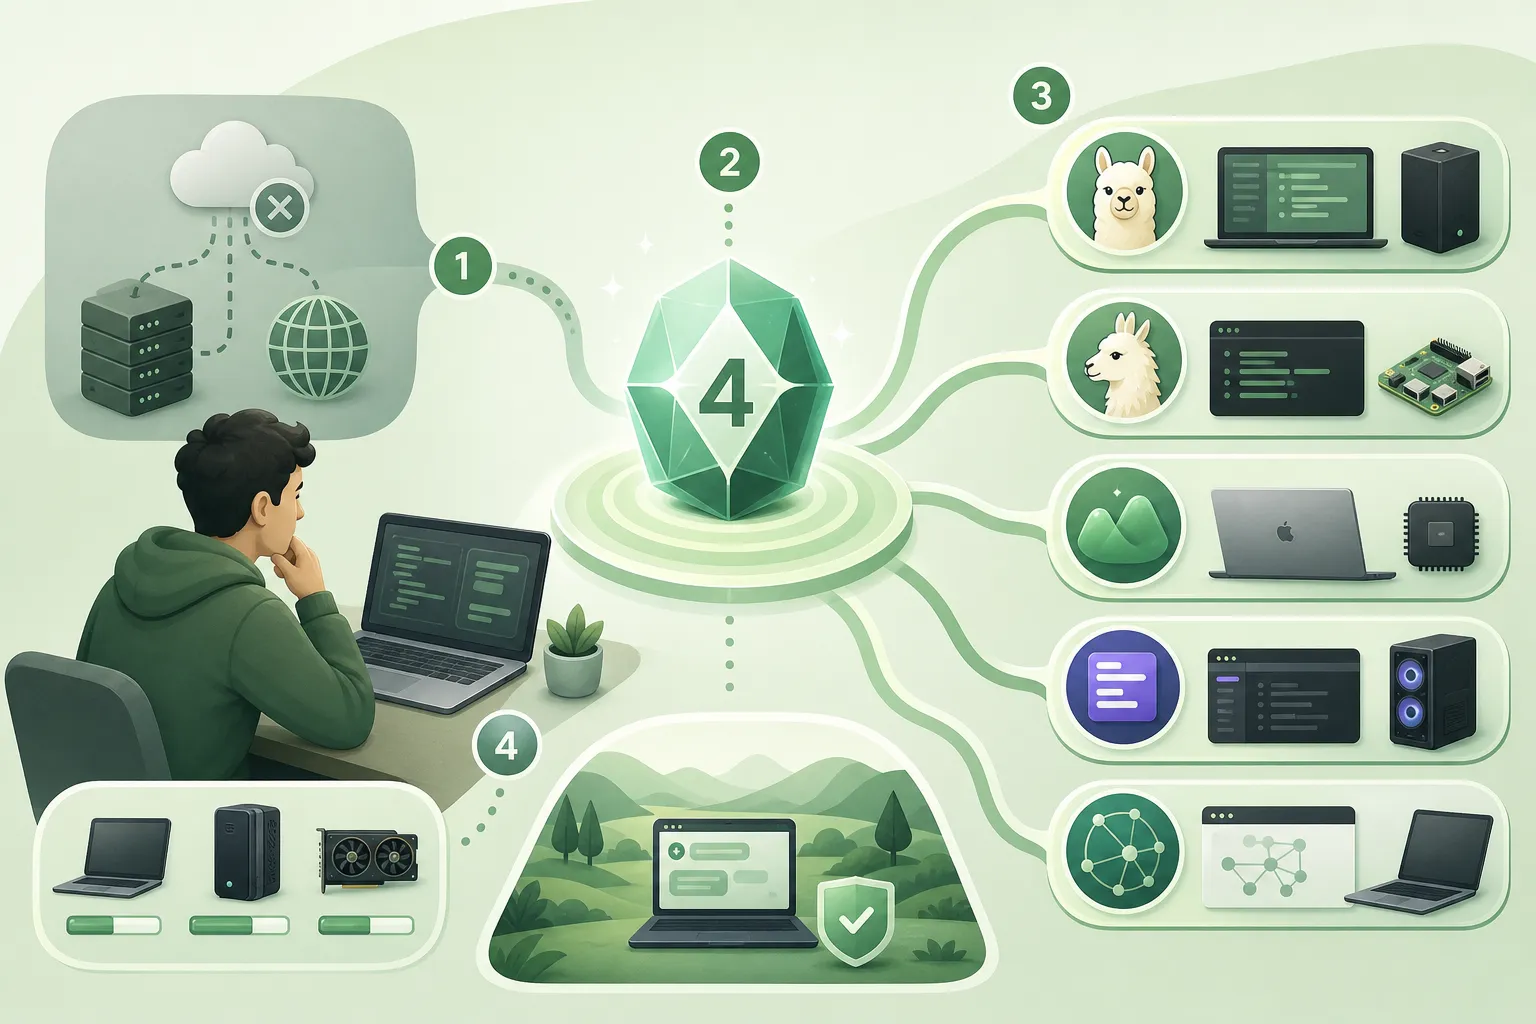
Do tego 256 tysięcy tokenów kontekstu, więc całe repozytorium albo długi dokument idą w jednym promptcie, bez wymyślania strategii dzielenia plików. Wagi pojawiły się od pierwszego dnia w Ollamie, LM Studio, vLLM, llama.cpp i MLX, na licencji Apache 2.0. Konwersji na własną rękę robić nie trzeba.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.