Model / Badania
Google uczy Gemmę pisać całymi blokami i wyciąga z jednej karty 1500 tokenów na sekundę
Google DeepMind opisał 31 lipca DiffusionGemmę, eksperymentalny model, który zamiast pisać token po tokenie bierze cały blok 256 tokenów jako szum i w kilku przejściach wygładza go w tekst. Na jednej karcie H100 daje to około 1500 tokenów na sekundę, bo odsłania średnio 20 tokenów na przejście zamiast jednego. To dostrojona Gemma 4 w wariancie mixture-of-experts, przerobiona na model dyfuzyjny za mniej niż 10% pierwotnego budżetu tokenów i wypuszczona z otwartymi wagami. Tyle że raport chwali się prędkością, a nie podaje ani jednej liczby, ile jakości kosztuje szybki tryb dyfuzyjny.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Model / Badania · 4 min ·
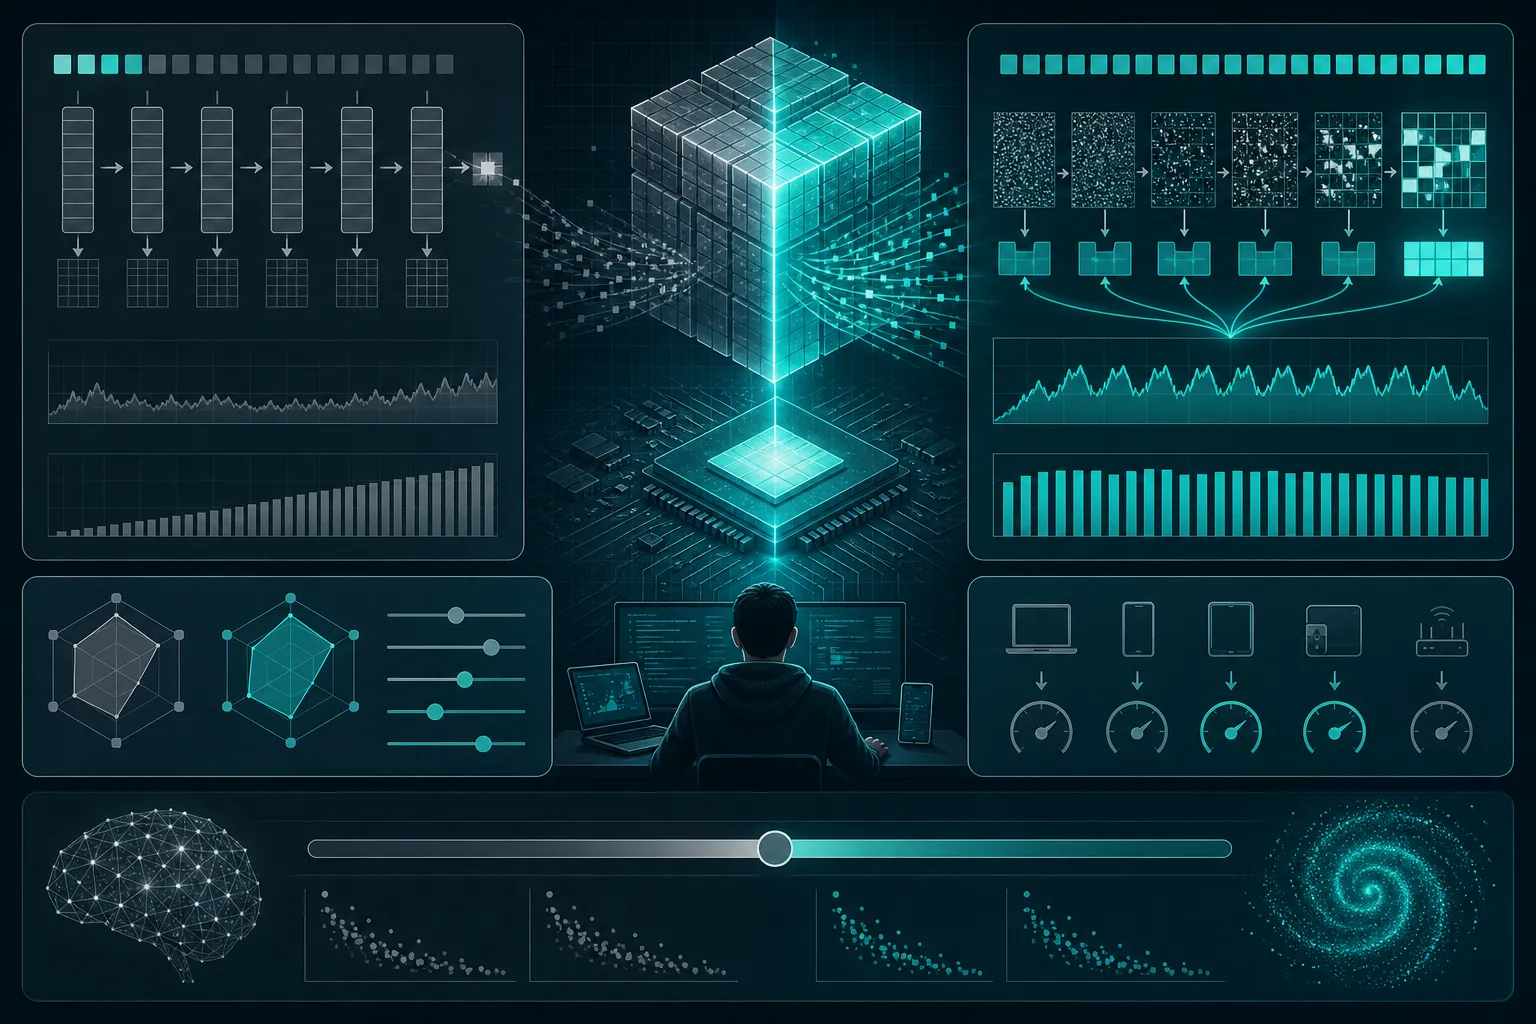
Autoregresyjny model językowy pisze zdanie po kolei, token po tokenie, i każdy następny stawia dopiero wtedy, gdy poprzedni jest już gotowy. Tego porządku nie da się obejść zrównolegleniem, bo setnego tokenu nie policzysz, zanim nie znasz dziewięćdziesiątego dziewiątego. DiffusionGemma, eksperymentalny model opisany 31 lipca w raporcie zespołu Google DeepMind na arXiv, łamie tę zasadę. Zamiast dokładać po jednym słowie, bierze cały blok 256 tokenów naraz jako losowy szum i w kilku przejściach wygładza go w gotowy tekst. To ta sama sztuczka, która stoi za generatorami obrazów: zaczynasz od szumu i krok po kroku go odszumiasz, tyle że na wyjściu jest zdanie, a nie zdjęcie.
Nagrodą jest prędkość, której autoregresja nie dogoni. Model odsłania średnio około 20 tokenów na jedno przejście przez sieć, podczas gdy klasyczny wypluwa dokładnie jeden, więc tych kosztownych przejść potrzeba dwudziestokrotnie mniej. Na pojedynczej karcie H100 przekłada się to na mniej więcej 1500 tokenów wygenerowanych w sekundę. Google zapewnia, że to szybciej niż model autoregresyjny nawet ze speculative decoding, najlepszą dziś sztuczką na przyspieszanie generacji, w której mniejszy model zgaduje kilka tokenów do przodu, a duży tylko sprawdza jego propozycje. Jeśli ta liczba obroni się w niezależnych testach, będzie to pierwszy raz, gdy dyfuzja realnie bije autoregresję na jej własnym boisku, a nie tylko na papierze.
Dla kogoś, kto pisze kod z pomocą modelu, prędkość generacji to nie kosmetyka. Agent, który sam planuje i wykonuje zadanie, odpytuje model dziesiątki razy w jednej pętli, a każda sekunda oczekiwania mnoży się przez liczbę kroków. Podpowiedzi w edytorze muszą zdążyć, zanim zdejmiesz palce z klawiatury, bo inaczej i tak dopiszesz linijkę sam. Tańsza i szybsza generacja przesuwa granicę tego, co opłaca się odpalać lokalnie albo puszczać w tle bez patrzenia na rachunek za tokeny. Dlatego wynik, który realnie obniża koszt generowania tokenu przy znośnej jakości, waży więcej niż kolejny punkt na benchmarku rozumowania.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.