Analiza / Opinia
JetSpec przyspiesza Qwen3 nawet 9,64 raza, ale tylko jeśli sam hostujesz model
JetSpec, praca z końca czerwca, przyspiesza spekulatywne dekodowanie na modelach Qwen3 nawet 9,64 raza, ale ta liczba pochodzi z zadań matematycznych z zestawu MATH-500, czyli najbardziej przewidywalnego przypadku. Na swobodnych rozmowach przyspieszenie spada do 4,58 raza, przy wyniku modelu identycznym co do bitu. Cały zysk trafia jednak tylko do tych, którzy sami hostują Qwen3 na własnych GPU, bo przez API w rodzaju Claude czy GPT nie ma gdzie go podpiąć. Autorzy udostępnili kod i gotowe głowice na GitHubie, więc każdy chętny może sprawdzić te liczby u siebie.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Analiza / Opinia · 4 min ·
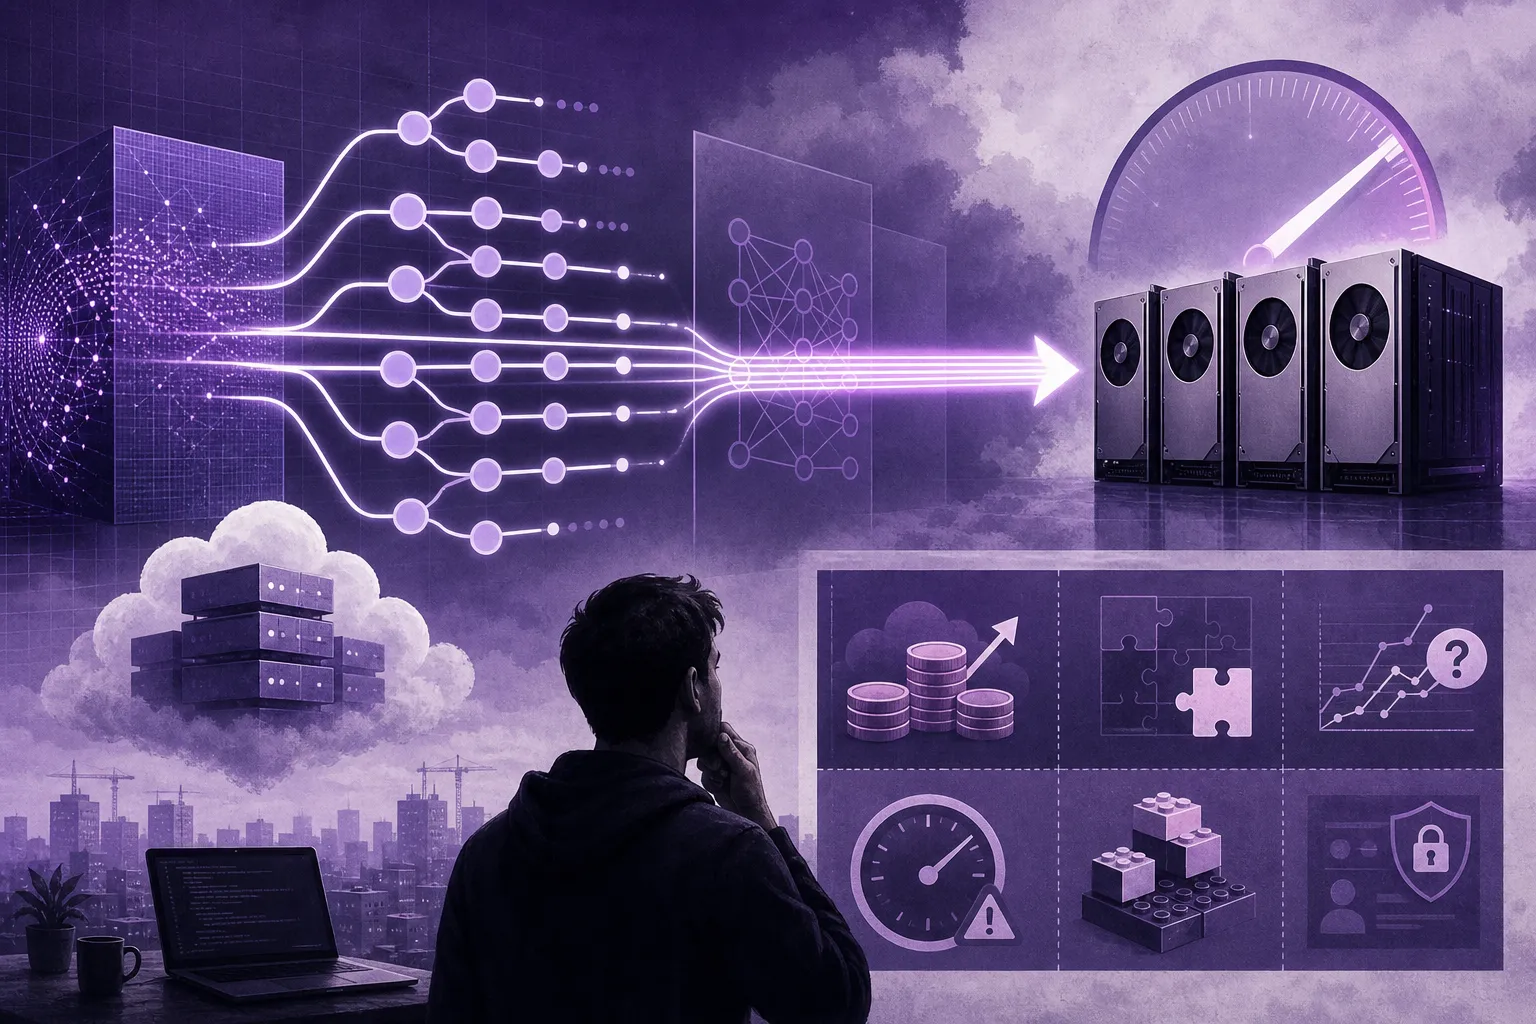
Duży model językowy pisze tekst token po tokenie, a każdy kolejny wyraz wymaga przepuszczenia całych wag od nowa. To właśnie tu leży wąskie gardło inferencji: nie w tym, jak mądry jest model, tylko w tym, że przy każdym słowie musi zaczynać od zera. Spekulatywne dekodowanie obchodzi ten problem prostą sztuczką. Mały, szybki model zgaduje kilka tokenów naprzód, a duży sprawdza całą tę wiązkę w jednym przebiegu. Kiedy zgadza się z domysłem, dostajesz kilka tokenów w cenie jednego przejścia przez model, a wynik jest co do bitu taki sam, jaki wyplułby sam duży model. Przyspieszenie bez żadnej utraty jakości.
JetSpec, praca opublikowana pod koniec czerwca, podbija to przyspieszenie do 9,64x na modelach Qwen3, otwartej rodzinie dużych modeli językowych od Alibaby. Liczba robi wrażenie, ale zanim ktokolwiek zacznie ją cytować na slajdzie: to najlepszy przypadek z możliwych, zmierzony na zadaniach matematycznych. Na rozmowach, czyli tym, co większość aplikacji faktycznie robi, jest to 4,58x. Różnica między tymi dwiema liczbami to właściwie cała historia tej pracy.
Dwie szkoły zgadywania, każda z inną wadą
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.