Poradnik / Praktyka
Rozmiar modelu przestał przewidywać jego prędkość
Model Laguna S 2.1 ma 118 miliardów parametrów, ale generuje tekst szybciej niż czterokrotnie mniejszy Qwen3.6-27B, bo o prędkości decyduje nie całkowity rozmiar, tylko liczba aktywnych parametrów w architekturze MoE. Mori Shige z Classmethod przez pół roku mierzył lokalne modele na DGX Spark i zostały mu z tego dwa odruchy: czytać liczbę aktywnych parametrów zamiast łącznej wagi, a ściągając wersję 4-bitową, sprawdzić dwóch wydawców, bo ta sama kwantyzacja potrafi dać nawet 55% różnicy w prędkości. Dekodowanie spekulatywne podbiło Qwen3.6-35B-A3B o jakieś 40%.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Poradnik / Praktyka · 4 min ·
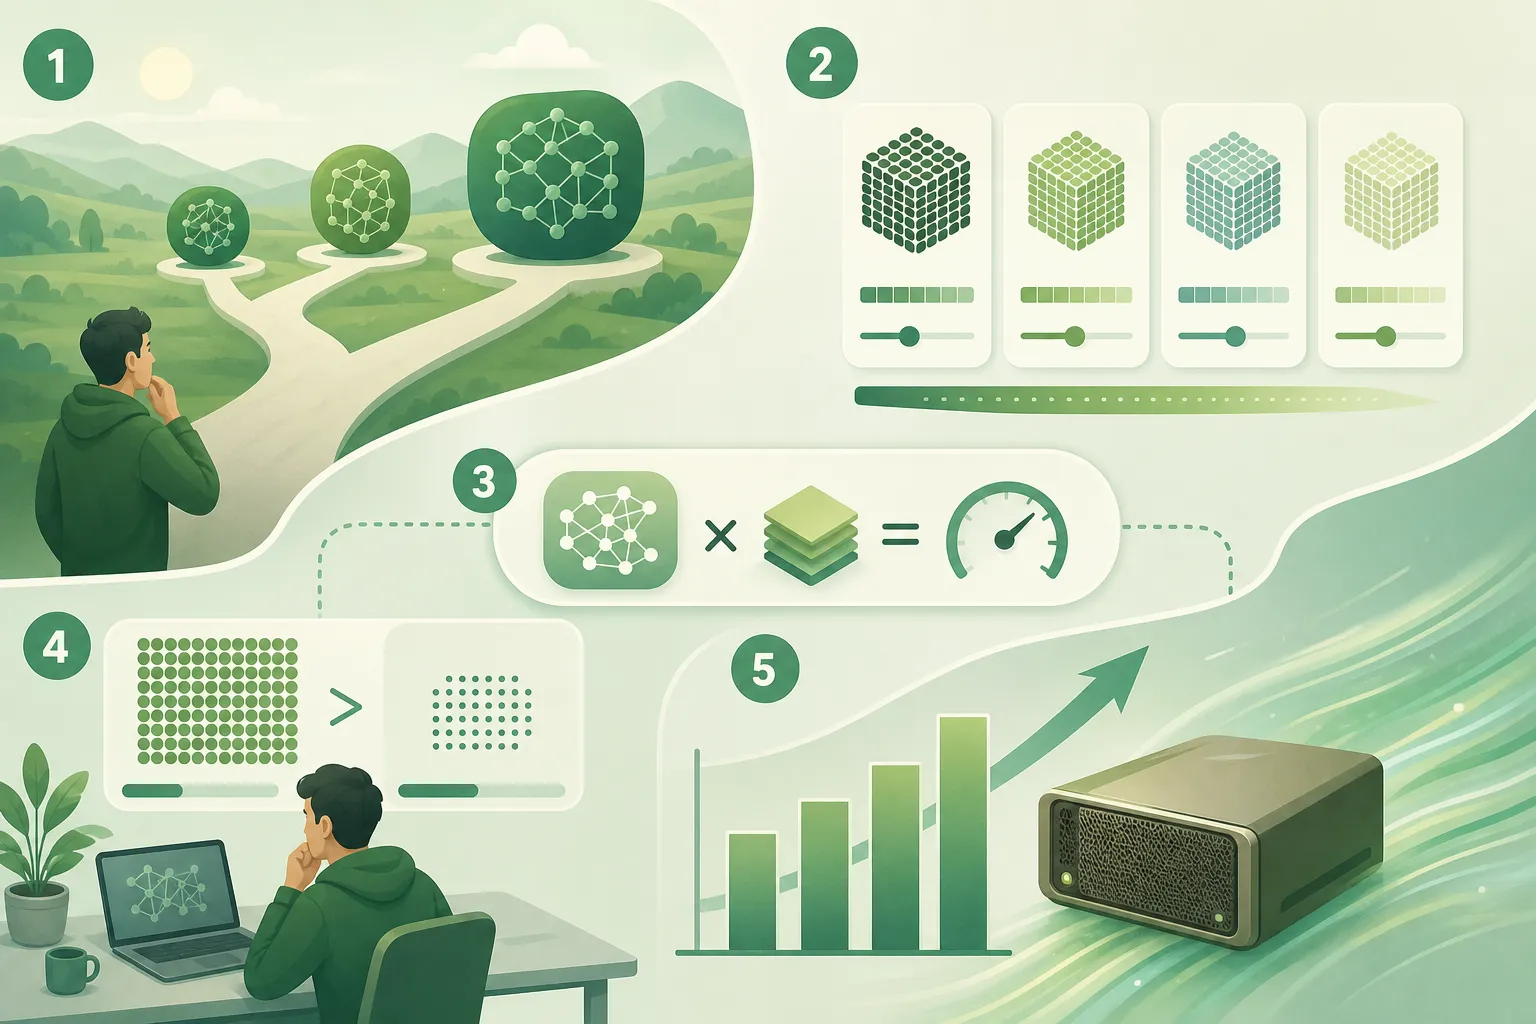
Model Laguna S 2.1 ma na papierze 118 miliardów parametrów i generuje tekst szybciej niż Qwen3.6-27B, model ponad czterokrotnie mniejszy. To nie pomyłka w pomiarze, tylko najkrótszy dowód na to, że dawny odruch, czytanie szybkości modelu z liczby jego parametrów, przestał działać. Mori Shige z Classmethod przez pół roku mierzył lokalne modele na DGX Spark, kompaktowym komputerze NVIDIA do uruchamiania modeli u siebie, i z tych pomiarów wychodzi konkretna zmiana sposobu myślenia.
Prędkość zależy od tego, ile model czyta na jeden token
Laguna z aktywnymi 8,5 miliarda parametrów wykonuje na każdy token mniej roboty niż gęsty Qwen3.6-27B, który przy każdym słowie przelicza wszystkie 27 miliardów. Odpowiada za to architektura MoE, mieszanka ekspertów: model trzyma w pamięci komplet parametrów, ale przy każdym tokenie uruchamia tylko ich wycinek. Zapis 35B-A3B znaczy dokładnie to: całość waży 35 miliardów, a realnie pracują 3 miliardy.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.