Poradnik / Praktyka
Karpathy proponuje wiki, którą pisze i utrzymuje model, nie ty
Andrej Karpathy opisał w zwykłym giście na GitHubie wzorzec "LLM Wiki" jako alternatywę dla RAG: zamiast przeszukiwać surowe dokumenty przy każdym pytaniu, model buduje i sam utrzymuje trwały katalog połączonych plików markdown, kompilując wiedzę raz i tylko aktualizując strony oraz odnotowując sprzeczności. Kluczowy jest schemat w stylu CLAUDE.md, który mówi modelowi, co robić z nowym źródłem. Gist zebrał ponad pięć tysięcy gwiazdek nie dzięki nowej technologii, lecz dlatego, że nazwał coś, co wielu po cichu sklejało, i odpowiada na stare pytanie: kto zniesie nudę utrzymania wiki.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Poradnik / Praktyka · 5 min ·
Andrej Karpathy wrzucił 4 kwietnia zwykłego gista na GitHubie i przez dwa miesiące zebrał pod nim ponad pięć tysięcy gwiazdek i dziesiątki komentarzy, w których ludzie pokazują własne implementacje. Co ciekawe, sam plik nie zawiera ani linijki kodu. To opis wzorca, pomyślany tak, żeby skopiować go do swojego agenta (Claude Code, Codex albo OpenCode, czyli otwartoźródłowy agent kodujący działający w terminalu) i dać mu jako instrukcję. Karpathy nazywa to "LLM Wiki" i pozycjonuje wprost jako alternatywę dla RAG. Skłaniam się ku temu, że gist odbił się tak głośnym echem nie dzięki technologii, której tu nie ma, tylko dzięki nazwaniu czegoś, co większość z nas i tak po cichu sklejała.
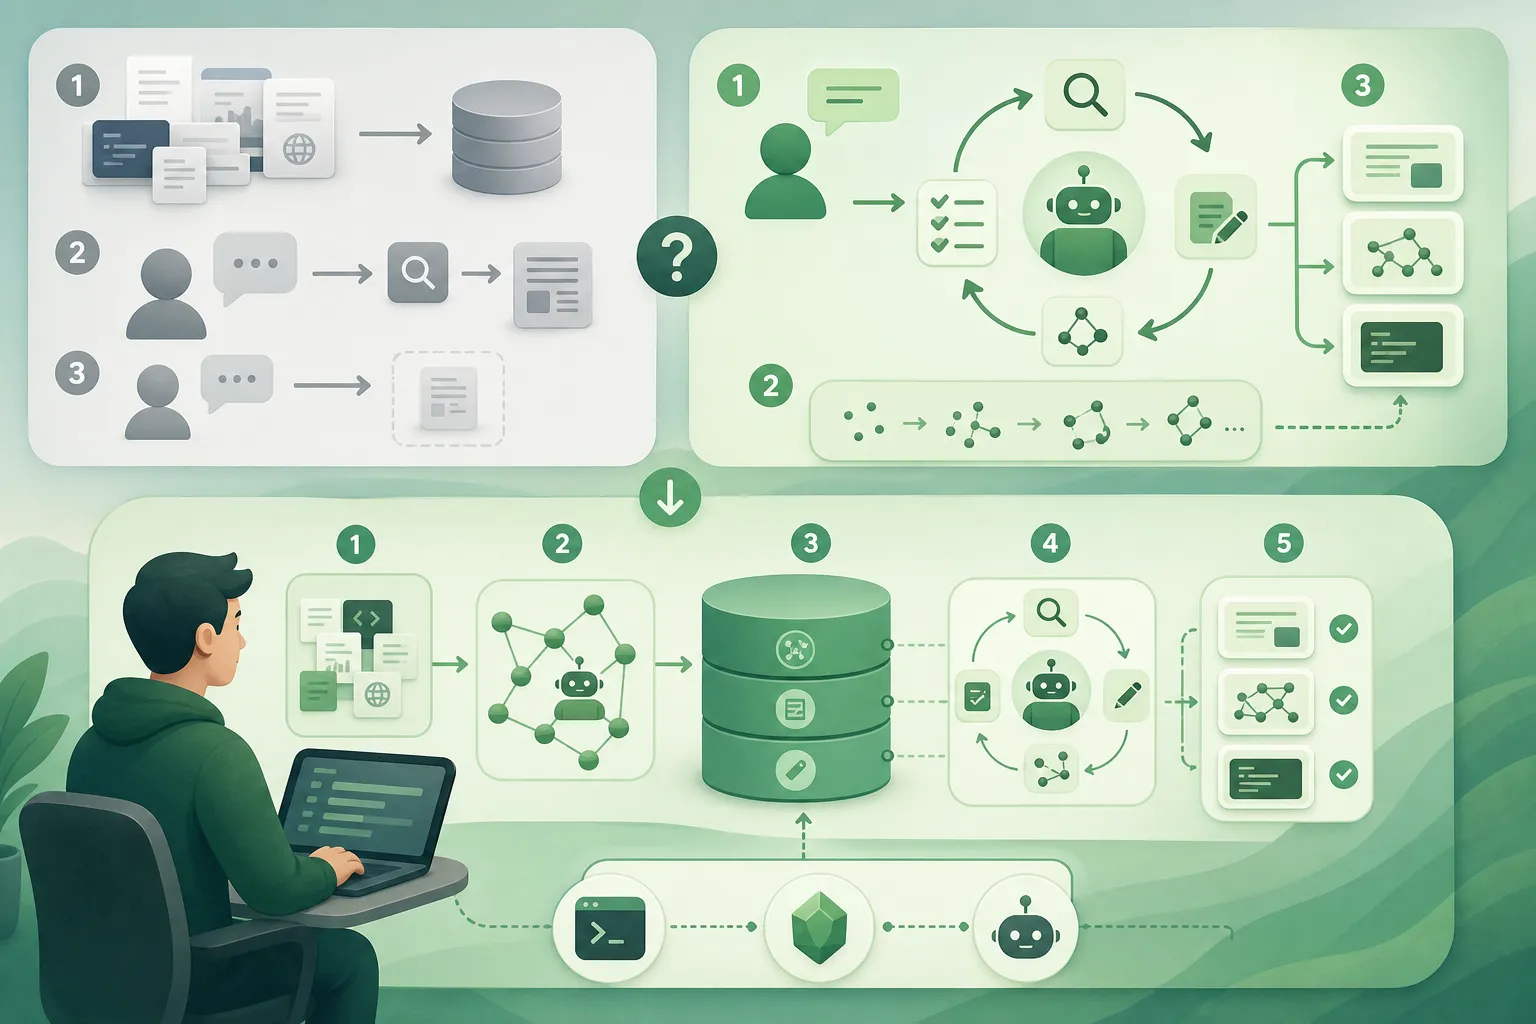
Żeby zobaczyć, na czym polega różnica, trzeba przypomnieć, jak działa RAG. Wrzucasz pliki do NotebookLM albo do czatu i pytasz o ich treść, a model przy każdym pytaniu przeszukuje surowe dokumenty, wyciąga pasujące fragmenty i z nich klei odpowiedź. Działa, ale nic się nie odkłada. Zadasz subtelne pytanie, które wymaga zestawienia pięciu dokumentów, a model za każdym razem od zera szuka i składa te same kawałki, a następnym razem zaczyna od nowa, jakby nigdy wcześniej tego nie robił.
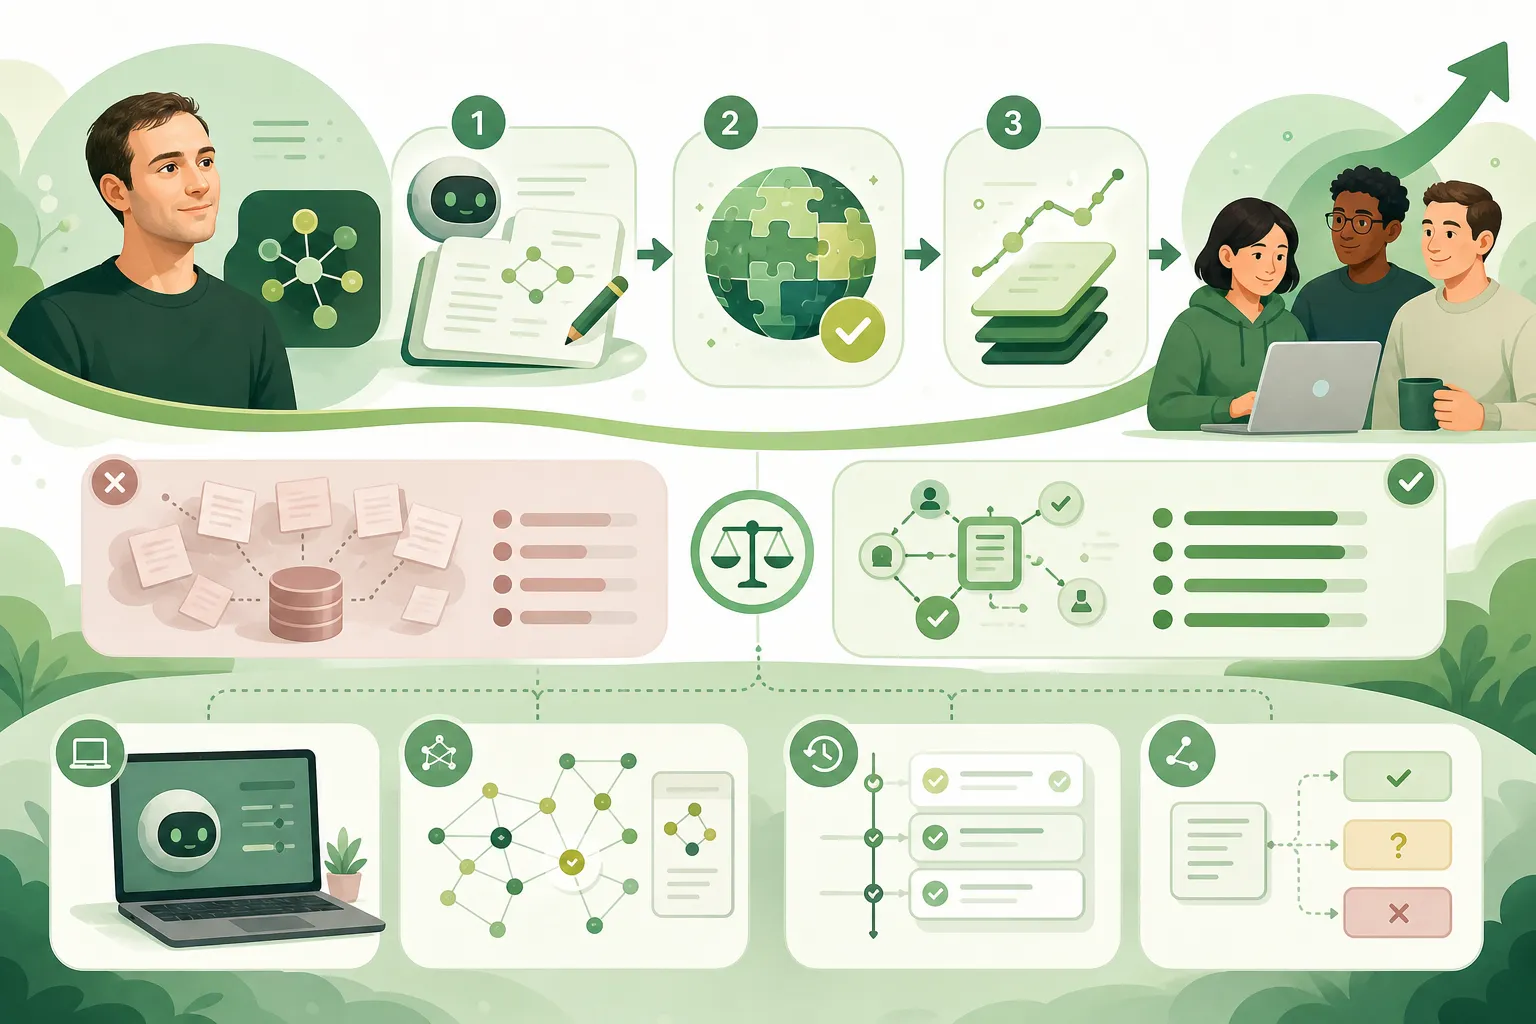
Pomysł Karpathy'ego odwraca ten układ. Zamiast odpytywać surowe źródła przy każdym pytaniu, model buduje i na bieżąco utrzymuje trwałą wiki: katalog połączonych ze sobą plików markdown, który stoi między tobą a źródłami. Kiedy dorzucasz nowe źródło, model nie indeksuje go na potem. Czyta je, wyciąga to, co istotne, i wplata w istniejącą wiki: aktualizuje strony o poszczególnych pojęciach i osobach, poprawia podsumowania, zaznacza miejsca, gdzie nowe dane przeczą staremu twierdzeniu. Wiedza zostaje skompilowana raz, a potem jest tylko utrzymywana w aktualności, a nie wyprowadzana od nowa przy każdym zapytaniu. Z każdym kolejnym źródłem baza staje się bogatsza, bo powiązania, oznaczone sprzeczności i synteza już tam są, zamiast powstawać za każdym razem od pustej kartki.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.