Premiera / Narzędzie
Kiedy naprawdę warto zbudować graf wiedzy zamiast zwykłego RAG-u?
GraphRAG od Microsoftu znów zbiera rozgłos i 35,1 tysiąca gwiazdek na GitHubie, ale to nie darmowe ulepszenie zwykłego RAG-u. Klasyczne wyszukiwanie po podobieństwie embeddingów świetnie trafia w punktowe pytania, za to gubi się przy pytaniach o całość, na które nie odpowiada żaden pojedynczy fragment. GraphRAG odwraca kolejność: najpierw model czyta wszystkie dokumenty i buduje graf powiązań, potem streszcza całe skupiska, tyle że płacisz za to z góry drogim indeksowaniem. Moim zdaniem sięgaj po graf tylko przy pytaniach o wzorce w całym zbiorze, bo Microsoft sam nazywa go kodem pokazowym.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 3 min ·
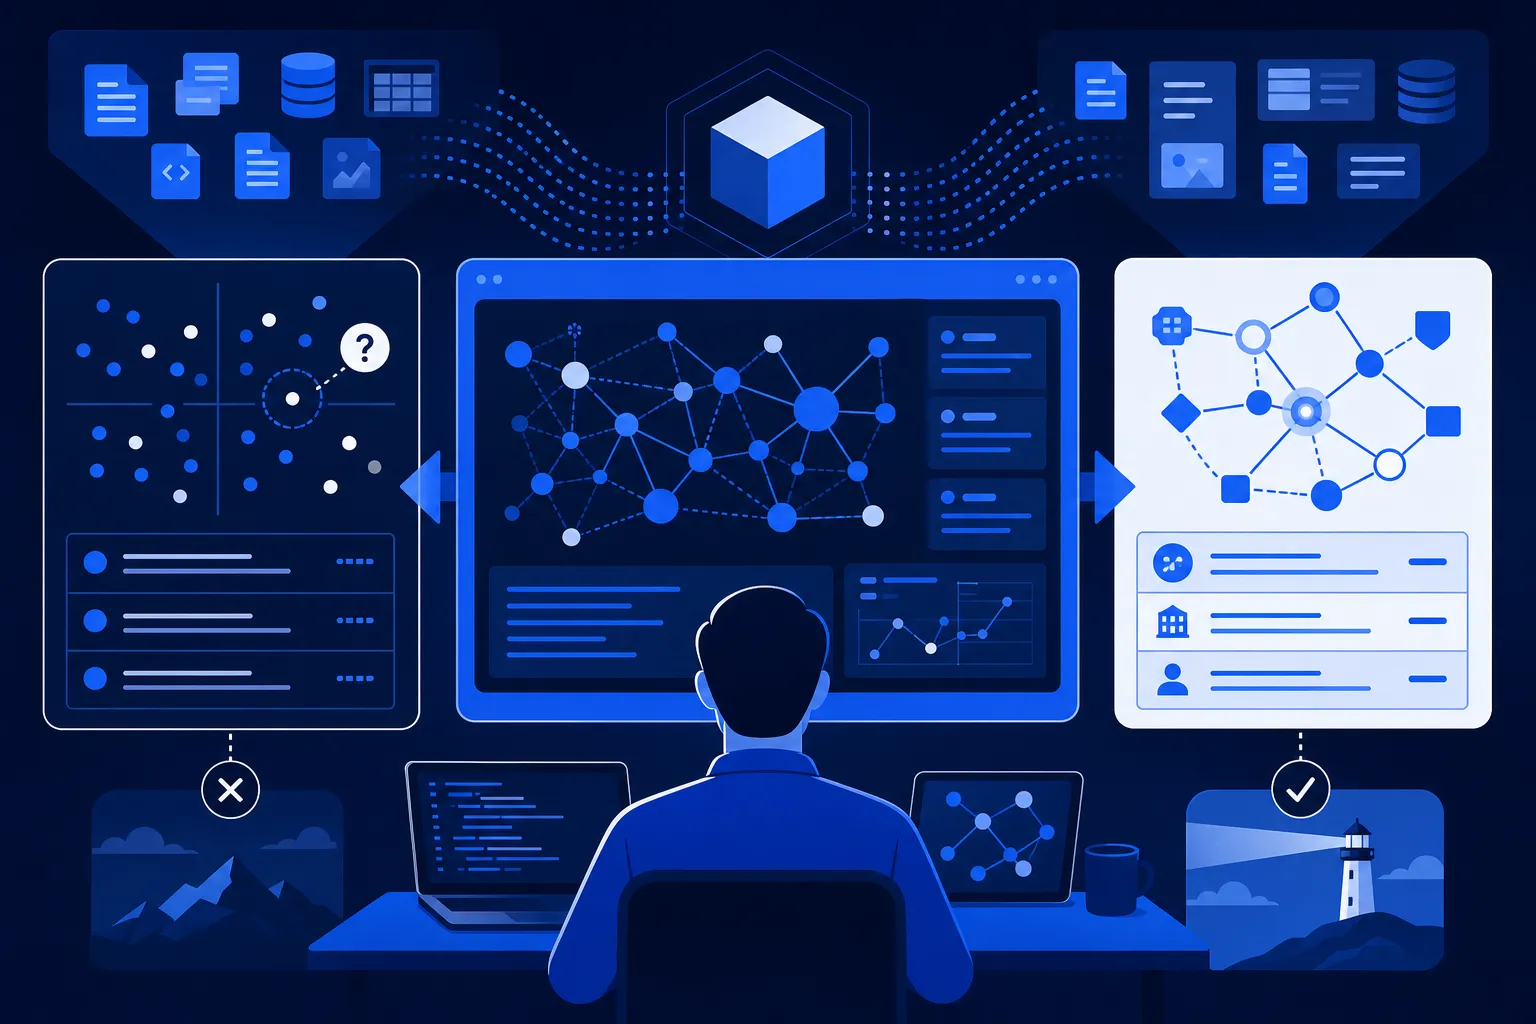
Masz stertę prywatnych dokumentów: firmową wiki, kilka tysięcy zgłoszeń od klientów, umowy, raporty. Chcesz, żeby model językowy odpowiadał na pytania na ich podstawie, bo sam z siebie o twojej firmie nie wie nic. Standardowa odpowiedź na ten problem nazywa się RAG, czyli generowanie wspomagane wyszukiwaniem: zanim model odpowie, system dokleja mu do promptu najlepiej pasujące fragmenty twoich tekstów. GraphRAG od Microsoftu robi to inaczej i właśnie znów jest o nim głośno, bo zebrał 35,1 tysiąca gwiazdek na GitHubie. Od razu powiem, gdzie stoję: to nie jest darmowe ulepszenie zwykłego RAG-u, tylko narzędzie, które zwraca włożony w nie koszt jedynie przy jednym rodzaju pytań.
Gdzie zwykłe wyszukiwanie po podobieństwie się poddaje
Klasyczny RAG zamienia każdy fragment tekstu na ciąg liczb opisujący jego znaczenie, a potem do pytania dobiera te fragmenty, których liczby leżą najbliżej. Te ciągi liczb to embeddingi, na nich stoi całe podejście. Przy wąskich pytaniach sprawdza się to świetnie. Jeśli pytasz "co umowa mówi o wypowiedzeniu", odpowiedź siedzi w jednym akapicie i wyszukiwanie po podobieństwie trafia w niego bez pudła.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.