SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Model / Badania

Kimi K3 na jednym Macu Studio zamiast 64 kart graficznych

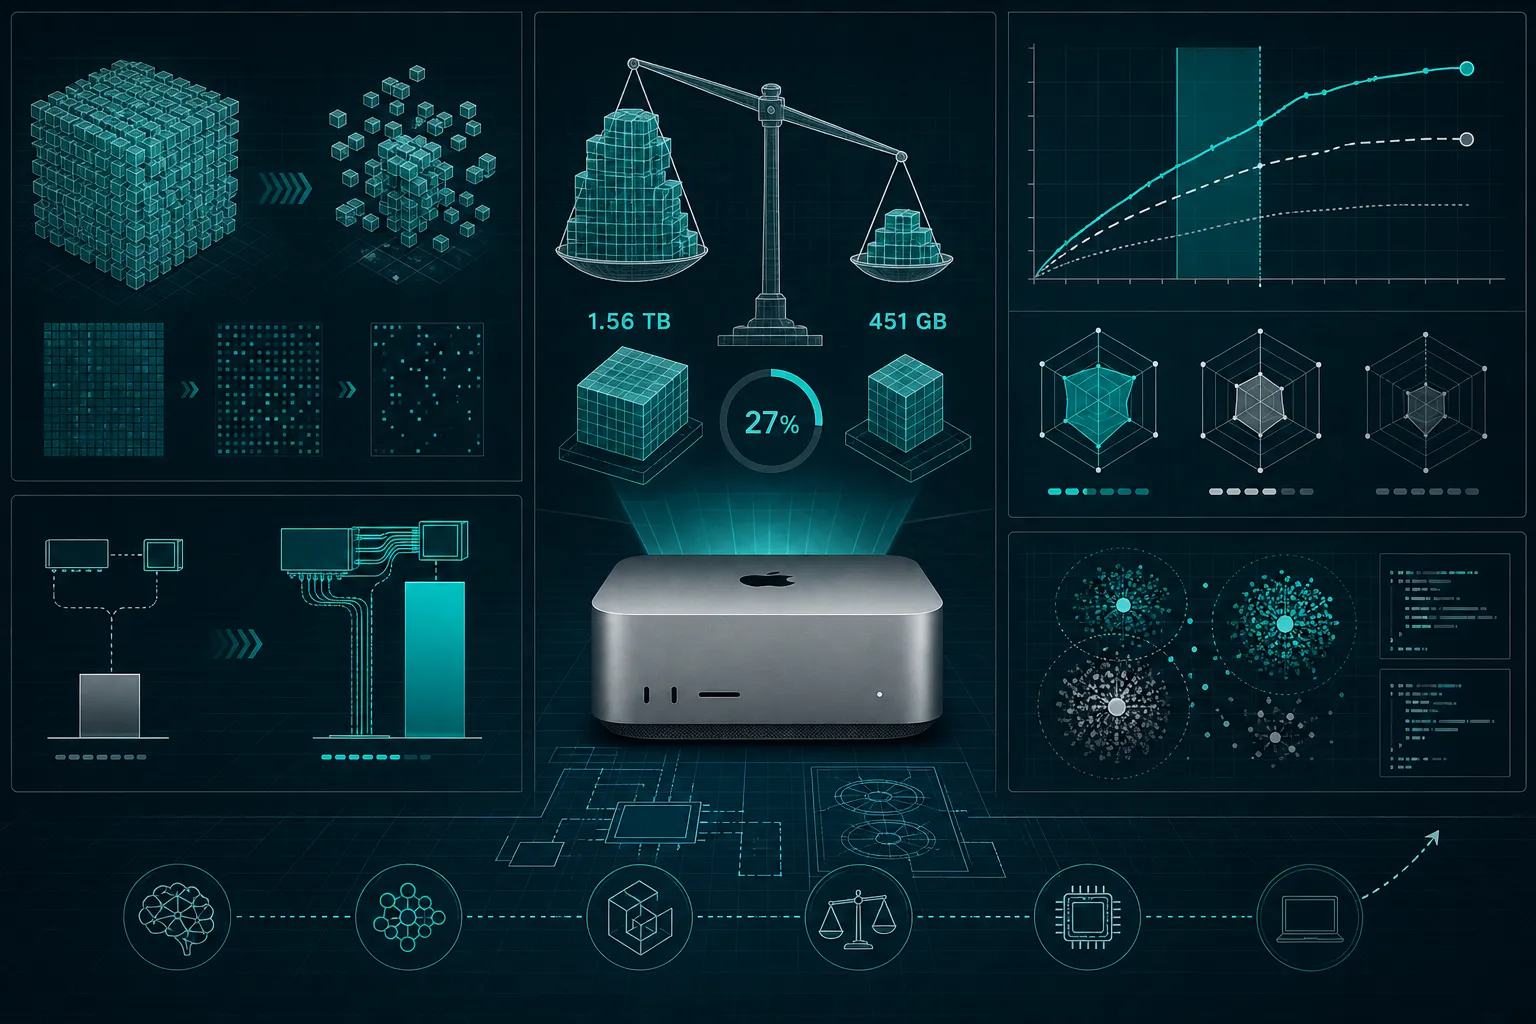
Niezależny projekt PipeNetwork udostępnił wersję chińskiego modelu Kimi K3, która wchodzi na jeden Mac Studio: 451 GB zamiast 1,56 TB, ładowana w 62 sekundy. Sztuczka to metoda REAP od Cerebras, która wycina większość ekspertów mieszanki (z 896 do 242 na warstwę), oszczędzając akurat te od kodu, więc uzupełnianie kodu przechodzi cięcie niemal bez szwanku, choć model częściej gubi wątek. Najciekawsze nie jest jednak samo cięcie, tylko to, że autor złapał własny błąd pomiarowy zaniżający wydajność 39 razy (0,14 zamiast 5,51 tok/s) i publicznie go sprostował.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Model / Badania  ·  3 min  · 
Kimi K3 na jednym Macu Studio zamiast 64 kart graficznych
Ilustrację przygotowała AI.

Kilka tygodni temu pisałem, że żeby postawić Kimi K3 na własnym sprzęcie, trzeba 64 kart graficznych. Teraz autor projektu PipeNetwork udostępnił wersję, która ładuje ten sam model na jednym Macu Studio w 62 sekundy i zajmuje 451 GB zamiast półtora terabajta.

Kimi K3 to chiński model z otwartymi wagami. Problem w tym, że pełny model to 2,78 biliona parametrów, czyli prawie trzy tysiące miliardów, i 1,56 TB na dysku. Nawet dwubitowa kompresja schodzi ledwie do jakichś 870 GB, a Mac Studio kończy się na 512 GB pamięci. Nie mieści się, i to z dużym zapasem.

To, co udostępnił PipeNetwork, nie pochodzi od Moonshota, twórcy modelu, tylko od niezależnego projektu, a cała sztuczka polega na wycięciu większości sieci. Kimi K3 jest zbudowany jako mieszanka ekspertów: zamiast jednej wielkiej sieci ma ich setki, każdy wyspecjalizowany, a pojedynczy token przechodzi tylko przez garstkę z nich. Metoda REAP od Cerebras sprawdza na zbiorze testowym, które eksperty naprawdę się odzywają, i wyrzuca resztę. Z 896 ekspertów na warstwę zostały tu 242, czyli niecałe 27%. Stąd spadek z 1,56 TB do 451 GB, dzięki czemu model wreszcie wchodzi w pamięć Maca. Sam model jest zresztą tak duży, że nie mieści się w pamięci na żadnym etapie, więc nawet jego konwersję trzeba było puścić strumieniowo, kawałek po kawałku.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Kimi K3 zmieścił się w 8 GB RAM-u, ale liczy pół minuty na token Model / Badania

Kimi K3 zmieścił się w 8 GB RAM-u, ale liczy pół minuty na token

5 min

Fareed Khan uruchomił Kimi K3, model Moonshot AI o 2,78 biliona parametrów i 1,56 TB na dysku, na komputerze bez karty graficznej, który zużył 8,24 GB pamięci, bo silnik w przenośnym C99 dociąga potrzebnych ekspertów z dysku warstwa po warstwie. Płaci się za to 32,69 sekundy na token, a dosypanie 28 razy więcej pamięci daje ledwie 70 procent przyspieszenia, bo o tempie decyduje odczyt z dysku. Cenniejsza od samej sztuczki jest ostrożność w pomiarach: przy rozrzucie 33 procent między identycznymi uruchomieniami Khan odrzucił własną optymalizację wartą 5,4 procenta.

Chiński model wygrał ranking kodowania. Co pokazały pierwsze niezależne testy? Model / Badania

Chiński model wygrał ranking kodowania. Co pokazały pierwsze niezależne testy?

5 min

Kimi K3, chiński model z otwartymi wagami, wygrał frontendowy ranking Areny o 48 punktów przed Claude Fable 5, ale pierwsze niezależne testy prostują ten obraz. Jessica Wachtel z The New Stack dała obu to samo zadanie na narzędziu fd: diffy wyszły co do bajta identyczne, tylko K3 kosztował jedną trzecią ceny i był kilka razy wolniejszy, całość zajęła mu 28 minut zamiast siedmiu. Jego wskaźnik halucynacji skoczył za to do 51 procent, a uruchomienie go u siebie wymaga 64 kart graficznych, więc realną alternatywą na dziś zostają GLM 5.2 i DeepSeek V4 Pro.

Qwen3.8 27B mieści się w 17 GB i nie traci na jakości Model / Badania

Qwen3.8 27B mieści się w 17 GB i nie traci na jakości

5 min

Quesma wydała około 3000 dolarów na wynajem kart, żeby zmierzyć, ile pamięci naprawdę potrzebuje Qwen3.8 27B: pełny model w BF16 waży 55 GB, a skompresowany do czterech bitów schodzi do 17 GB i powtarza wynik oryginału na Terminal-Bench 2.1, więc mieści się na RTX 4090 razem z 64 tysiącami tokenów kontekstu. Klif zaczyna się dopiero przy jednym bicie, ale większym problemem jest domyślne ustawienie reasoning_effort na xhigh, przez które Simon Willison czekał 21 minut na prosty rysunek w SVG, a lekarstwem jest jedna linijka z poziomem low.