SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Model / Badania

Kimi K3 zmieścił się w 8 GB RAM-u, ale liczy pół minuty na token

Fareed Khan uruchomił Kimi K3, model Moonshot AI o 2,78 biliona parametrów i 1,56 TB na dysku, na komputerze bez karty graficznej, który zużył 8,24 GB pamięci, bo silnik w przenośnym C99 dociąga potrzebnych ekspertów z dysku warstwa po warstwie. Płaci się za to 32,69 sekundy na token, a dosypanie 28 razy więcej pamięci daje ledwie 70 procent przyspieszenia, bo o tempie decyduje odczyt z dysku. Cenniejsza od samej sztuczki jest ostrożność w pomiarach: przy rozrzucie 33 procent między identycznymi uruchomieniami Khan odrzucił własną optymalizację wartą 5,4 procenta.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Model / Badania  ·  5 min  · 
Kimi K3 zmieścił się w 8 GB RAM-u, ale liczy pół minuty na token
Ilustrację przygotowała AI.

Fareed Khan wpisał w terminalu zdanie "The capital of France is", odczekał ponad cztery minuty i dostał osiem tokenów. Model, który je wypluł, ma 2,78 biliona parametrów i zajmuje na dysku 1,56 TB, a maszyna, która go uruchomiła, zużyła 8,24 GB pamięci i nie tknęła ani jednej karty graficznej.

Mowa o Kimi K3, sztandarowym modelu Moonshot AI z lipca 2026, który normalnie żyje w chmurze, po jakieś 3 dolary za milion tokenów wejściowych. W zestawieniu CloudPrice rubryka z najtańszą instancją zdolną go uruchomić jest pusta, bo w pełnej precyzji model chce około 6 672 GB pamięci kart graficznych. Khan napisał do niego silnik w przenośnym C99: 176 kilobajtów binarki, bez biblioteki do mnożenia macierzy, bez frameworka i bez GPU.

To, że model w ogóle się mieści, robi wrażenie i właśnie dlatego łatwo przeoczyć rzecz cenniejszą. Z tego repozytorium ukradłbym nie sztuczki inżynierskie, tylko sposób, w jaki autor traktuje własne pomiary: najpierw sprawdza, ile jego stanowisko szumi, a potem wyrzuca wyniki, które przez ten próg nie przechodzą. Łącznie z własną optymalizacją.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Kimi K3 na jednym Macu Studio zamiast 64 kart graficznych
Model / Badania

Kimi K3 na jednym Macu Studio zamiast 64 kart graficznych

3 min

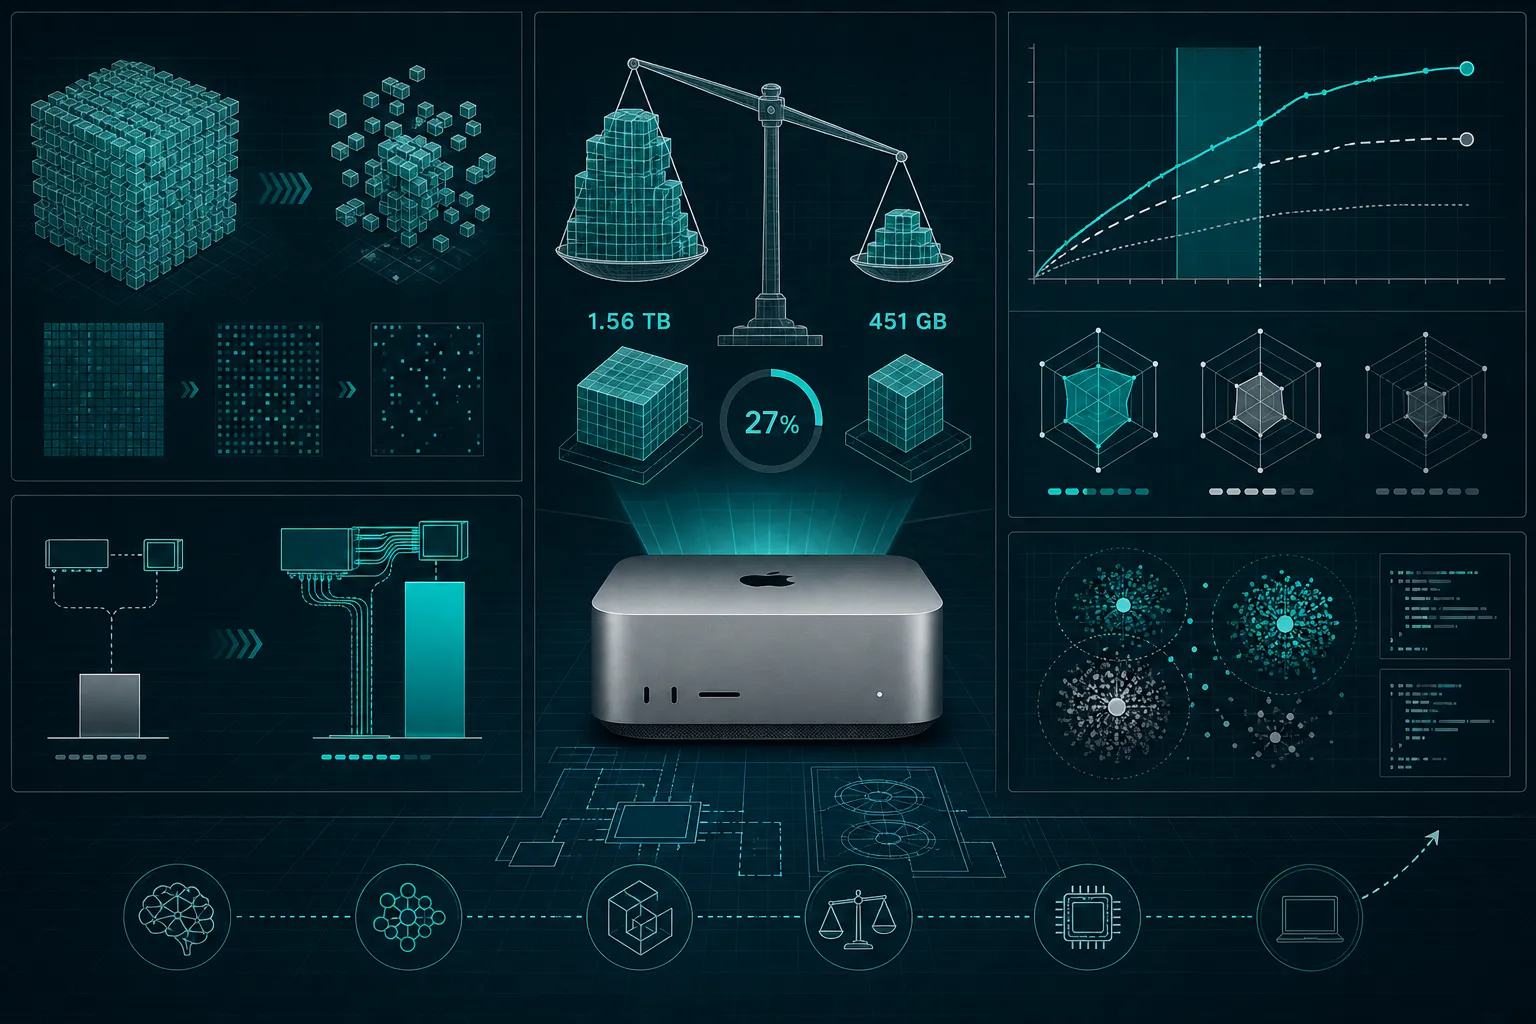
Niezależny projekt PipeNetwork udostępnił wersję chińskiego modelu Kimi K3, która wchodzi na jeden Mac Studio: 451 GB zamiast 1,56 TB, ładowana w 62 sekundy. Sztuczka to metoda REAP od Cerebras, która wycina większość ekspertów mieszanki (z 896 do 242 na warstwę), oszczędzając akurat te od kodu, więc uzupełnianie kodu przechodzi cięcie niemal bez szwanku, choć model częściej gubi wątek. Najciekawsze nie jest jednak samo cięcie, tylko to, że autor złapał własny błąd pomiarowy zaniżający wydajność 39 razy (0,14 zamiast 5,51 tok/s) i publicznie go sprostował.

Kimi K3 prowadzi w kodowaniu i przedstawia się jako Claude
Model / Badania

Kimi K3 prowadzi w kodowaniu i przedstawia się jako Claude

5 min

Kimi K3 od chińskiego Moonshot AI wskoczył na pierwsze miejsce w kodowaniu frontendu, 1679 punktów wobec 1631 dla Claude Fable 5. Liczy 2,8 biliona parametrów, ale dzięki rzadkiej mieszance ekspertów przy każdym tokenie pracuje tylko 16 z 896 podsieci, więc rachunek za inferencję jest bliższy modelowi stumiliardowemu. Ciągnie się za nim zarzut destylacji, bo świeży K3 przedstawiał się jako Claude, a Anthropic oskarża Moonshot o przepuszczenie przez Claude'a 3,4 miliona wymian, choć dla kogoś, kto chce tanio generować dobry kod, otwarte wagi ważą więcej niż pochodzenie trenowania.

Moonshot wypuścił otwarty model agentowy i razem z nim test na to, czy cudze serwery go nie psują
Model / Badania

Moonshot wypuścił otwarty model agentowy i razem z nim test na to, czy cudze serwery go nie psują

4 min

Moonshot AI wydał 21 kwietnia Kimi K2.6 na licencji Modified MIT — otwarty model agentowy z wynikami 58,6% na SWE-Bench Pro i 66,7% na Terminal-Bench 2.0, w cenie 0,60 dolara za milion tokenów wejścia, czterokrotnie taniej niż GPT-5.4. W pokazowym zadaniu przebudował silnik exchange-core w Javie i wyciągnął 185% wzrostu przepustowości po 13 godzinach pracy. Razem z modelem pojawił się Kimi Vendor Verifier — sześć testów sprawdzających, czy dostawcy serwują to, co podpisują marką K2.6.