SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Model / Badania

Model bezpieczeństwa Mistrala dorównuje rywalom prawie siedem razy większym

Mistral wypuścił Shieldstral, model do moderacji treści o 3 miliardach parametrów, który mieści się w 16 GB pamięci karty i działa na jednym GPU na licencji Apache 2.0. Kryterium filtrowania podaje się jako zwykłe pytanie po angielsku, więc politykę zmienia się jednym zdaniem, bez trenowania od nowa. Według raportu samego producenta dostał 99,4% na HarmBench, przed 94,5% dwudziestomiliardowego GPT-OSS-Safeguard, będąc prawie siedem razy mniejszym od rywali. Przy wejściu spreparowanym pod obejście filtra skuteczność jednak spada.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Model / Badania  ·  3 min  · 
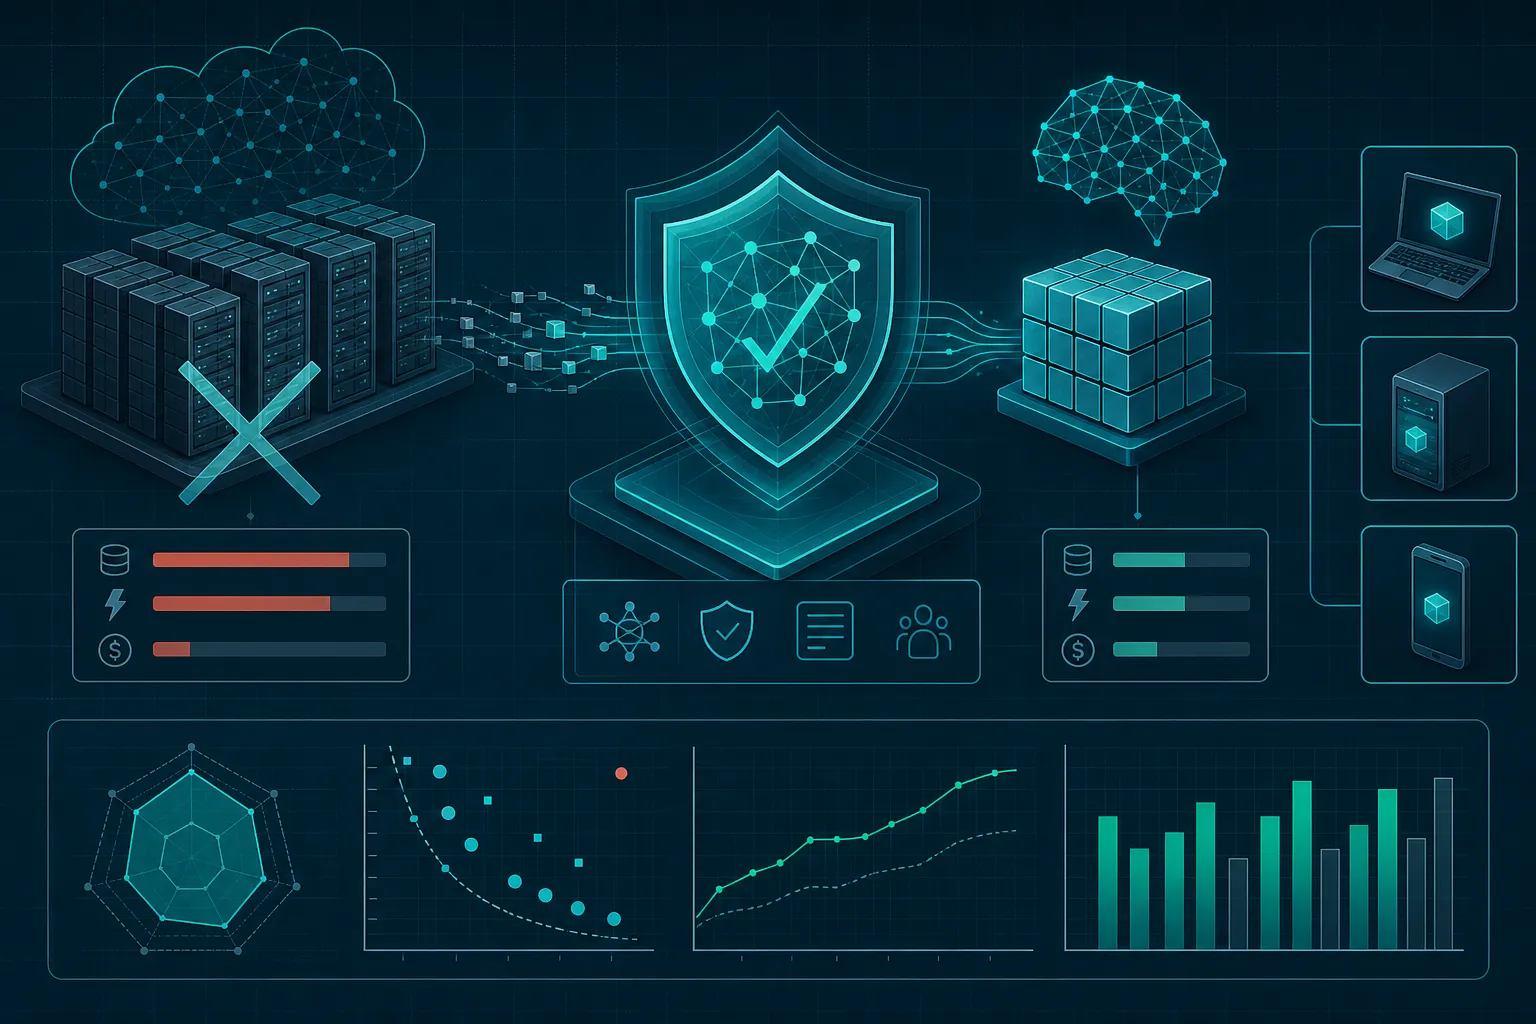
Model bezpieczeństwa Mistrala dorównuje rywalom prawie siedem razy większym
Ilustrację przygotowała AI.

Jeśli budujesz aplikację na LLM, masz problem, o którym rzadko mówi się na konferencjach: ktoś musi sprawdzać, co użytkownik wysyła do modelu i co model odsyła z powrotem. Prośbę o instrukcję, jak kogoś skrzywdzić, trzeba wyłapać, zanim dojedzie do modelu. Odpowiedź, która przeszła przez filtr wejściowy, a mimo to wyszła toksyczna, trzeba zatrzymać, zanim zobaczy ją użytkownik. Narzędzia do tego były do tej pory duże. LlamaGuard od Mety, ShieldGemma od Google i GPT-OSS-Safeguard mają od 9 do 20 miliardów parametrów. W praktyce znaczy to, że obok swojego głównego modelu utrzymujesz drugi, prawie tak samo kosztowny, tylko po to, żeby pilnował bezpieczeństwa.

Mistral wypuścił Shieldstral, model, który robi tę samą robotę, mając 3 miliardy parametrów. Mieści się w 16 GB pamięci karty graficznej, uruchamia się na jednym GPU i wychodzi na licencji Apache 2.0, więc możesz postawić go u siebie i używać komercyjnie, nie pytając nikogo o zgodę. To model, przy którym samodzielne postawienie takiej bramki przestaje być kosztowną fanaberią.

Politykę zmieniasz jednym zdaniem

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Pierwszy model Miry Murati nie wygrywa benchmarków. I dobrze. Model / Badania

Pierwszy model Miry Murati nie wygrywa benchmarków. I dobrze.

4 min

Mira Murati pokazała Inkling, pierwszy model laboratorium Thinking Machines Lab, i od razu przyznała, że nie jest najmocniejszy. Wagi wyszły na czystej licencji Apache 2.0, a pod spodem działa mixture of experts z 975 mld parametrów, z których na token pracuje tylko 41 mld, z oknem kontekstowym do miliona tokenów. Na SWE-Bench Verified dostaje 77,6%, powyżej amerykańskiego Nemotrona 3 Ultra, ale poniżej chińskich liderów DeepSeek V4 Pro i GLM 5.2. Sensem jest rzadki, naprawdę otwarty amerykański model dla zespołów gotowych dostroić go na własnym klastrze GPU z 2 TB pamięci.

Anthropic schował najmocniejszego Claude'a za bramą Project Glasswing Analiza / Opinia

Anthropic schował najmocniejszego Claude'a za bramą Project Glasswing

4 min

Anthropic przyznał wprost, że Claude Opus 4.7 z 16 kwietnia ma celowo obniżone zdolności cyberbezpieczeństwa — pełna wersja trafia tylko do ośmiu firm Project Glasswing, w tym AWS-a, Apple'a i JPMorgana. Publiczny model skoczył na SWE-bench Pro z 53,4% do 64,3%, dostał poziom wysiłku xhigh i budżety zadań od 20 tysięcy tokenów. Migracja boli: nowy tokenizer liczy nawet 1,35 raza więcej, a Messages API odcina thinking.budget_tokens i niedomyślne temperature. Na BrowseComp Opus spadł z 83,7% do 79,3%, więc do syntezy z wielu źródeł GPT-5.4 Pro nadal wygrywa.

Leanstral 1.5 dowodzi twierdzeń matematycznych i przy okazji znajduje błędy w prawdziwym kodzie Model / Badania

Leanstral 1.5 dowodzi twierdzeń matematycznych i przy okazji znajduje błędy w prawdziwym kodzie

3 min

Leanstral 1.5, wypuszczony 6 lipca przez Mistrala na licencji Apache-2.0, zachowuje się jak agent programistyczny, tylko że jego robotą są dowody w Lean 4: proponuje kod, czyta uwagi kontrolera i poprawia próbę, aż dowód przejdzie. Puszczony na 57 repozytoriów, wyłapał pięć błędów, których nikt wcześniej nie zgłosił na GitHubie. Mistral podaje komplet punktów na miniF2F i 587 z 672 zadań PutnamBench, a przede wszystkim około 4 dolary za zadanie wobec 300 dolarów u konkurencyjnego Seed-Prover 1.5. Tyle że nikt tych wyników jeszcze niezależnie nie powtórzył.