SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Model / Badania

Model przepisuje 90% migracji i dostaje za to zero punktów

Google przebudował Android Bench od podstaw: zamiast drobnych poprawek mierzy zadania, nad którymi inżynier siedzi kilka dni, a wynik podaje jako ciągły wskaźnik ukończenia. Czołówka, która na poprzedniej wersji meldowała ponad 90%, zjechała do 28% dla prowadzącego GPT-6 Astra, czyli tą samą drogą co wcześniej przy SWE-Bench Pro. Przepisywanie z Javy na Kotlina modele robią gładko, ale przeniesienia aplikacji wieloplatformowej na natywnego Androida nie domknął żaden. Oceniany jest przy tym model razem z harnessem, więc różnica między wierszami tabeli nie musi być różnicą między modelami.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Model / Badania  ·  4 min  · 
Model przepisuje 90% migracji i dostaje za to zero punktów
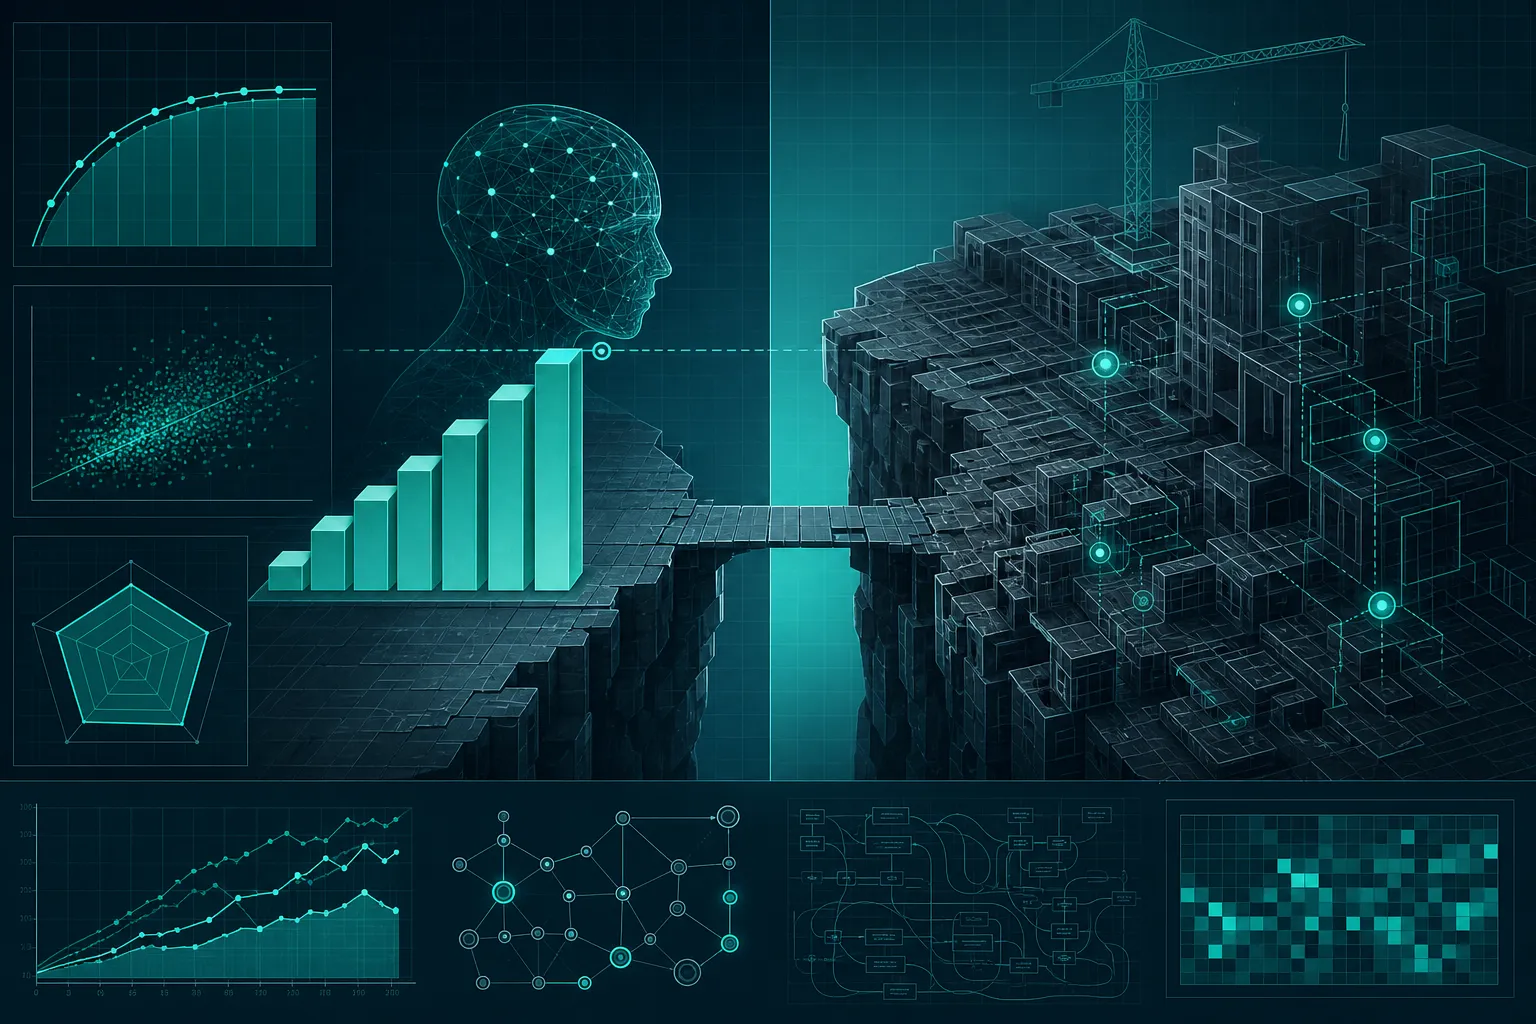
Ilustrację przygotowała AI.

Model przepisuje 90% wielkiej migracji całego projektu, a testy na końcu i tak nie przechodzą, więc w tabeli wyników ląduje zero. Tak do niedawna wyglądało mierzenie tego, jak AI radzi sobie z kodem, i dokładnie na tym absurdzie wyłożyła się stara punktacja, gdy Google przebudował swój benchmark od podstaw.

Na Android Benchu Google sprawdza modele i agenty na prawdziwej robocie w projektach na Androida. Pierwsza wersja, z wcześniejszych miesięcy tego roku, sprawdzała drobiazgi: poprawki w pojedynczych funkcjach i niewielkie refaktory. Czołówka meldowała tam wyniki grubo powyżej 90%, czyli dokładnie tyle, ile w prawdziwej migracji warte było zero. Dwójka mierzy w końcu to, z czym deweloper realnie żyje: ile roboty udało się zrobić, zanim wszystko stanęło.

Zadania są tu innej klasy. Google nazywa je długodystansowymi i mierzy czasem człowieka, bo to robota, nad którą inżynier siedzi kilka dni, a bywa że cały tydzień. Najostrzejszy przypadek to przeniesienie aplikacji wieloplatformowej na natywnego Androida: rozbierasz działający produkt i składasz go z innych klocków tak, żeby użytkownik nie zauważył różnicy. W zestawie jest też budowanie aplikacji od pustego katalogu i podnoszenie wersji zależności w całym projekcie.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Benchmark Google mierzy teraz, ile pracy zostaje po agencie
Premiera / Narzędzie

Benchmark Google mierzy teraz, ile pracy zostaje po agencie

4 min

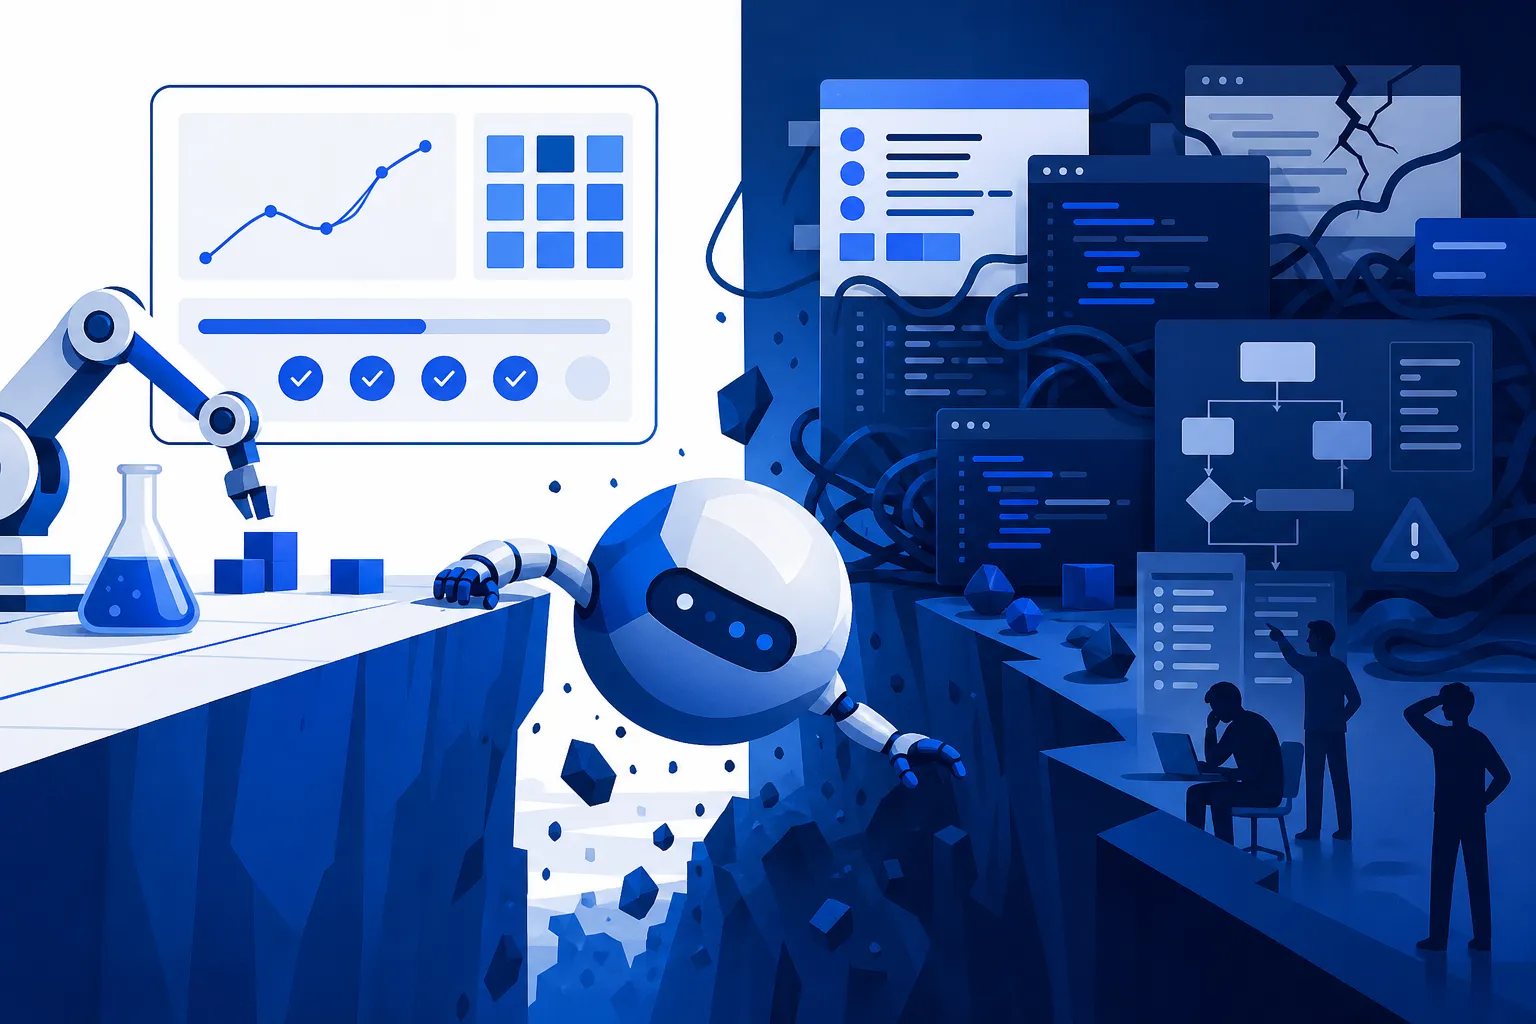
Android Bench 2.0, nowy test Google dla agentów piszących aplikacje na Androida, obok pełnych zaliczeń pokazuje wskaźnik ukończenia, czyli to, jaką część pracy agent wykonał dobrze. GPT-6 Astra w Codeksie kończy 82,2% pracy, ale w całości zalicza tylko 28% przebiegów, a Claude Fable 5.1 w Claude Code ma 82,4% i 22,7%. Resztę stanowią błędy widoczne dopiero w działającej aplikacji, jak odtwarzacz grający w tle czy stan tracony po obróceniu telefonu, dlatego przegląd kodu warto przesunąć ze stylu na zachowanie aplikacji.

Google wbudował sterowanie komputerem w model, który i tak już odpalasz
Premiera / Narzędzie

Google wbudował sterowanie komputerem w model, który i tak już odpalasz

5 min

Google przeniósł sterowanie komputerem do Gemini 3.5 Flash, czyli szybkiego i taniego modelu, który deweloperzy i tak już mają podpięty pod aplikacje. Zamiast osobnego modelu jeden agent widzi ekran i klika jak człowiek, dzięki czemu wchodzi tam, gdzie nie ma API, choćby w stary firmowy system. Google podaje wynik 78,4% na OSWorld-Verified, ale to deklaracja producenta, nie dowód. Kluczowe zabezpieczenia, czyli potwierdzanie wrażliwych działań i blokada wstrzykniętych instrukcji, są opcjonalne, więc ryzyko spada na deweloperów.

Google przyznaje, że przegrywa w kodowaniu, a zamiast flagowca wypuszcza tańszy model
Model / Badania

Google przyznaje, że przegrywa w kodowaniu, a zamiast flagowca wypuszcza tańszy model

4 min

Sundar Pichai na telekonferencji wynikowej przyznał, że Google wypada słabiej w kodowaniu i kodowaniu agentowym. Flagowy Gemini 3.5 Pro, planowany na czerwiec, wciąż się nie pojawił, bo jego wyniki w programowaniu rozczarowały. Zamiast niego Google wypuściło tańsze modele Flash, z Gemini 3.6 Flash na czele, który na benchmarku DeepSWE zużywa do 65% mniej tokenów i podniósł wynik z 37% do 49%. Prawdziwy problem to jednak nie harmonogram premier, tylko brak własnego narzędzia do kodu zbierającego dane o tym, jak ludzie realnie programują z modelem.