SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Analiza / Opinia

Na krótkim teście modele wyglądają świetnie, na długim kontekście padają o 47%

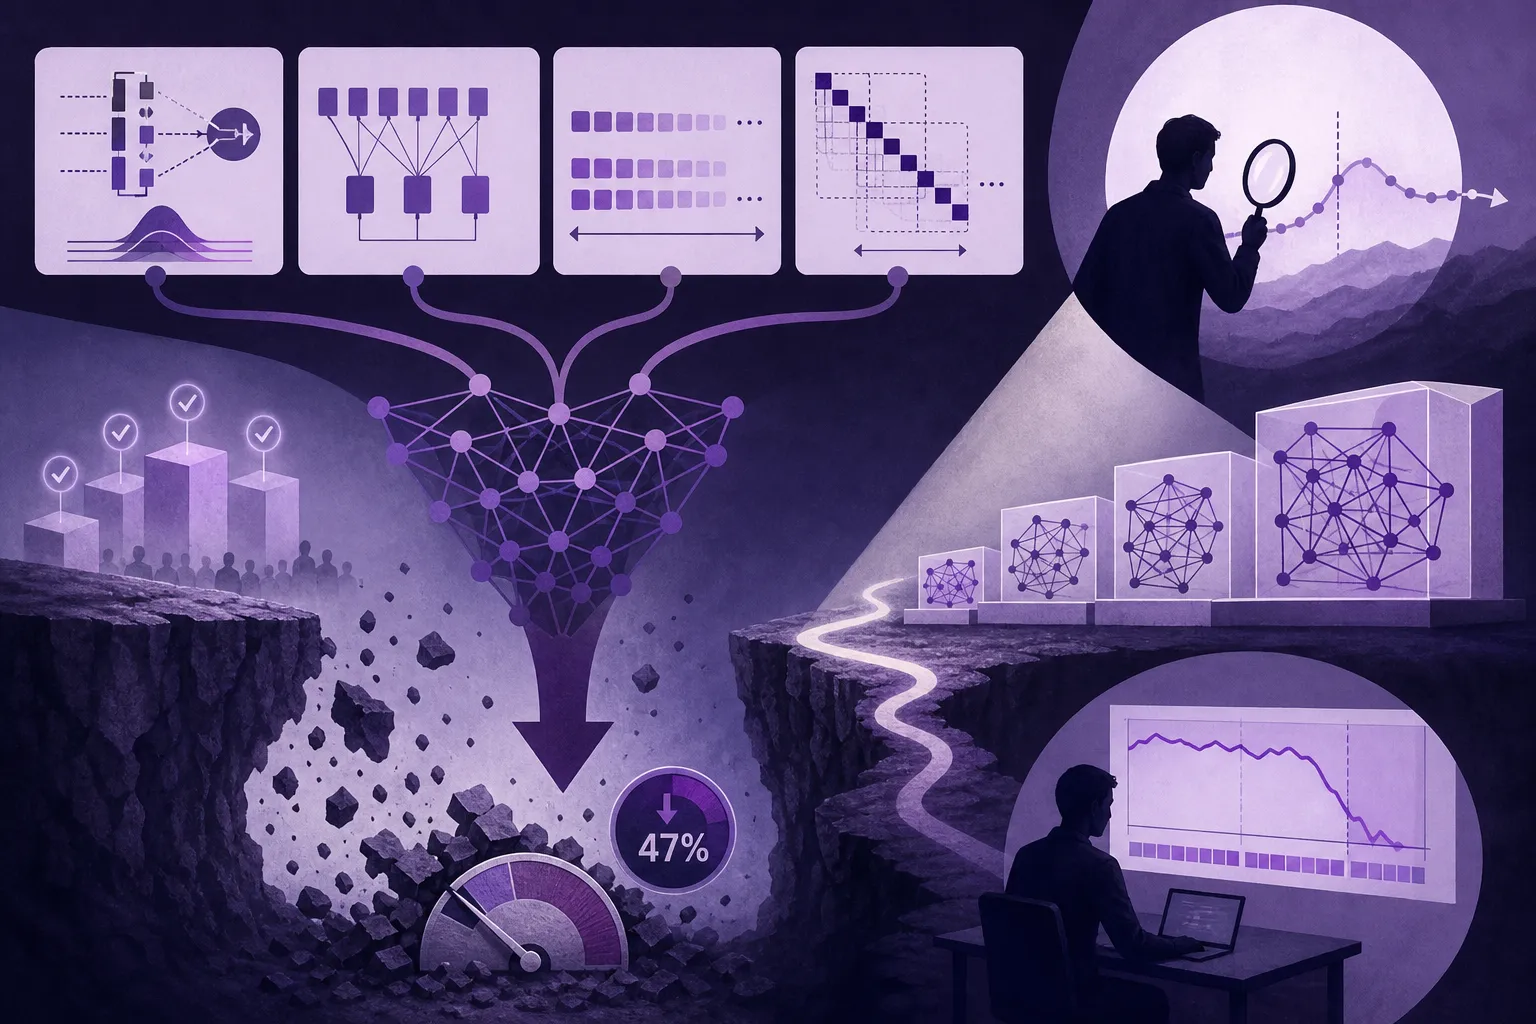
Praca "Cracks in the Foundation" (COLM 2026, arXiv 10 sierpnia) zespołu Amandy Bertsch pokazuje, że cztery pozornie błahe decyzje architektoniczne, każda z osobna niegroźna, kumulują się i obniżają jakość modelu na długim kontekście nawet o 47%. Spadku nie widać ani po stracie treningowej, ani na krótkich benchmarkach, więc model wyglądający zdrowo na standardowych testach zawodzi dopiero na długim wejściu. Zespół udostępnił OlmPool, 26 porównywalnych modeli po 7 mld parametrów, i twierdzi, że kiepską kombinację da się wyłapać już wcześnie w treningu.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Analiza / Opinia  ·  4 min  · 
Na krótkim teście modele wyglądają świetnie, na długim kontekście padają o 47%
Ilustrację przygotowała AI.

Wybieracie model do zadania, które wymaga długiego kontekstu, na przykład przeczytania całego repozytorium naraz albo wielostronicowego dokumentu bez pomijania fragmentów. Na standardowych testach wypada świetnie, więc bierzecie go do pracy. Dopiero na naprawdę długim wejściu okazuje się, że gubi wątek, a jakość odpowiedzi potrafi spaść nawet o połowę. Najgorsze jest to, że krótkie benchmarki, na których go sprawdzaliście, nie dały wam żadnego ostrzeżenia.

Dokładnie ten scenariusz bada nowa praca "Cracks in the Foundation", przyjęta na konferencję COLM 2026 i wrzucona na arXiv 10 sierpnia. Zespół, którego pracę firmuje Amanda Bertsch, pokazuje coś, co przez lata traktowano jako drobiazg inżynierski: kilka pozornie błahych decyzji w budowie modelu, każda z osobna prawie bez znaczenia, potrafi się skumulować i położyć działanie na długim kontekście. Moim zdaniem sedno nie leży w samej liczbie, która robi wrażenie, tylko w tym, że winne są zwykłe, nudne decyzje inżynierskie, z których każda wygląda niegroźnie.

Cztery decyzje, które osobno nic nie znaczą

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Osiemnaście punktów różnicy bez ruszania wag modelu Analiza / Opinia

Osiemnaście punktów różnicy bez ruszania wag modelu

5 min

Ten sam Claude Opus 4.6 zalicza 58% zadań w TerminalBench-2 pod Claude Code i 81,8% w prowadzącym ForgeCode, choć wagi w obu są identyczne. Różnicę robi harness, czyli warstwa decydująca, co model widzi, czym może ruszyć i ile razy dostaje szansę na poprawkę. ClickHouse zamroził tę warstwę, przepuścił przez nią 28 modeli i policzył, że od 53 do 82% błędów bierze się ze złego planu, a nie ze złego SQL-a, więc proponuje, żeby plan pisał model najdroższy, a wykonywał najtańszy. Kupując gotowego agenta, kupujecie parę, której druga połowa nie ma żadnej dokumentacji.

Prawie 100% na benchmarku, którego jedna trzecia nie działała Analiza / Opinia

Prawie 100% na benchmarku, którego jedna trzecia nie działała

4 min

OpenAI w lutym namawiało branżę na SWE-bench Pro, a w lipcu wycofało własną rekomendację, bo ludzki przegląd uznał 34,1% zadań za zepsute. Głośne „prawie 100%" ze Stanford AI Index to wynik przeskalowany względem poziomu odniesienia, a nie odsetek rozwiązanych zgłoszeń — surowo najlepszy model ruszył z 74,9% do 80,9%. Benchmarki psują się przez skażenie danych treningowych i wadliwe testy odrzucające poprawny kod. Zanim uwierzysz w tabelę, sprawdź, którą wersję testu i który wynik mierzy, a potem i tak puść model na własnym repozytorium.

Dziesięć awarii między działającym modelem a czystym bełkotem Poradnik / Praktyka

Dziesięć awarii między działającym modelem a czystym bełkotem

4 min

Deweloper tonyd2wild uruchomił GLM-5.2, otwarty model o 753 miliardach parametrów, na dwóch biurkowych DGX Spark, osiągając około 15 tokenów na sekundę. Zmieściło się to dzięki architekturze mixture-of-experts i kwantyzacji ekspertów do 2 bitów, kosztem jakości odpowiedzi. Sednem nie są jednak liczby, tylko lista 10 awarii dzielących "teoretycznie się da" od "faktycznie działa": różne nazwy użytkowników rozbiły ścieżkę do biblioteki NCCL, a brakujący plik z wagami sprawił, że model wstawał czysto i wypluwał bełkot. Główny wniosek: "wstało bez błędów" nie znaczy "działa poprawnie".