Premiera / Narzędzie
Najdroższy model potrzebny tylko do planu, resztę zrobi tańszy
Cursor dał rojowi agentów 835 stron dokumentacji SQLite i kazał odtworzyć bazę w Rust bez kodu źródłowego, a efekt przeszedł 100% ukrytych testów. Prawdziwy wniosek leży jednak w rachunku: przy niemal identycznej jakości koszt rozjechał się od 1339 dolarów, gdy planował Opus 4.8, a wykonywał tani Composer 2.5, po 10 565 dolarów za GPT-5.5 grający obie role naraz. Sztuczka polega na tym, że najdroższy model tylko rozbija cel na jednoznaczne instrukcje, a tańszy je wykonuje, bo naprawdę mało momentów w dużym zadaniu wymaga najkosztowniejszej inteligencji.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 3 min ·
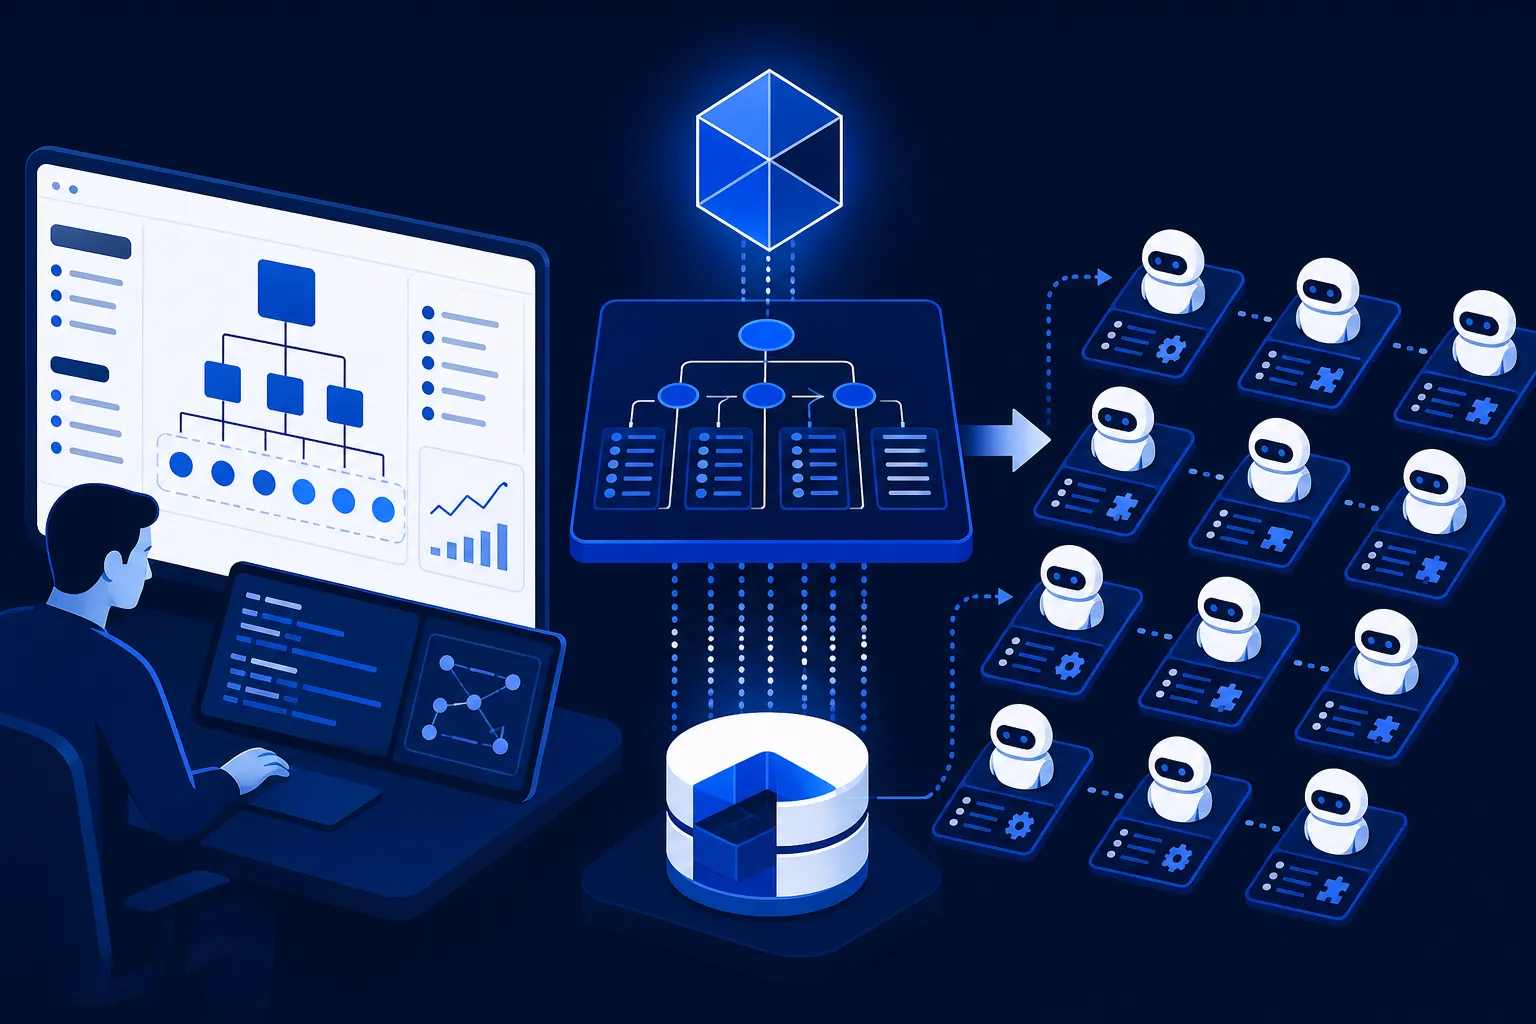
Cursor dał swojemu rojowi agentów dokumentację SQLite liczącą 835 stron i kazał odtworzyć całą bazę danych w Rust. Bez kodu źródłowego, bez testów, bez dostępu do internetu, tylko instrukcja obsługi spisana prozą. Rój napisał działającą bazę, która przeszła 100% ukrytego zestawu testów, o którego istnieniu nawet nie wiedział. Efektowne, tyle że prawdziwy wynik tego eksperymentu nie leży w tej setce, tylko w rachunku: przy niemal identycznej jakości koszt potrafił się różnić prawie ośmiokrotnie, zależnie od tego, który model odrabiał którą część roboty.
W roju wielu agentów pracuje naraz nad jednym celem, ale najwięcej wynika z podziału na dwie role. Planista, napędzany najmocniejszym i najdroższym modelem, rozbija cel na mniejsze kawałki i rozdaje je dalej. Wykonawca, zwykle tańszy i szybszy model, pisze kod według gotowej instrukcji. Sztuczka polega na tym, że planista nigdy nie schodzi do pisania kodu, a wykonawca nigdy nie planuje. Dzięki temu żaden z nich nie zapycha sobie kontekstu tym, co należy do drugiego: planista trzyma w głowie całość, wykonawca skupia się na jednym wąskim fragmencie.
Ta czystość kontekstu przekłada się na mniej marnotrawstwa, co widać, gdy zestawić starą i nową wersję roju na tym samym modelu Grok 4.5 od xAI. W starej jeden najgorętszy plik zebrał 7771 konfliktów scalania i przewinęło się przez niego 1173 różnych agentów, którzy nawzajem nadpisywali sobie zmiany. W nowej najbardziej oblegany plik w całym projekcie miał ich 47. Stara wersja rozrosła się do 54 pakietów, w tym trzech osobnych implementacji SQL, bo dwaj planiści nie wiedzieli o sobie i budowali to samo dwa razy. Nowa ustabilizowała się na dziewięciu pakietach i przy nich została.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.