Premiera / Narzędzie
Rocket twierdzi, że plan przed kodem dał agentowi większy skok jakości niż pętla naprawcza
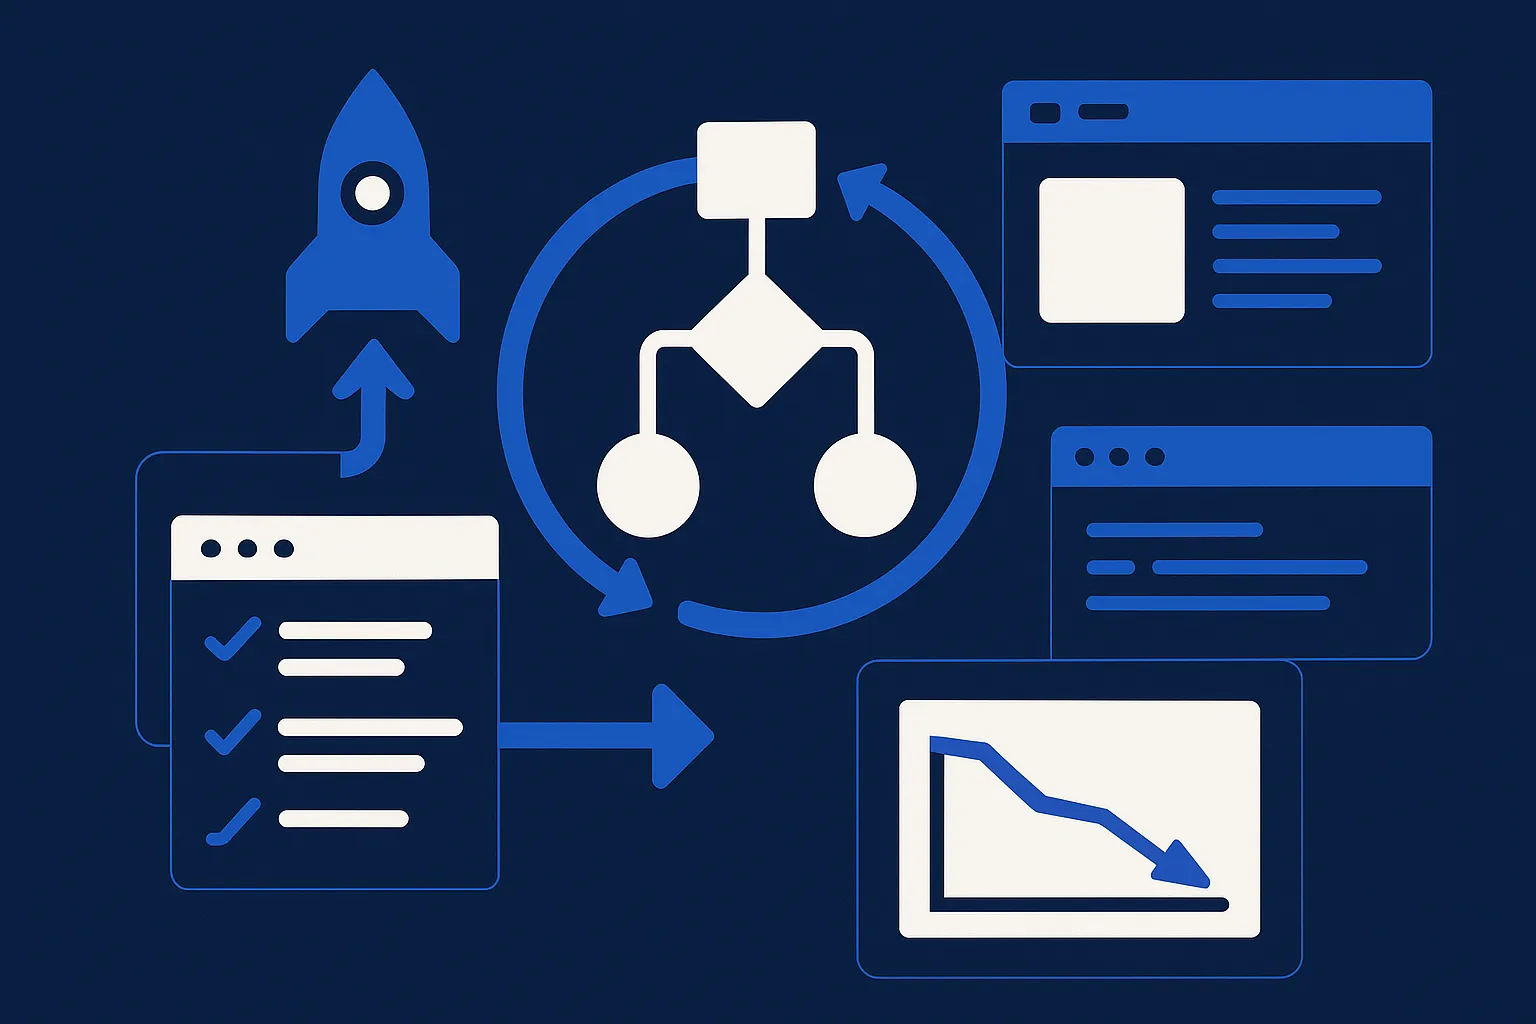
Rocket opisuje architekturę Agenta V2 jako trzy klocki: samonaprawczą pętlę, która sama uruchamia kod i czyta logi, sześciofazowe planowanie przed pisaniem kodu oraz ponad 100 reguł „anti-slop" wpiętych w tę samą pętlę co błędy builda. Wewnętrzne pomiary V1 kontra V2 pokazują 38% niższy koszt zadania, 30% dłuższy czas, 88% mniej błędów typów i 48% mniej błędów integracyjnych. Teza, że jakość rozstrzyga się w warstwie między modelem a wynikiem, broni się sama, ale lista reguł nie jest publiczna, a niezależnego porównania z Cursor Agentem czy Lovable'em brakuje.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 4 min ·
Rocket, jedno z narzędzi do vibe codingu, które z krótkiego opisu generują całe aplikacje, opublikował opis architektury swojego Agenta V2. Cała argumentacja trzyma się jednego punktu: modele z czołówki są u wszystkich te same, więc o jakości wyniku decyduje to, co dzieje się między promptem użytkownika a wygenerowanym kodem. U Rocketu ta warstwa zbudowana jest z trzech klocków, którym warto przyjrzeć się osobno nawet wtedy, kiedy benchmarki w tekście są wyłącznie wewnętrzne.
Pętla, która sama uruchamia kod i czyta logi
Pierwszy klocek nazywają "samonaprawczą pętlą". Po wygenerowaniu kodu agent sam go uruchamia, czyta logi z builda i z wykonania, klasyfikuje konkretny błąd i wprowadza punktową poprawkę, a potem startuje znowu. Tak długo, aż build przejdzie. W praktyce wygląda to tak, że komponent z brakującym importem albo integracja z bazą z błędną polityką dostępu naprawia się w środku jednego wywołania, zanim użytkownik w ogóle zobaczy pierwszy podgląd. Cała klasa błędów, która w poprzedniej wersji wymagała od człowieka opisania problemu i drugiego okrążenia, znika z jego pola widzenia.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.