Poradnik / Praktyka
Najtrudniejsza linijka promptu to ta, w której mówisz, co znaczy gotowe
Komenda /goal w Claude Code odwraca pracę z modelem: zamiast sterować nim ruch po ruchu, podajesz metę i szablon z pięcioma polami, a model sam pracuje, aż dowiezie wynik albo wyczerpie limit tur. Najtrudniejsze jest pole VERIFICATION, bo trzeba w nim mierzalnie zapisać, co znaczy „gotowe”, inaczej model kończy za wcześnie albo kręci się w kółko. Sabrina przepuściła szablon przez sześć projektów, ale rada, żeby pracował godzinami, zderza się z ceną: drogi Claude Fable ma ścięty o połowę tygodniowy limit, więc rozsądniej puszczać go na planowanie, a pisanie kodu zostawić tańszemu Opusowi 4.8.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Poradnik / Praktyka · 4 min ·
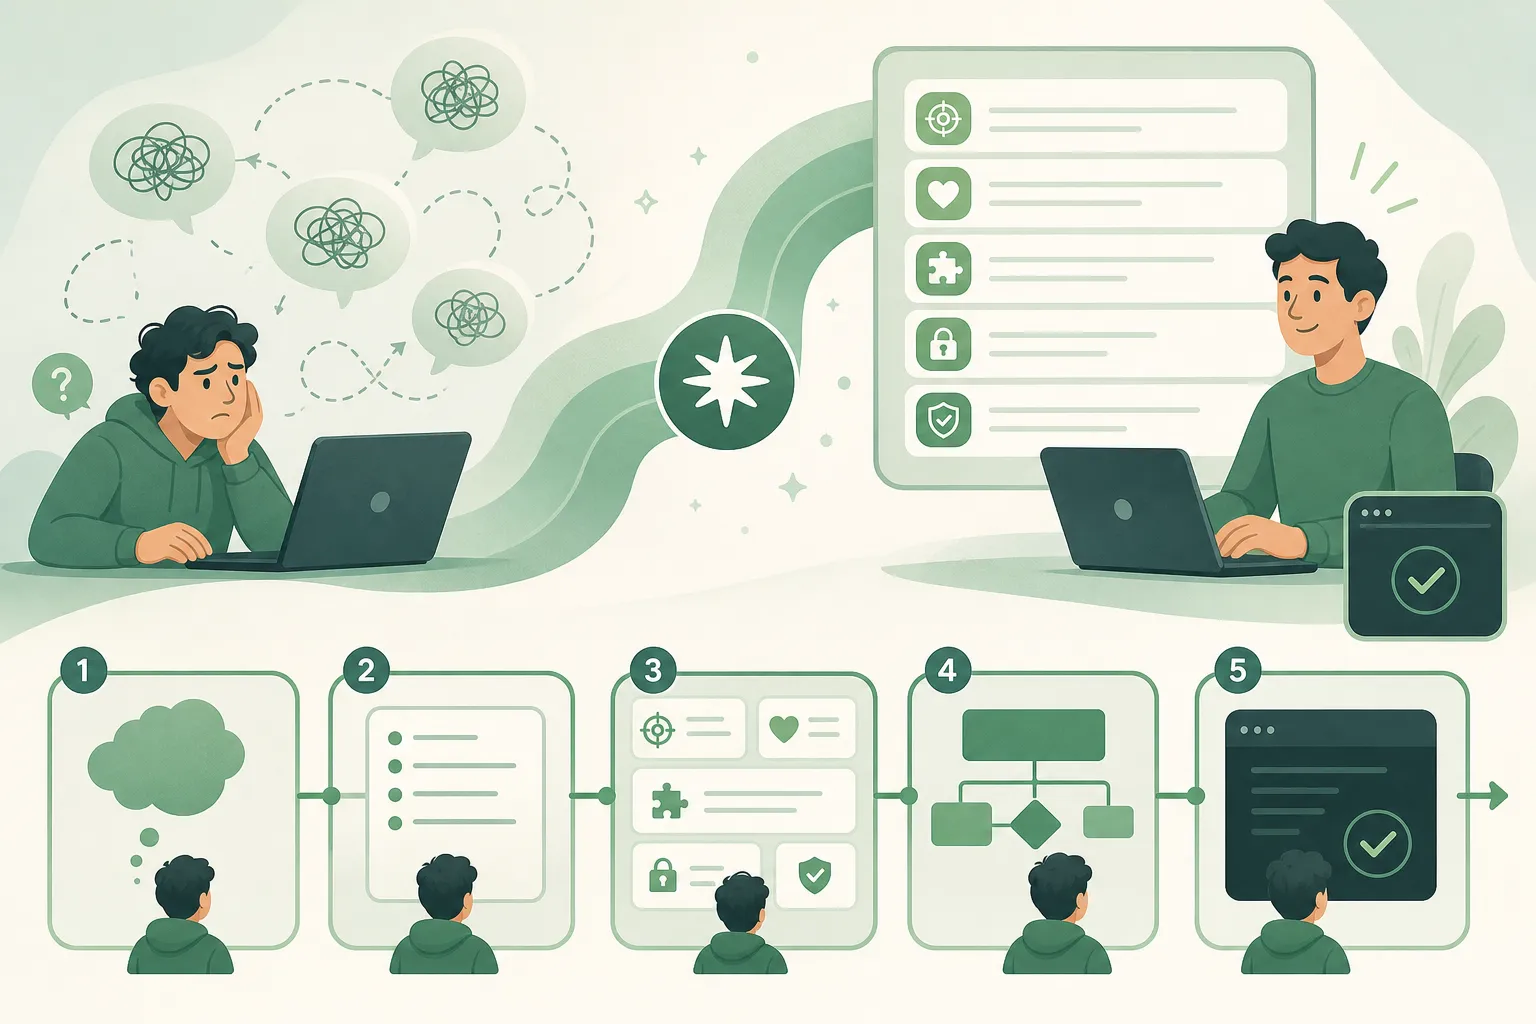
Od miesięcy praca z Claude Code wygląda tak samo. Wpisujesz polecenie, patrzysz, co model zrobił, poprawiasz, wpisujesz następne. Sterujesz nim ruch po ruchu, jak ktoś, kto stoi za plecami stażysty i co chwilę rzuca "nie, nie tak". Komenda /goal w Claude Code odwraca ten układ: zamiast pojedynczej instrukcji podajesz metę, a model sam pracuje i sprawdza własny postęp, dopóki nie dowiezie wyniku albo nie wyczerpie limitu tur, który mu wyznaczysz.
Wokół tej jednej komendy Sabrina z sabrina.dev zbudowała prosty szablon promptu i przepuściła przez niego sześć projektów: od pająka uczącego się wchodzić po schodach w otwartym symulatorze fizyki Genesis-World, przez grywalną grę o lataniu na smoku, po trzydniowy test A/B automatycznych wiadomości na Instagramie, który chodził jej non stop. Za każdym razem prompt ma te same pięć pól. W TASK wpisujesz czasownik, jedno polecenie: co model ma zrobić. WHY mówi, dla kogo to jest i po co, i akurat tego kontekstu Fable szczególnie potrzebuje. OUTCOME opisuje gotowy wynik na tyle dokładnie, żeby słowo "gotowe" było jednoznaczne. W CONSTRAINTS stawiasz bariery: czego nie ruszać i po ilu turach się zatrzymać. Na końcu jest VERIFICATION, sprawdzian, po którym model sam pozna, że dowiózł. Cały ten szablon jest banalnie prosty i już tu widać rzecz, do której wrócę na końcu: nie ma w nim niczego, co wiązałoby go akurat z Fable.
I to ostatnie pole jest tu całą stawką. "Zrób to dobrze" nie jest metą. "Zdobywa ponad 8 na 10 w mojej autorskiej ocenie" już jest. Bez takiej linijki model nie ma jak udowodnić, że wynik naprawdę powstał, więc albo kończy za wcześnie, albo kręci się w kółko, zgadując. Dobra VERIFICATION daje mu coś, co da się realnie sprawdzić: nagranie, wskaźnik klikalności, potwierdzenie, że lokal jest otwarty w wybranym dniu. W projekcie z tygodniem gotowych treści model przepuszcza każdy wpis przez oceniający skill /post-grader, punktuje go według rubryki i poprawia tak długo, aż wszystkie przekroczą 8 na 10. To zwykle dwie, trzy rundy przeróbek na wpis, i o to właśnie chodzi, bo ciebie już przy nich nie ma. Cały sens, jak pisze autorka, polega na tym, żeby wyjąć człowieka z pętli ciągłego dopromptowywania.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.