Premiera / Narzędzie
Obraz mieści trzy razy więcej treści na token, ale potrafi po cichu przekłamać identyfikator
pxpipe, otwartoźródłowe proxy dla Claude Code, przepisuje najcięższe fragmenty kontekstu na gęsto zadrukowane obrazy PNG, bo model płaci za obraz według pikseli, a nie tekstu: około 3,1 znaku na token obrazu wobec jednego na token tekstowy. Rachunek spada o 59-70% liczone od początku do końca, a w nagraniu demo sesja kończy się na 6,06 dolara zamiast 42,21. Problem w tym, że obrazowanie jest stratne i model po cichu zmyśla przekłamane znaki, więc identyfikatory, sekrety i najświeższe tury zostają tekstem.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 5 min ·
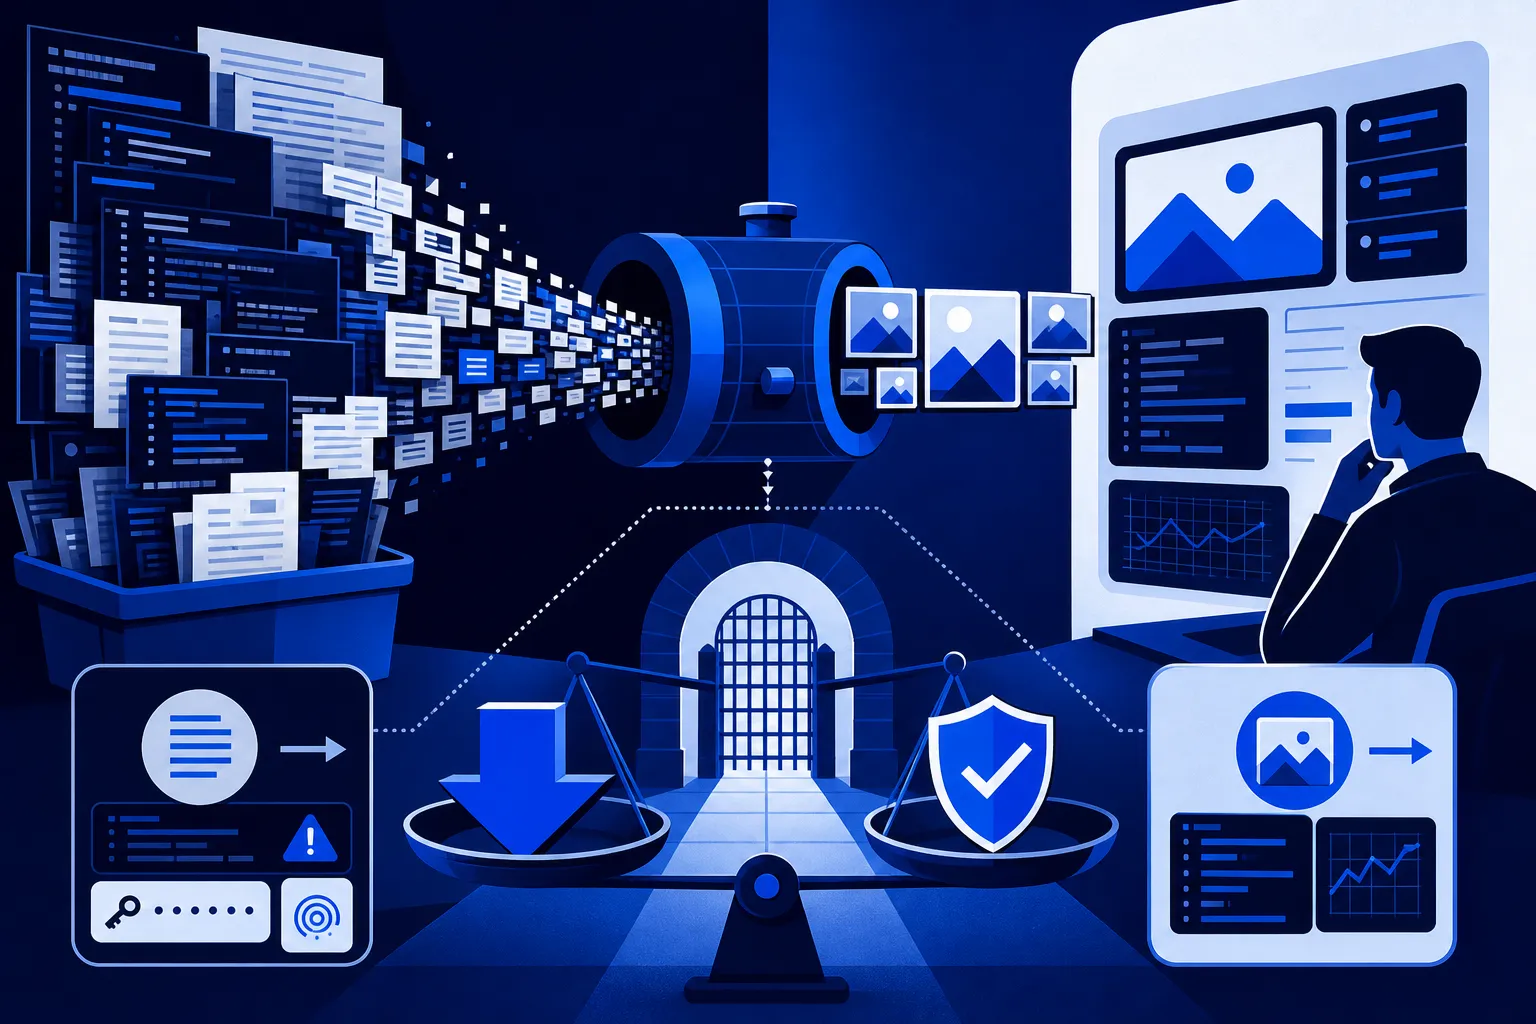
Obraz kosztuje model tyle tokenów, ile ma pikseli, a nie tyle, ile tekstu da się w nim upchnąć. Na tym jednym spostrzeżeniu stoi pxpipe, otwartoźródłowe narzędzie, które bierze najbardziej opasłe fragmenty kontekstu wysyłanego do Claude Code i zamiast tekstu wrzuca je do modelu jako gęsto zadrukowaną stronę PNG. Gęsta treść, czyli kod, JSON i wyniki poleceń, mieści się w obrazie mniej więcej trzy razy oszczędniej niż w zwykłym tekście: około 3,1 znaku na token obrazu wobec jednego znaku na token tekstowy. Kanał, którym model to czyta, to dokładnie ten sam, którym Anthropic każe mu oglądać zrzuty ekranu. pxpipe tylko używa go do czegoś innego.
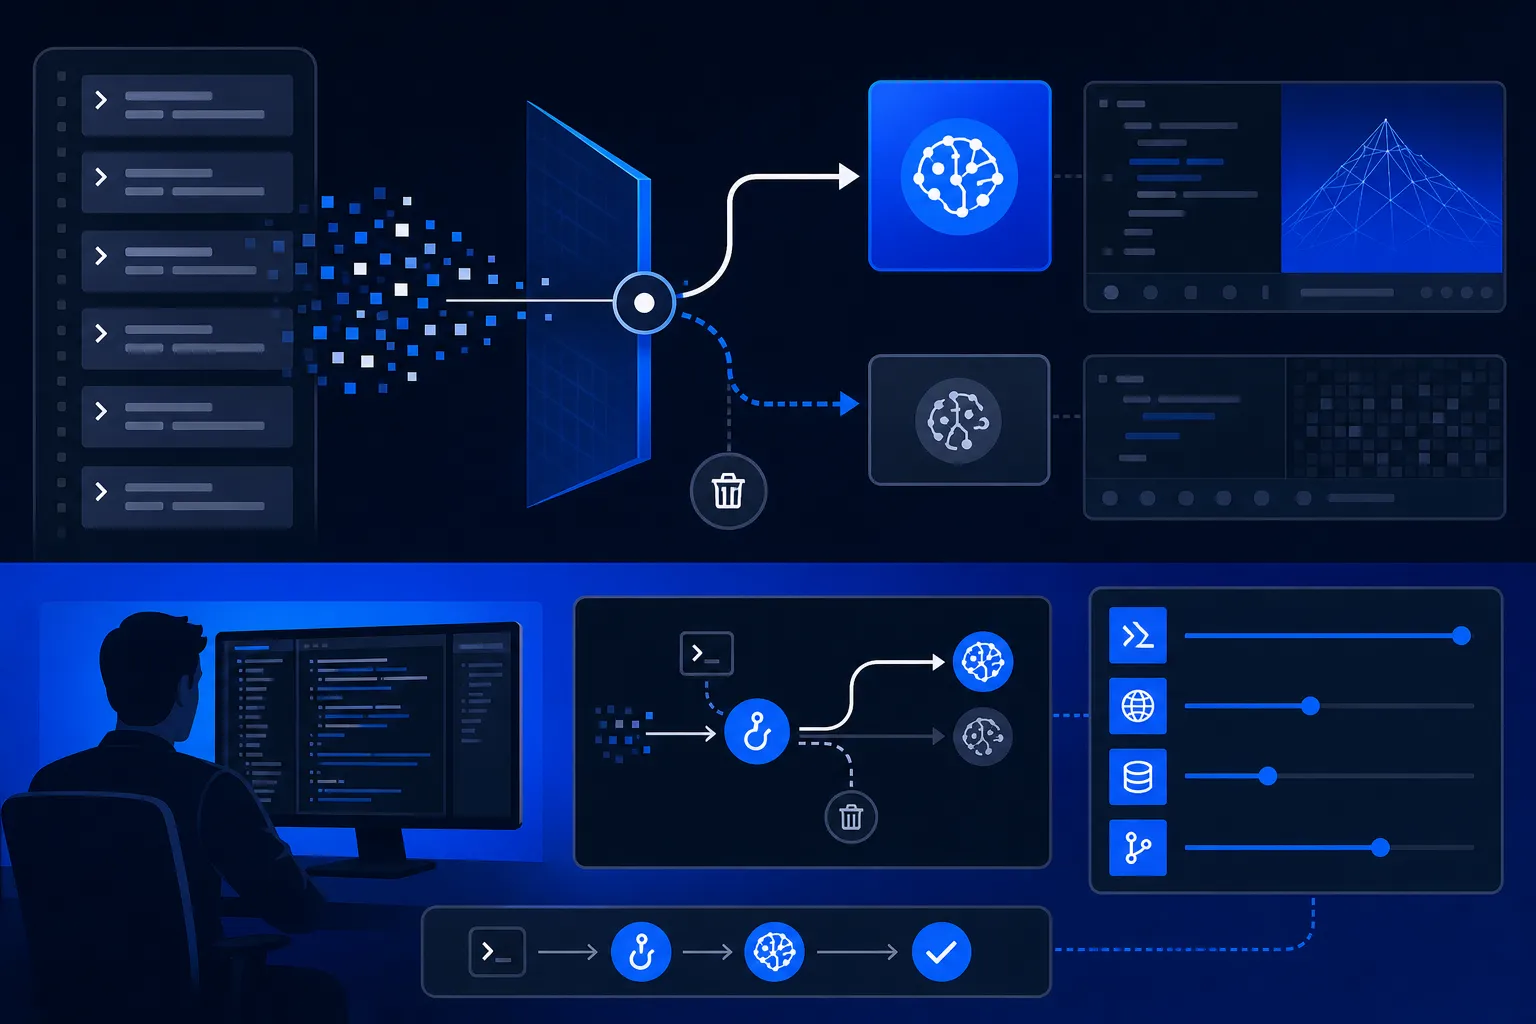
Problem, który to rozwiązuje, zna każdy, kto zostawił Claude Code na dłużej przy jednym zadaniu. Kontekst puchnie szybciej niż okno, w którym ma się zmieścić, bo systemowy prompt, opisy narzędzi i cała historia rozmowy rosną z każdą turą, a płacisz za nie w każdym kolejnym żądaniu. pxpipe działa jako lokalne proxy: stawiasz je jednym poleceniem, przestawiasz zmienną ANTHROPIC_BASE_URL na adres proxy i Claude Code rozmawia z modelem przez nie. Proxy przechwytuje żądanie, przepisuje ciężkie kawałki na obrazy i dopiero wtedy wypuszcza je dalej. Ściska przy tym samo żądanie, nigdy odpowiedź modelu, a najświeższe tury zostawia tekstem, bo obrazuje tylko to, co i tak się nie zmienia: statyczny prompt systemowy, opisy narzędzi i starszą historię.
Liczby, którymi autor się chwali, są policzone nietypowo uczciwie. Rachunek spada o 59–70% w ujęciu od początku do końca, a twórca pxpipe od razu tłumaczy, dlaczego to ważne, bo większość narzędzi do kompresji liczy oszczędność tylko na tym kawałku, który sama tknęła, co ładnie podbija wynik. Tutaj mianownikiem jest cały ruch produkcyjny, łącznie z małymi żądaniami, których proxy słusznie nie ruszyło, z całą pamięcią podręczną i z tokenami wyjściowymi, których nie kompresuje nikt. Na zrzucie z prawie 14 tysięcy żądań wyszło 59%, na późniejszym śladzie około 70%.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.