SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Claude nigdy nie zobaczy pliku, który przeczytał za niego tańszy model

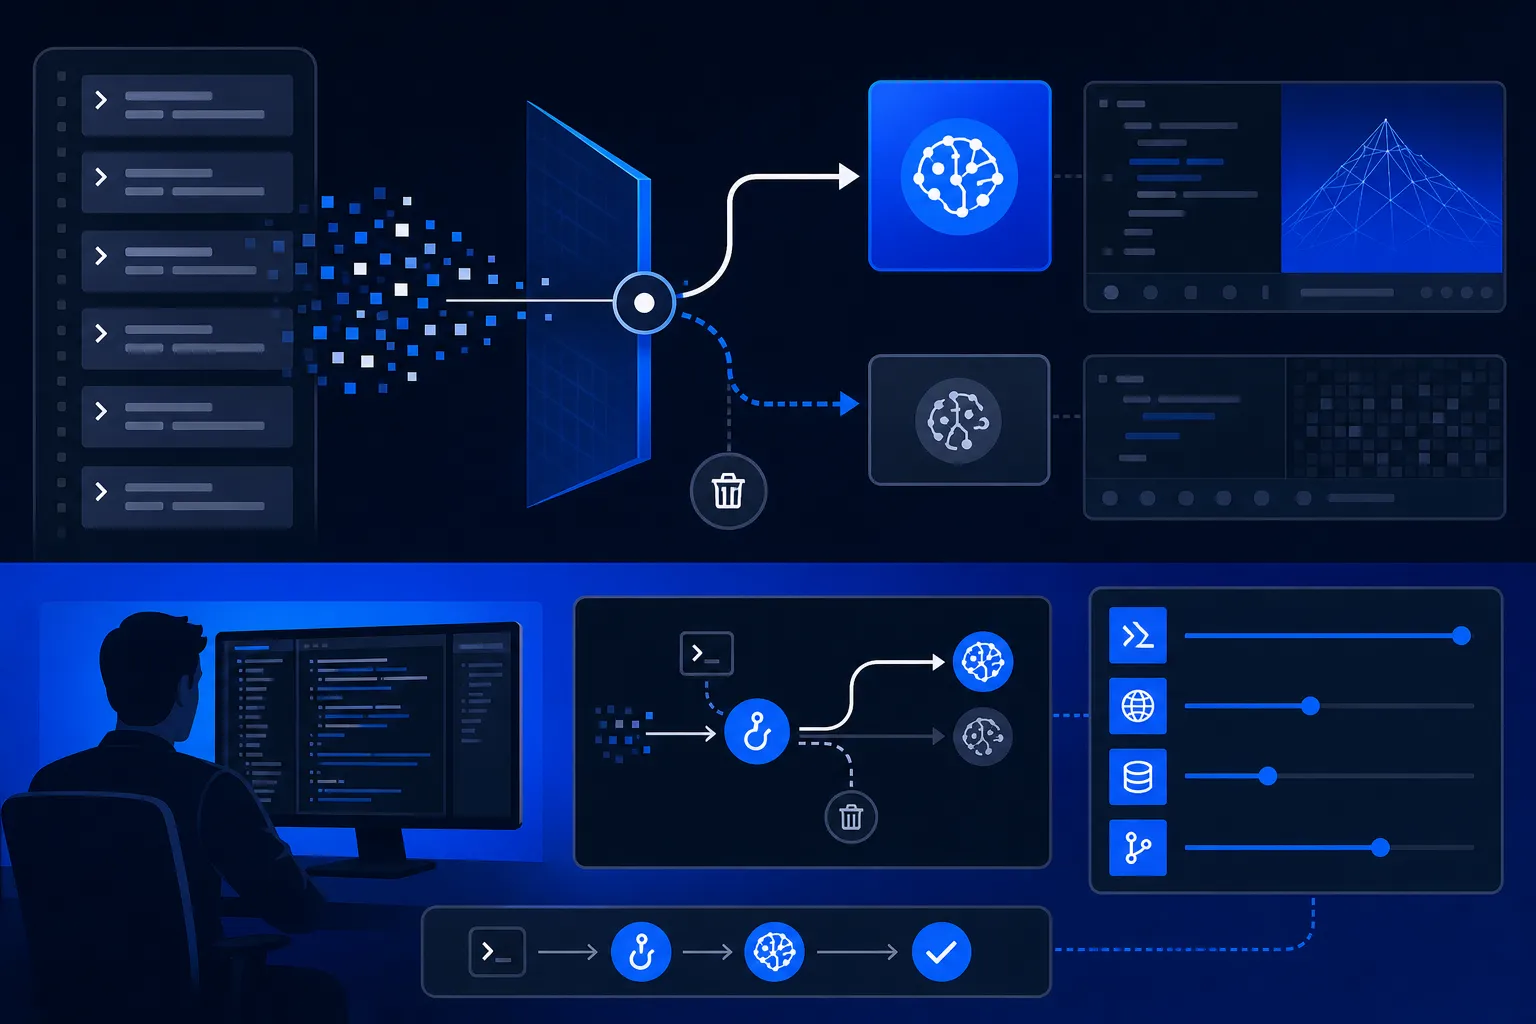
Dimitri Mazmanov ze Spotify najpierw prosił Claude Code w pliku CLAUDE.md, żeby wielkich plików nie czytał sam, i wychodziło z tego średnio; zadziałała dopiero twarda blokada, czyli hook PreToolUse, który powyżej 350 linii odsyła odczyt do tańszego modelu i ścina zużycie tokenów o jakieś 90%. Zysk narasta z każdą turą, bo raz wczytany plik wraca na wejście przy każdym kolejnym wywołaniu. Granice są za to twarde: rozumowania, edycji ani kodu krytycznego dla bezpieczeństwa oddać się nie da, a każde zlecenie to od 10 do 30 sekund czekania.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  5 min  · 
Claude nigdy nie zobaczy pliku, który przeczytał za niego tańszy model
Ilustrację przygotowała AI.

Dimitri Mazmanov, menedżer produktu w Spotify, zaczął tak, jak zaczyna większość ludzi walczących z rachunkiem za agenta: wpisał reguły przekierowania do pliku CLAUDE.md i poprosił Claude Code, żeby wielkich plików nie czytał sam, tylko oddawał je tańszemu modelowi. Wychodziło średnio. Model czytał instrukcję, czasem się do niej stosował, a czasem po prostu otwierał plik, bo tak było prościej. Dopiero twarda blokada sprawiła, że przekierowanie w ogóle działało, a delegowany odczyt hurtowy zużywa średnio o jakieś 90% mniej tokenów niż czytanie pliku wprost.

Ta liczba obiegła branżę i jest najmniej ciekawą częścią historii. Zmierzono ją na jednym monorepo w Javie, w czterech scenariuszach dobranych przez samego autora, więc mówi, ile dało się zaoszczędzić u Spotify, a nie ile zaoszczędzisz ty. Pod nią leży jednak obserwacja, która przenosi się wszędzie, bo większość tego, co agent zżera w kontekście, to nie rozumowanie, tylko wynik działania narzędzi, którego drogi model nigdy nie musiał zobaczyć.

Powyżej 350 linii Claude nie dostaje pliku do ręki

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Anthropic blokuje destylację Claude'a, a za pomyłki filtra płaci klient
Bezpieczeństwo

Anthropic blokuje destylację Claude'a, a za pomyłki filtra płaci klient

4 min

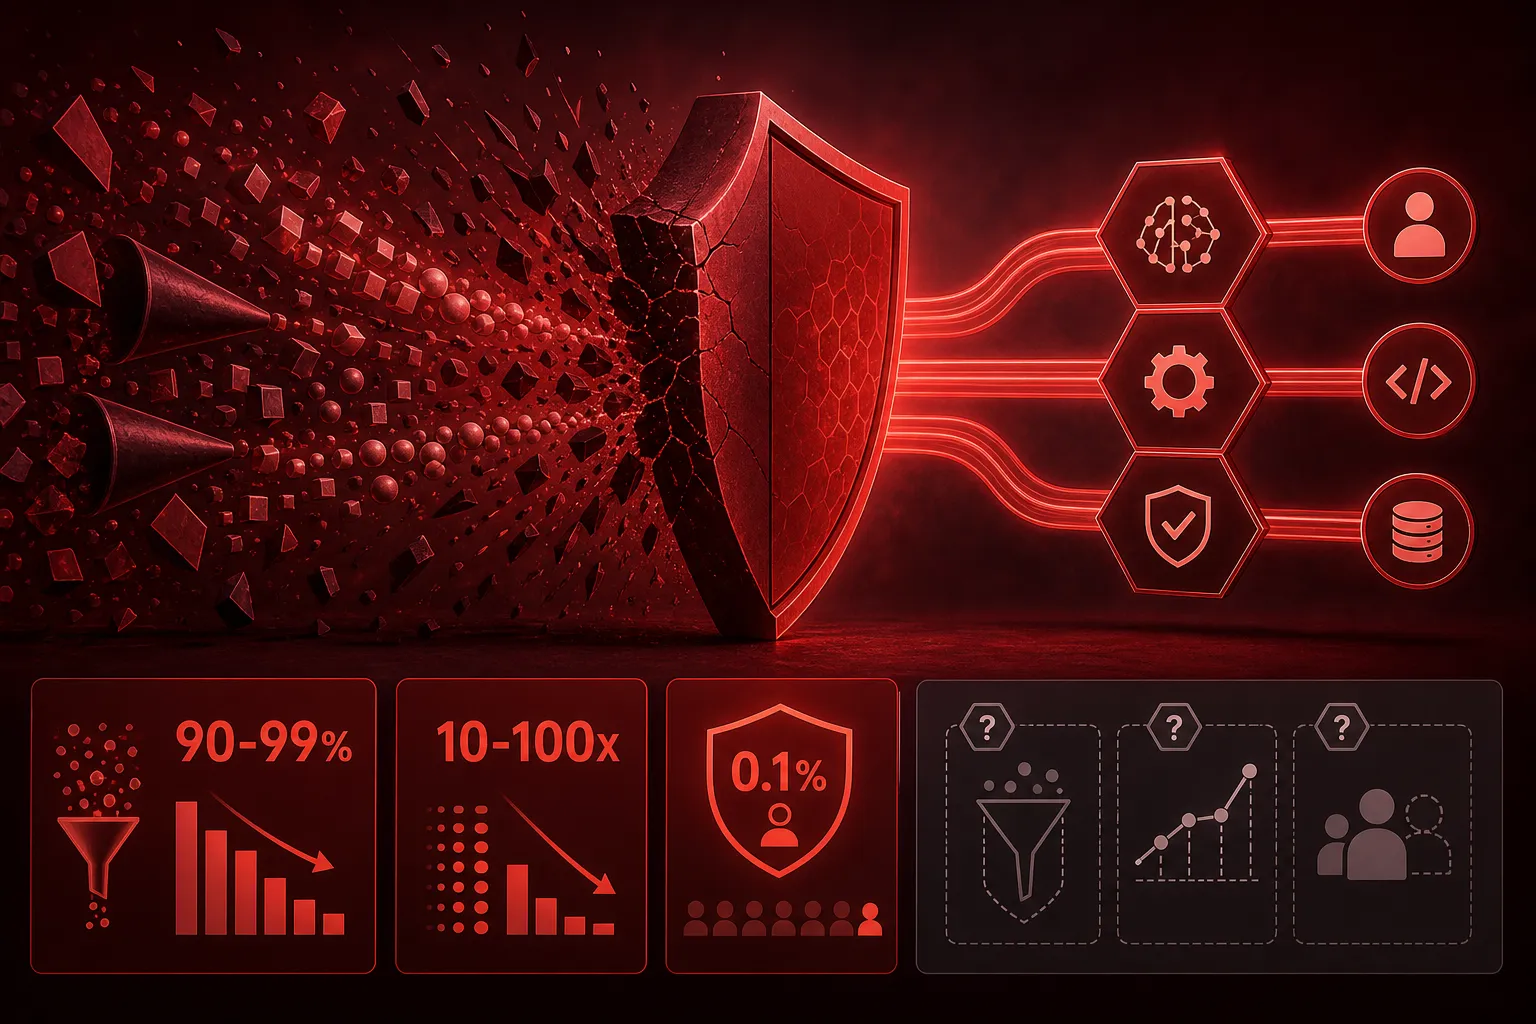
Anthropic stawia trzy bariery przeciw destylacji Claude'a, czyli uczeniu tańszych modeli konkurencji na jego rozumowaniu, które daje w SWE-bench Verified 80,4% wobec 71,8% przy samych streszczeniach. Konta API założone od 31 sierpnia 2026 nie mogą edytować wcześniejszych tur rozmowy, a zapytania do najnowszych modeli sprawdza dwustopniowy klasyfikator. Od 24 września klient płaci też za zablokowane zapytania, więc przy deklarowanym progu 0,1% fałszywych alarmów agent z tysiącami wywołań dziennie zapłaci za kilka odmów, dlatego liczyłbym je we własnych logach.

Obraz mieści trzy razy więcej treści na token, ale potrafi po cichu przekłamać identyfikator
Premiera / Narzędzie

Obraz mieści trzy razy więcej treści na token, ale potrafi po cichu przekłamać identyfikator

5 min

pxpipe, otwartoźródłowe proxy dla Claude Code, przepisuje najcięższe fragmenty kontekstu na gęsto zadrukowane obrazy PNG, bo model płaci za obraz według pikseli, a nie tekstu: około 3,1 znaku na token obrazu wobec jednego na token tekstowy. Rachunek spada o 59-70% liczone od początku do końca, a w nagraniu demo sesja kończy się na 6,06 dolara zamiast 42,21. Problem w tym, że obrazowanie jest stratne i model po cichu zmyśla przekłamane znaki, więc identyfikatory, sekrety i najświeższe tury zostają tekstem.

Model przeczytał cały log dwa razy, żeby wyłuskać trzy linijki
Premiera / Narzędzie

Model przeczytał cały log dwa razy, żeby wyłuskać trzy linijki

4 min

Tejas Chopra prosił Claude'a o wskazanie awarii w logach, a jedno pytanie zjadło dwa okna kontekstowe i 287 dolarów miesięcznie, bo model raz za razem czytał całe logi, by wyłuskać trzy istotne linijki. Tak powstał Headroom, otwarta warstwa przycinająca kontekst, zanim ten doleci do modelu: wycina zbędne znaki z JSON-a (około 30% oszczędności), a oryginał chowa lokalnie na wypadek, gdyby model potrzebował pełnych danych. Chopra reklamuje 700 tysięcy dolarów oszczędności w pięć miesięcy, ale mocniejsza jest sama diagnoza: większość tego, czym karmimy modele, jest zbędna, a płacimy za wszystko.