SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Model / Badania

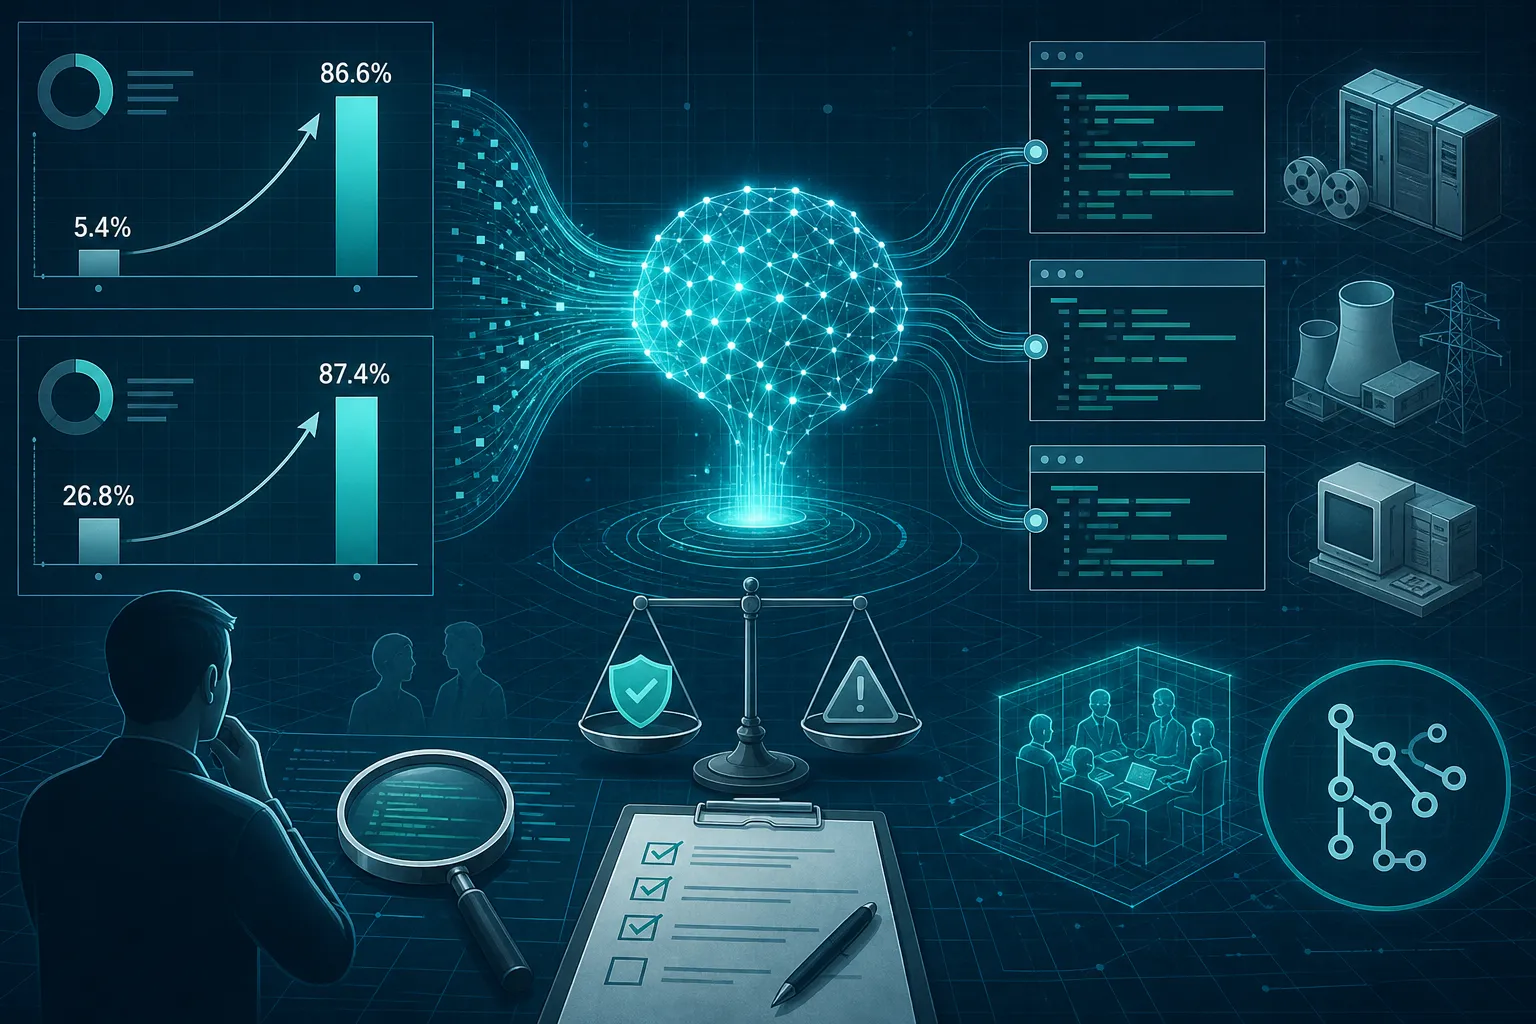
OpenAI: skok z 5,4 do 86,6% w migracji kodu z COBOL-a na własnym teście

OpenAI podaje, że GPT-6.1 Sol przepisuje programy z COBOL-a na Javę, Pythona czy Rusta ze skutecznością 86,6%, podczas gdy starszy GPT-5.6 Sol miał 5,4%. Ten test firma sama zaprojektowała i ukryła, więc wynik trzeba przyjąć na słowo. Drugi, MultiLangBench, w którym GPT-6 Astra buduje od zera silnik zgodny z SQLite w 20 językach (87,4%), leży na GitHubie i da się go sprawdzić. Kto utrzymuje stary kod, powie sobie więcej, gdy powtórzy tę metodę na własnym programie i porówna wyniki bajt po bajcie.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Model / Badania  ·  4 min  · 
OpenAI: skok z 5,4 do 86,6% w migracji kodu z COBOL-a na własnym teście
Ilustrację przygotowała AI.

Według danych IBM, które przytacza OpenAI, COBOL obsługuje ponad 40% systemów bankowości internetowej i 95% transakcji w bankomatach, a w Fortranie liczy się prognozy pogody i analizy bezpieczeństwa reaktorów jądrowych. Ten kod działa od dziesięcioleci, ludzie, którzy go pisali, często dawno odeszli z firm, a część reguł biznesowych istnieje już tylko w samym programie. Modele AI radzą sobie z takimi językami słabo, bo kodu w nich było w danych treningowych ułamek tego, co w Pythonie czy JavaScripcie. OpenAI opisało na swoim blogu, jak bardzo jego najnowsze modele poprawiły się właśnie tutaj, i podało liczbę, która robi wrażenie: na teście przenoszenia programów z COBOL-a skuteczność wzrosła z 5,4% do 86,6%.

Ten test ma towarzysza. Pierwszy sprawdza przepisywanie COBOL-a na nowoczesne języki, a drugi, nazwany MultiLangBench, budowanie silnika bazy danych od zera w 20 językach. Oba OpenAI samo zaprojektowało, samo przeprowadziło i samo opisało, a innego źródła tych liczb na razie nie ma. Moim zdaniem wynik z bazą danych da się dziś sprawdzić samodzielnie, a ten efektowniejszy, z COBOL-em, trzeba na razie przyjąć na słowo.

Migracja z COBOL-a i pułapka zaokrągleń

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

GPT-6 Sol i Luna: o połowę taniej w API, z wynikami dobranymi przez OpenAI
Model / Badania

GPT-6 Sol i Luna: o połowę taniej w API, z wynikami dobranymi przez OpenAI

4 min

OpenAI obniżyło o połowę ceny GPT-6 Sol i Luny w API: Sol kosztuje 2 dolary zamiast 4 za milion tokenów wejściowych i 10 zamiast 20 za wyjściowe, choć punktem odniesienia są promocyjne ceny GPT-5.6. Ważniejsza jest zmiana w pamięci podręcznej promptów, bo przełączanie poziomu rozumowania i narzędzi nie kasuje już zapamiętanego kontekstu, a GitHub zmniejszył w Copilocie o ponad połowę udział tokenów liczonych od zera. W DeepSWE Sol rozwiązuje 68,8% zadań o około 80% taniej niż Claude Fable 5, ale porównania OpenAI dobrało samo, więc koszt warto zmierzyć na własnym kodzie.

OpenAI zabiera GPT-5.5 i nie zostawia furtki dla spóźnialskich
Premiera / Narzędzie

OpenAI zabiera GPT-5.5 i nie zostawia furtki dla spóźnialskich

4 min

Od 14 października GPT-5.5 przestaje odpowiadać w ChatGPT i w Codexie na wszystkich planach, ale wywołania przez API OpenAI działają dalej, więc zacznij od sprawdzenia, którędy twoje zadania wołają model. Podmiana na gpt-5.6-sol zajmuje chwilę, gorzej z miejscami, których nikt nie ogląda: zadaniem wrzuconym kiedyś do harmonogramu albo krokiem w CI z flagą --model gpt-5.5, bo takie wywołanie nie przełączy się po cichu, tylko wróci błędem. Sol jest o jedną trzecią tańszy na tokenach wyjściowych od modelu, który znika, tyle że ta promocyjna stawka obowiązuje tylko do 21 listopada.

GPT-6 Sol i Luna: OpenAI tnie ceny o połowę, ale liczyć trzeba koszt zadania
Model / Badania

GPT-6 Sol i Luna: OpenAI tnie ceny o połowę, ale liczyć trzeba koszt zadania

4 min

OpenAI wypuściło 22 września modele GPT-6 Sol i Luna o połowę tańsze od poprzedników, ale przy agencie programistycznym liczy się koszt całego zadania, a nie cena tokenu. Sol zdobywa 68,8% na DeepSWE, teście agentów naprawiających prawdziwe repozytoria, czyli niewiele mniej niż Claude Fable 5 przy rachunku niższym o około 80%. Niezależne pomiary studzą jednak entuzjazm, bo Artificial Analysis daje Solowi 48 punktów wobec 58 dla Claude Opus 5.5, a tańszy DeepSeek V4.1 Flash wyprzedza Lunę w programowaniu.