Premiera / Narzędzie
OpenRouter Fusion: panel modeli i sędzia zamiast jednego pytania
OpenRouter uruchomił 14 czerwca Fusion: ten sam prompt idzie do panelu kilku modeli, a osobny model-sędzia zestawia ich odpowiedzi i pisze z nich jedną. Na benchmarku DRACO trójka tańszych modeli sięgnęła 64,7%, o włos od najlepszego solisty Claude Fable 5 (65,3%), i to za połowę ceny. Sporo zysku bierze się nie z różnorodności modeli, tylko z drugiej próby i redakcji: Opus 4.8 sparowany sam ze sobą podskoczył z 58,8% do 65,5%. Fusion nie zastępuje modelu do kodu i trwa dwa do trzech razy dłużej, więc opłaca się dopiero tam, gdzie pomyłka kosztuje tydzień pracy.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 4 min ·
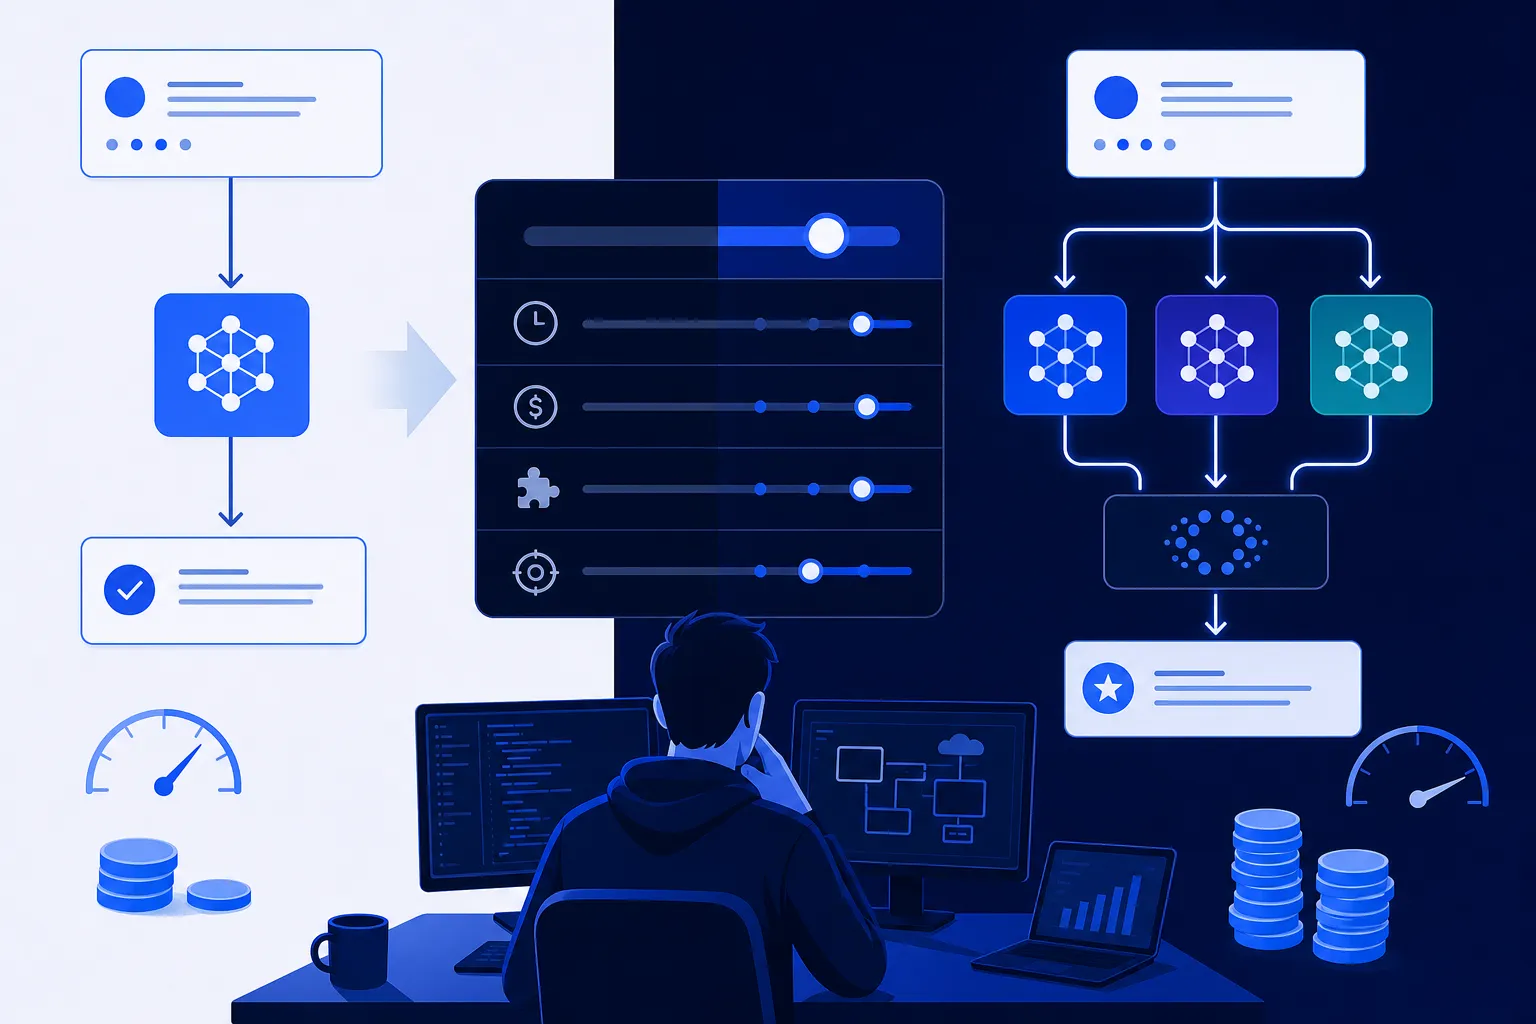
Trzy tanie modele, zgadane ze sobą, doganiają najlepszego solistę w teście, i to za połowę ceny. Tę liczbę OpenRouter, pośrednik dający jedno API do setek modeli od różnych dostawców, pokazał przy premierze funkcji Fusion 14 czerwca. Zamiast pytać jeden model, wysyłasz ten sam prompt do panelu kilku naraz. Osobny model w roli sędziego czyta wszystkie odpowiedzi i wypisuje, w czym się zgadzają, gdzie sobie przeczą i czego żaden nie zauważył, a na końcu jeszcze inny model, prowadzący, pisze ostateczną odpowiedź opartą na tej analizie. Całość liczy się po stronie serwera, więc wołasz to jedną linijką, tak samo jak zwykły model.
Że kilka modeli razem wypada lepiej niż jeden, wiadomo w uczeniu maszynowym od dawna, więc sam pomysł mnie nie porusza. Ciekawe są dwie liczby z testu. Pierwsza mówi o kosztach, druga o tym, skąd ten zysk się w ogóle bierze.
Trzy tanie modele biją jednego drogiego
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.