Premiera / Narzędzie
Pięć podejść agenta, jeden sędzia i żadnych testów
LLM-as-a-Verifier bierze pulę podejść agenta do jednego zadania i każe modelowi porównywać je parami, licząc przy tym nie samą notę, tylko pewność, z jaką model ją stawia. Na Terminal-Bench 2.1 model deepseek-v4-flash pojedynczym podejściem zaliczał 78,7% zadań, a wybór najlepszego z pięciu podniósł wynik do 88,0%, tyle że płaci się wtedy pięć razy zamiast raz. Ciekawszy jest drugi tryb, który ocenia jedno podejście krok po kroku, dzięki czemu beznadziejne da się przerwać po trzecim ruchu i ten rachunek raczej zbić niż napompować.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 4 min ·
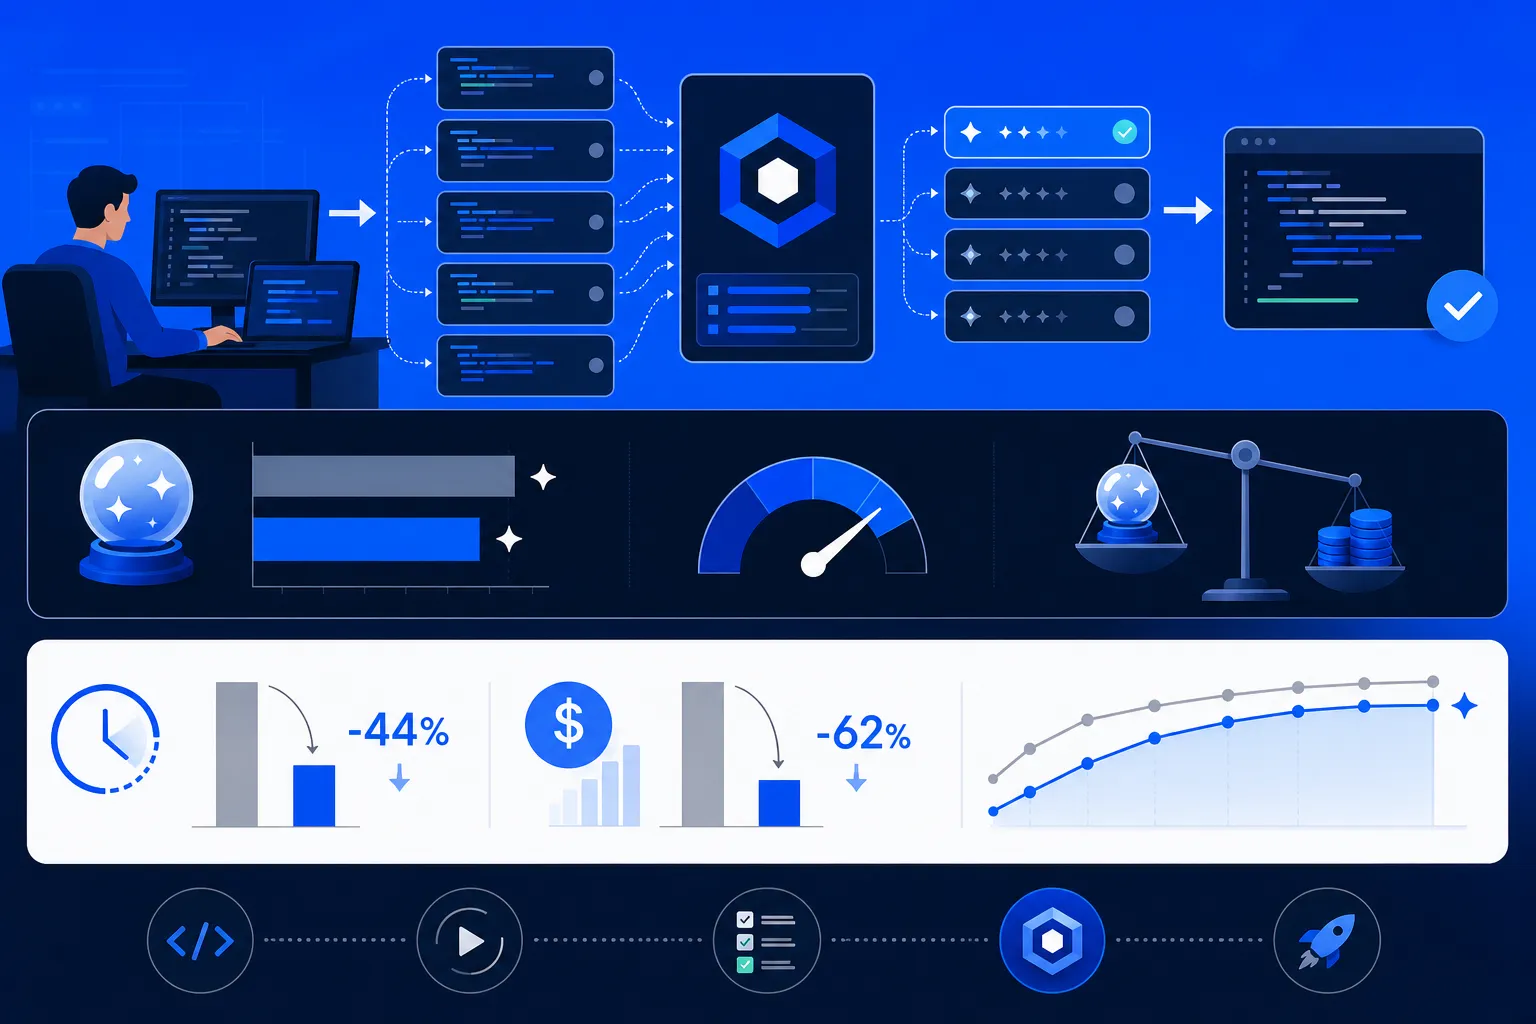
Agent dostaje zadanie, grzebie w repozytorium, zmienia trzy pliki i oznajmia, że gotowe. Jeśli akurat nie ma testu, który by to rozstrzygnął, nikt nie wie, czy trafił. Standardowe obejście jest brutalnie proste: puść agenta pięć razy i weź najlepsze podejście. Tyle że ktoś to najlepsze musi wskazać, a wskazanie zwykle oznacza dokładnie ten zestaw testów, którego nie ma.
Polecenie pip install llm-verifier instaluje bibliotekę, która próbuje wskazać zwycięskie podejście bez testów. LLM-as-a-Verifier bierze pulę podejść agenta do jednego zadania, każe modelowi porównywać je parami i zwraca indeks zwycięzcy. Nic się nie trenuje, nie dochodzi żaden osobny model oceniający, zostaje zwykłe wywołanie API z kryteriami zapisanymi normalnym zdaniem w pliku markdown. Działa to lepiej, niż się spodziewałem, i kosztuje wyraźnie więcej, niż sugerowałby opis.
Nie sama nota, tylko pewność, z jaką model ją stawia
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.