SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Analiza / Opinia

Plik SKILL.md nie uczy agenta faktów, tylko pilnuje kolejności kroków

Zhiyuan Jiang i jego zespół zebrali 8135 kontrolowanych prób i ręcznie opisali 240 przebiegów, żeby sprawdzić, dlaczego pliki SKILL.md podnoszą skuteczność agentów: w 65,7% przypadków umiejętność działa jako kotwica proceduralna, a podanie faktu, którego model nie znał, tłumaczy raptem 4,5%. Trafność sięgnięcia po właściwy plik leci z 29,6% przy pięciu umiejętnościach do 3,3% przy stu, choć skuteczność w zadaniach zostaje stabilna, bo agentowi wystarcza sąsiedni plan. Wniosek jest taki, że robotę robi ponumerowana lista kroków, a nie opis kontekstu projektu.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Analiza / Opinia  ·  4 min  · 
Plik SKILL.md nie uczy agenta faktów, tylko pilnuje kolejności kroków
Ilustrację przygotowała AI.

Zhiyuan Jiang i jego zespół zrobili z umiejętnościami dla agentów coś, czego przy tej modzie prawie nikt nie robił: zamiast po raz kolejny mierzyć, czy podnoszą skuteczność, sprawdzili, dlaczego ją podnoszą. Chodzi o te pliki markdown, które podrzucasz agentowi, żeby wiedział, jak akurat u ciebie wygląda migracja bazy albo wypuszczenie wydania. Zespół zebrał w jedną tabelę 8135 kontrolowanych prób, prowadzonych na kilku benchmarkach, w różnych środowiskach agentowych i na różnych modelach, a potem przejrzał po kolei 240 przebiegów i ręcznie opisał, co się w każdym z nich wydarzyło.

Wynik jest niewygodny dla każdego, kto buduje rozbudowaną bibliotekę umiejętności. W 65,7% wszystkich przypadków użycia umiejętności zadziałała ona jako kotwica proceduralna: przytrzymała agenta przy kolejności kroków, w której inaczej by się pogubił. Podanie faktu, którego model nie znał, tłumaczy 4,5%. Najdłużej ślęczy się nad opisem kontekstu: tłem projektu, wyjaśnieniami, dlaczego akurat tak. Ta część pliku w większości nie robi roboty, a robi ją ponumerowana lista kroków.

Kotwica proceduralna brzmi abstrakcyjnie tylko do momentu, w którym przypomnisz sobie własny przebieg z agentem: każdy pojedynczy krok był mu doskonale znany, a mimo to odpalił testy przed migracją i wrócił do rzeczy zrobionej 10 minut wcześniej. Plik nie dokłada mu w takiej sytuacji wiedzy, tylko odbiera swobodę w układaniu kolejności.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Microsoft trenuje prompty agentów tak, jak trenuje się sieci neuronowe Premiera / Narzędzie

Microsoft trenuje prompty agentów tak, jak trenuje się sieci neuronowe

4 min

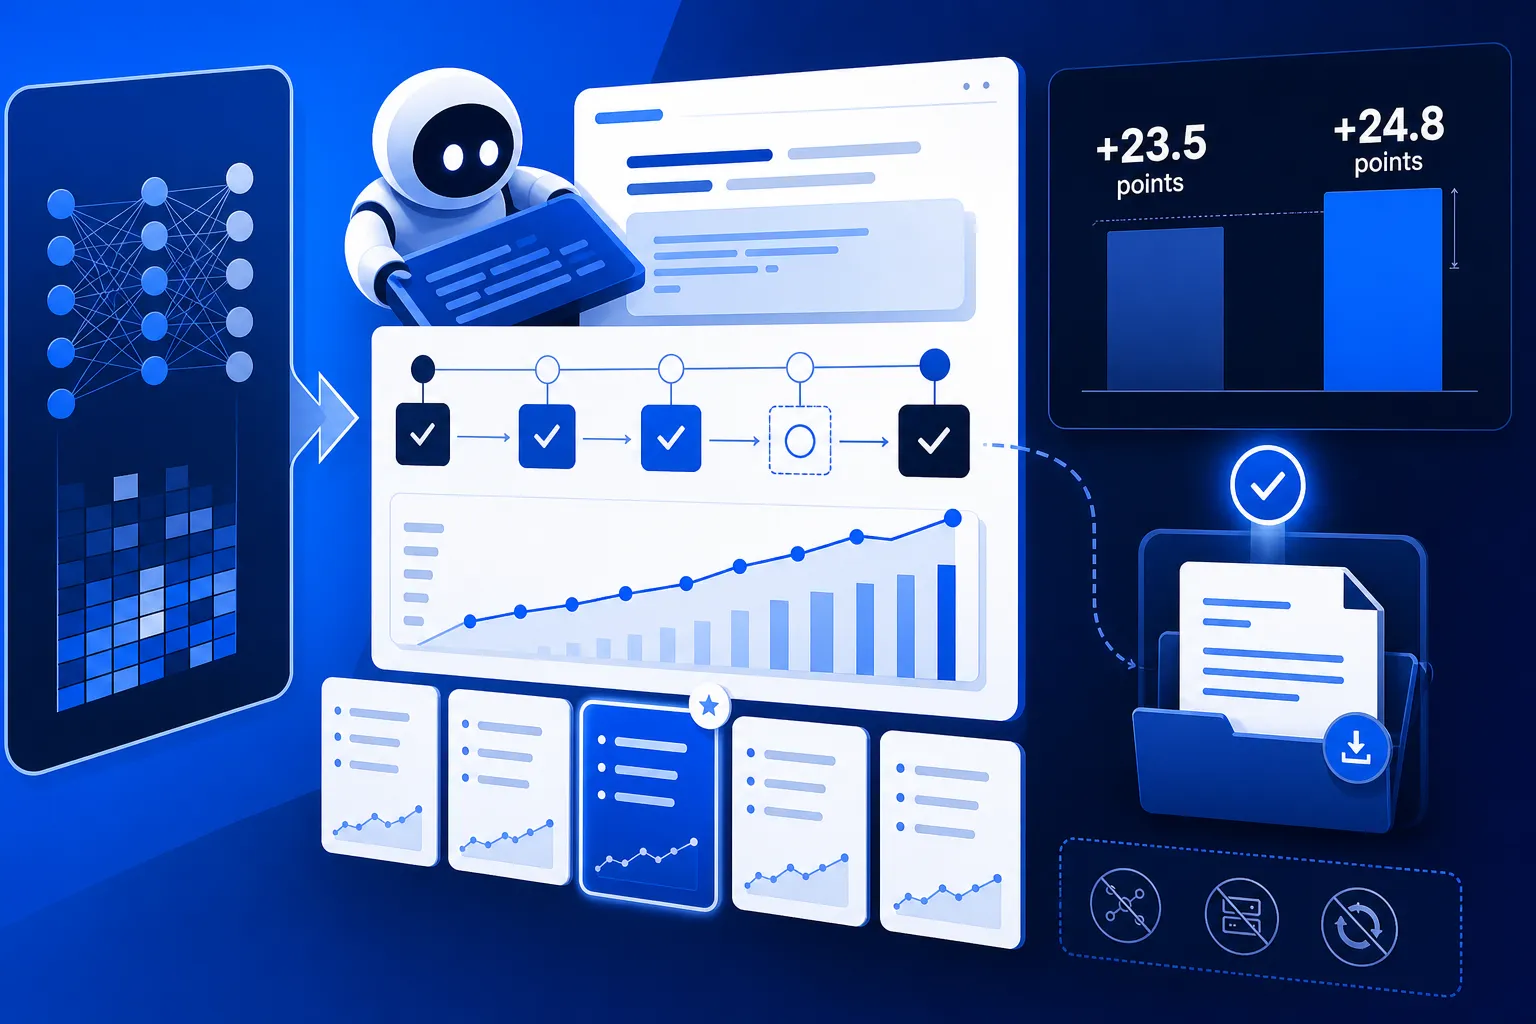
Microsoft Research wypuścił SkillOpt, narzędzie, które zamiast dotrenowywać model, trenuje sam plik z instrukcją dla agenta. Osobny optymalizator proponuje zmiany w dokumencie i zachowuje tylko te, które realnie podnoszą wynik na odłożonym zbiorze zadań walidacyjnych. Na sześciu benchmarkach i siedmiu modelach SkillOpt wypada najlepiej lub na równi we wszystkich 52 przypadkach, a na GPT-5.5 dorzuca średnio ponad 23 punkty skuteczności. Efektem jest jeden plik best_skill.md, bez dodatkowych kosztów w trakcie pracy. Wyniki pochodzą jednak od autorów metody.

Co się dzieje z uwagami, które wpisujesz agentowi tuż przed końcem sesji? Premiera / Narzędzie

Co się dzieje z uwagami, które wpisujesz agentowi tuż przed końcem sesji?

5 min

Warp opisał u Anthropica układ dwóch umiejętności: bazowa trzyma zasady przeglądu kodu, a druga rusza z harmonogramu, zbiera uwagi ludzi i proponuje jedną małą poprawkę do pliku bazowego, która wchodzi zwykłym pull requestem. Publiczne demo z agentem porządkującym zgłoszenia pokazuje całą pętlę, a komenda Skill Doctor ocenia wcześniejsze rozmowy agenta i podsuwa gotowy diff. Kupuję ten wzorzec z jednym zastrzeżeniem: uwagi ludzi prawie zawsze mówią, czego agentowi zabrakło, więc plik SKILL.md tylko puchnie, a im dłuższy, tym gorzej agent trafia do właściwej wiedzy.

Agent czyta AGENTS.md aż za dokładnie Analiza / Opinia

Agent czyta AGENTS.md aż za dokładnie

4 min

Zespół laboratorium SRI z ETH w Zurychu sprawdził na SWE-bench i na zgłoszeniach z repozytoriów, w których deweloperzy sami napisali AGENTS.md, czy taki plik pomaga agentom do programowania. Odsetek rozwiązanych zadań nie rośnie, a koszt pracy modelu idzie w górę o ponad 20%, bo agent posłusznie wykonuje każde polecenie z pliku, przegląda więcej plików i więcej testuje. Dlatego zostawiłbym w AGENTS.md tylko to, czego agent nie wyczyta z kodu, na przykład że testy wymagają uruchomionej lokalnej bazy.