SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Model / Badania

Samoewolucja M2.7? Pod spodem sto rund prób i błędów

MiniMax wypuścił M2.7 i oparł całą premierę na jednym słowie: samodoskonaleniu. Pod spodem kryje się pętla ponad stu rund, w których model sam przepisywał kod swojego harnessu, odpalał testy i cofał nieudane zmiany, aż wyciągnął 30% poprawy na wewnętrznych zestawach. Na MLE Bench Lite od OpenAI zdobył średnio 66,6% medali, za Opusem 4.6 (75,7%) i GPT-5.4 (71,2%), a w samym kodowaniu ma 56,22% na SWE-Pro. Problem w tym, że wszystkie te liczby zmierzył sam MiniMax, bez niezależnej weryfikacji.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Model / Badania  ·  3 min  · 
Samoewolucja M2.7? Pod spodem sto rund prób i błędów
Ilustrację przygotowała AI.

MiniMax wypuścił M2.7 i całą premierę oparł na jednym słowie: samodoskonalenie. Firma twierdzi, że to jej pierwszy model, który realnie brał udział we własnym rozwoju, bo pomagał budować i stroić własny harness. To mocne słowo, więc warto rozłożyć, co naprawdę się pod nim kryje.

M2.7 to kolejny krok, tyle że tym razem MiniMax sprzedaje nie sam wynik, lecz sposób, w jaki go osiągnął.

Samodoskonalenie to pętla stu poprawek, nie magia

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

M2.7 koduje blisko Opusa i sam stroi swój harness Model / Badania

M2.7 koduje blisko Opusa i sam stroi swój harness

3 min

MiniMax wydał M2.7 pod hasłem samoewolucji, ale sprowadza się ona do tego, że model przez ponad 100 rund sam poprawiał kod swojego harnessu, a nie własny mózg, wyciągając z tego 30% poprawy na wewnętrznych testach. Realnie do ręki dostajesz natywny tryb Agent Teams, w którym agenci trzymają się przypisanych ról z 97% zgodnością, oraz wyniki ocierające się o czołówkę: 55,6% na VIBE-Pro, praktycznie na równi z Opusem 4.6. Haczyk jest ten sam co przy M2.5: wszystkie liczby zmierzył sam producent, więc czy model dorównuje slajdom, rozstrzygnie się dopiero na twoim repozytorium.

MiniMax dorównuje Opusowi w kodzie za jedną dziesiątą ceny Model / Badania

MiniMax dorównuje Opusowi w kodzie za jedną dziesiątą ceny

3 min

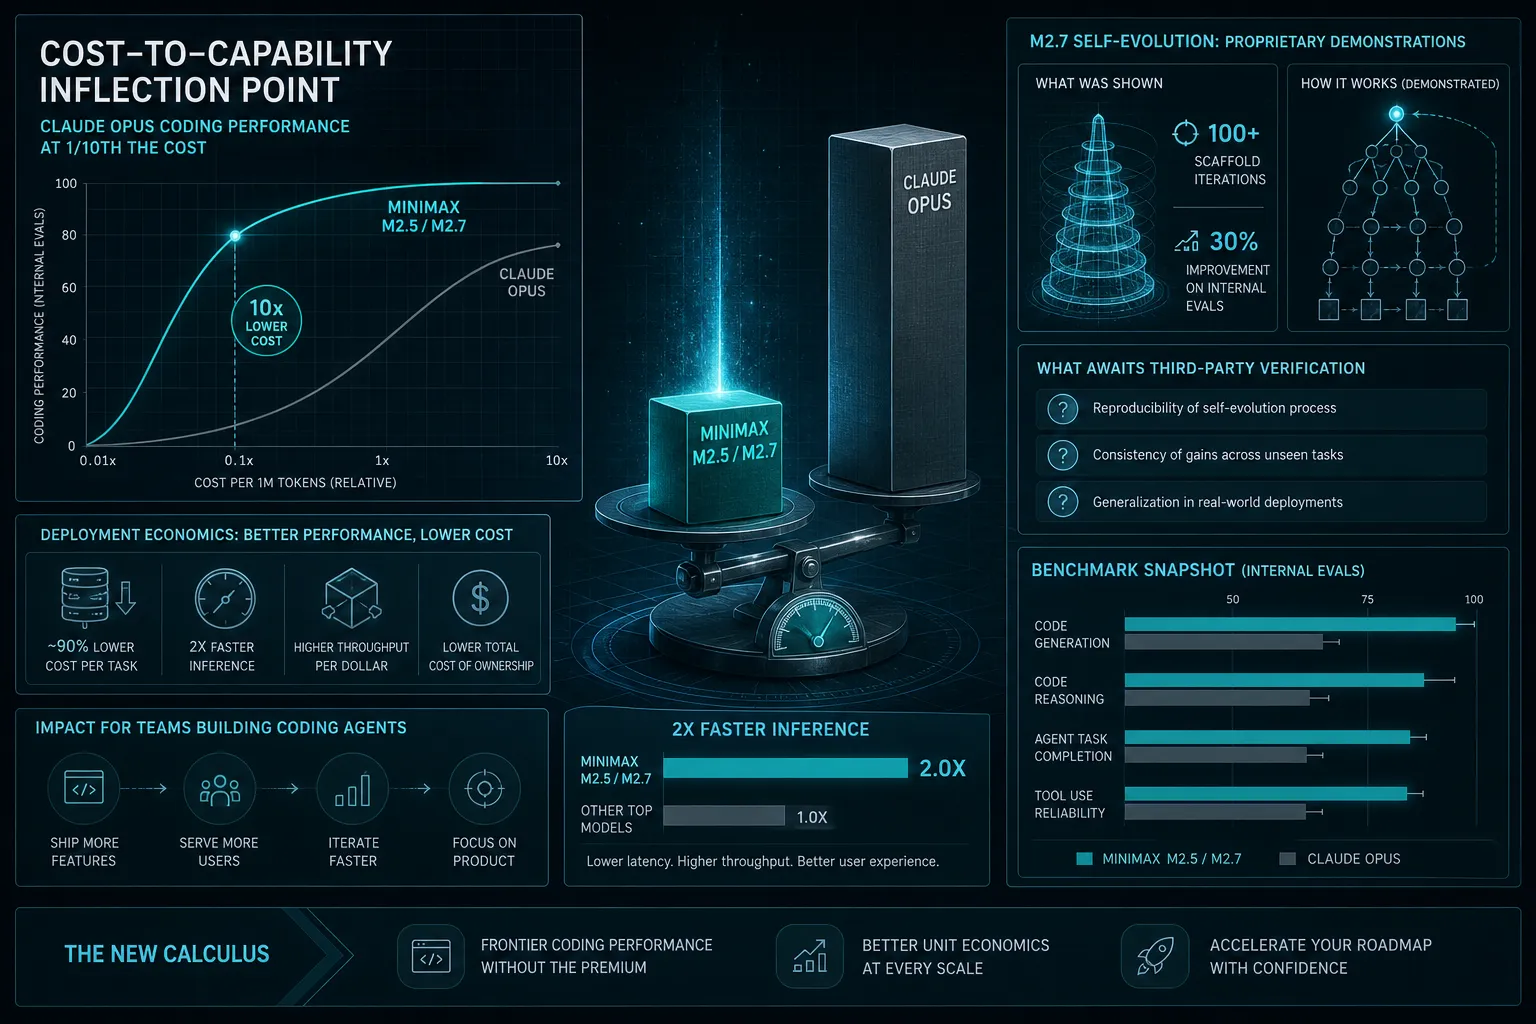
MiniMax wypuścił model M2.5, który na SWE-Bench Verified osiąga 80,2%, minimalnie przed Claude Opus 4.6, ale za jedną dziesiątą jego ceny. Liczy się też szybkość: serwowany ze stu tokenami na sekundę kończy zadanie w 22,8 minuty, tyle samo co Opus, więc pierwszy raz tani model nie jest jednocześnie wolny. To otwiera drogę agentom działającym w tle bez przerwy. Większość benchmarków MiniMax zmierzył jednak sam, więc M2.5 to dziś gotowy kandydat do podmiany Opusa, ale obietnicę samodoskonalącego się M2.7 lepiej traktować ostrożnie.

Pod ceną M2.5 stoi własna ramka treningowa i 200 tysięcy środowisk Model / Badania

Pod ceną M2.5 stoi własna ramka treningowa i 200 tysięcy środowisk

4 min

MiniMax ujawnił, co stoi za ceną M2.5: framework treningowy Forge, 200 tysięcy środowisk z realnej pracy firmy i algorytm CISPO stabilizujący trening modelu MoE. Pod różnymi harnessami model wyciąga 79,7% (Droid) i 76,1% (OpenCode) na SWE-Bench Verified, przed Opusem 4.6, a M2.5-Lightning kosztuje 2,40 dolara za milion tokenów wyjścia. Firma twierdzi, że 30% jej codziennych zadań robi sam model, ale wszystkie nowe benchmarki zbudowała sama. Tania inferencja otwiera agenty, na które dotąd nie było budżetu, jeśli model dowiezie poza własnym treningiem.