Premiera / Narzędzie
Stary SWE-bench dawał ponad 80%, nowy ścina czołówkę do 23,3%
Scale AI wypuściło SWE-Bench Pro, zestaw 1865 zadań z 41 utrzymywanych repozytoriów, na którym najlepszy GPT-5 rozwiązał tylko 23,3% problemów, podczas gdy na starym SWE-benchu czołówka od miesięcy melduje wyniki powyżej 80%. Zadania są długodystansowe i wieloplikowe, a część pochodzi z prywatnych repozytoriów, których modele nie widziały na treningu, więc nie da się ich ugrać z pamięci. Surowa miara pass@1 i interes Scale każą czytać wynik ostrożnie, ale sygnał jest jasny: przy dłuższej robocie w firmowym projekcie wciąż jesteśmy bliżej wspomagania niż automatyzacji.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 3 min ·
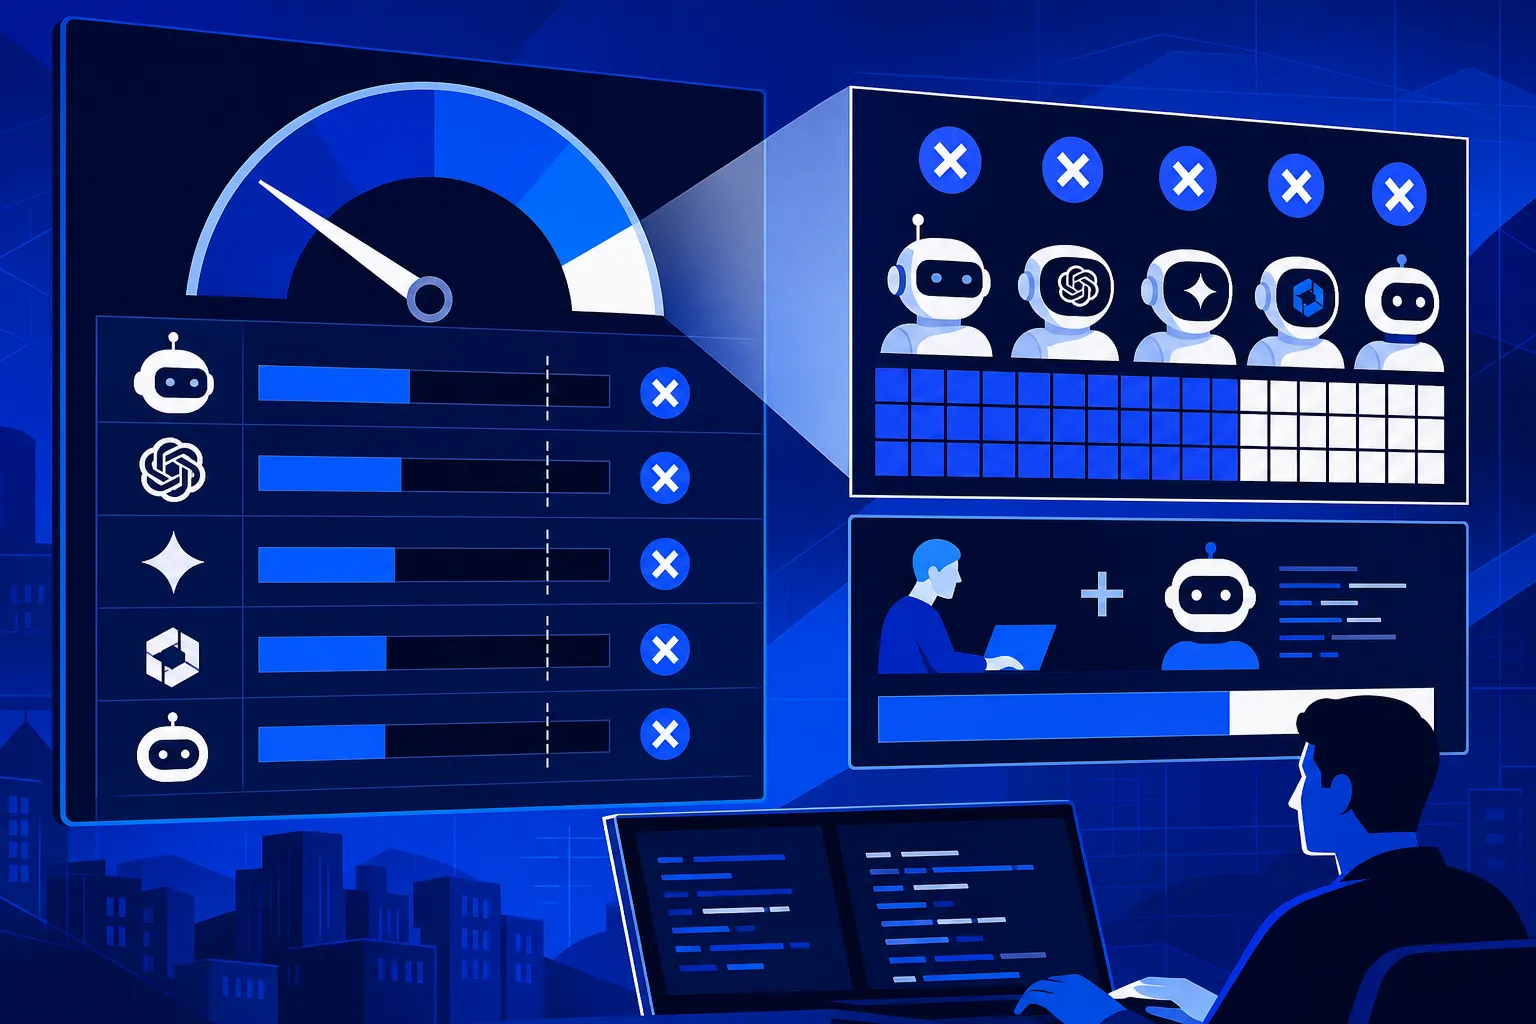
Scale AI wypuściło SWE-Bench Pro, nowy zestaw zadań do oceny modeli piszących kod, i wynik najlepszego z nich robi wrażenie w drugą stronę niż zwykle. GPT-5, lider zestawienia, rozwiązał 23,3% zadań. Dla porównania na starym SWE-benchu, z którego ten nowy wyrasta, czołówka od miesięcy melduje wyniki grubo powyżej 80%. Ta sama klasa modeli, inny zestaw zadań i skuteczność spada o dwie trzecie.
Najpierw, czym w ogóle jest SWE-bench, bo bez tego liczba nic nie znaczy. To zbiór prawdziwych zgłoszeń z publicznych repozytoriów: model dostaje opis błędu albo brakującej funkcji i ma napisać poprawkę, która przechodzi testy projektu. Przez ostatni rok stał się domyślną miarą tego, jak dobrze agent radzi sobie z realnym kodem, i właśnie dlatego wyniki zaczęły ocierać się o sufit. Scale przekonuje, że to sufit trochę fałszywy, i buduje wersję, w której jest znacznie więcej miejsca w górę.
Różnica nie leży w liczbie zadań, tylko w ich charakterze. SWE-Bench Pro to 1865 problemów z 41 repozytoriów, które ktoś realnie utrzymuje: aplikacje biznesowe, usługi B2B, narzędzia dla programistów. Scale opisuje te zadania jako długodystansowe, czyli takie, nad którymi zawodowy programista siedziałby godziny, a bywa, że dni. To bliżej kilku dni grzebania w zaległym zgłoszeniu niż szybkiej łatki na weekend. Jedno zadanie potrafi wymagać poprawek w wielu plikach naraz i sporych zmian w kodzie, a nie podmiany trzech linijek pod jednym testem. Każde zostało sprawdzone przez człowieka i uzupełnione o tyle kontekstu, żeby w ogóle dało się je rozwiązać.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.