Analiza / Opinia
Trzy agenty recenzują kod lepiej niż pięć
Trzy agenty zamiast pięciu: główny pisze kod, recenzent go ocenia, a krytyk czepia się samej recenzji i przepuszcza dalej tylko uwagi poparte konkretną linijką kodu. Protokół Adversarial Review, opisany przez Erica S. Qiu w pracy z 16 sierpnia, rozwiązał najwięcej zadań na LiveCodeBench, a po jednej zmianie w promptcie, która każe krytykowi jawnie się nie zgodzić, osiągnął najwyższe F1 na SWE-PRBench. Sedno nie leży w liczbie agentów, tylko w tym, że drugi model domyślnie przytakuje, bo zgoda jest najtańsza, i nie daje drugiej opinii, dopóki nie każecie mu szukać dziur w cudzej recenzji.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Analiza / Opinia · 3 min ·
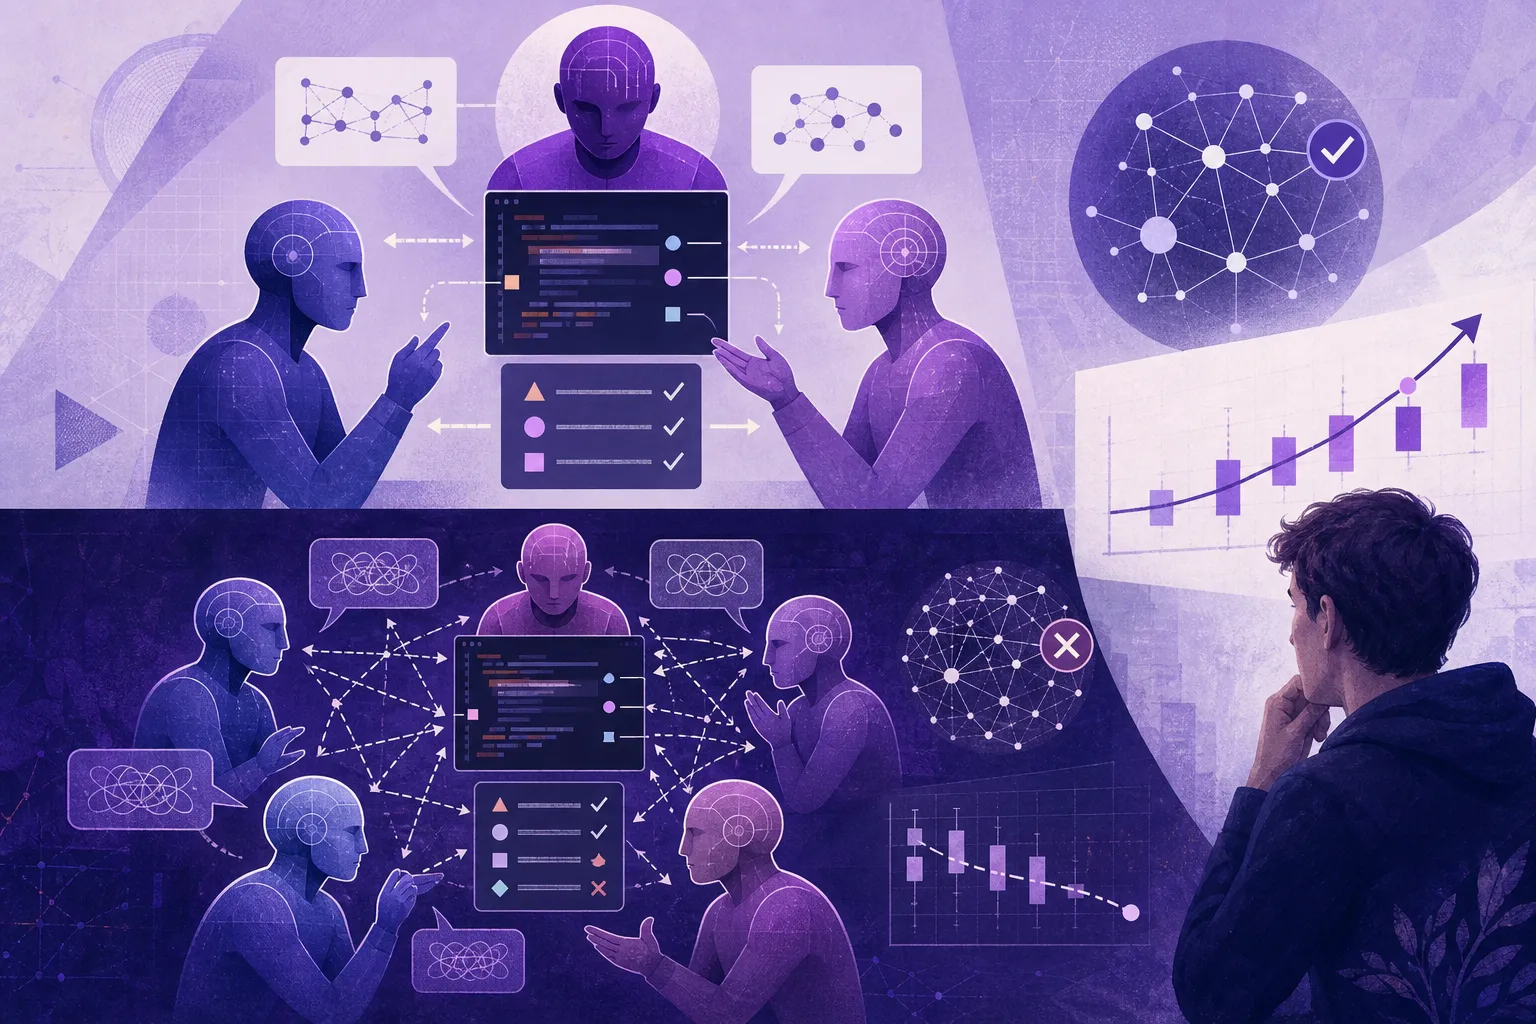
Nad jednym zadaniem programistycznym pracują tutaj tylko trzy agenty: główny pisze kod, recenzent go ocenia, a krytyk bierze pod lupę samą recenzję i musi się do niej przyczepić, zanim główny agent w ogóle dotknie plików. Tak działa Adversarial Review, czyli recenzja przez spór, protokół opisany w pracy zgłoszonej na arXiv 16 sierpnia przez Erica S. Qiu. Na LiveCodeBench, benchmarku złożonym ze świeżych zadań konkursowych, ta trójka rozwiązała ich najwięcej ze wszystkich układów, które autor porównał, i wypadła lepiej niż układ pięciu agentów.
Punkt odniesienia jest tu ważniejszy niż sama liczba. Wczesne systemy wieloagentowe budowano jak zespół z podziałem ról, w którym każdy agent dostawał własne stanowisko, tyle że przy zadaniach na poziomie całego repozytorium dokładanie kolejnych agentów w pewnym momencie przestaje cokolwiek dawać. Odpowiedzią była druga skrajność: agenty pomocnicze traktowane jak zwykłe narzędzia, które coś policzą i oddadzą wynik, przez co znika cała korzyść z tego, że mogłyby ze sobą rozmawiać. Adversarial Review celuje w środek: agenty naprawdę ze sobą rozmawiają, ale tylko o jednej rzeczy, o tym, czy recenzję da się obronić. I właśnie dlatego wygrana z układem pięciu agentów mówi tu coś o formie sporu, a nie o liczbie uczestników.
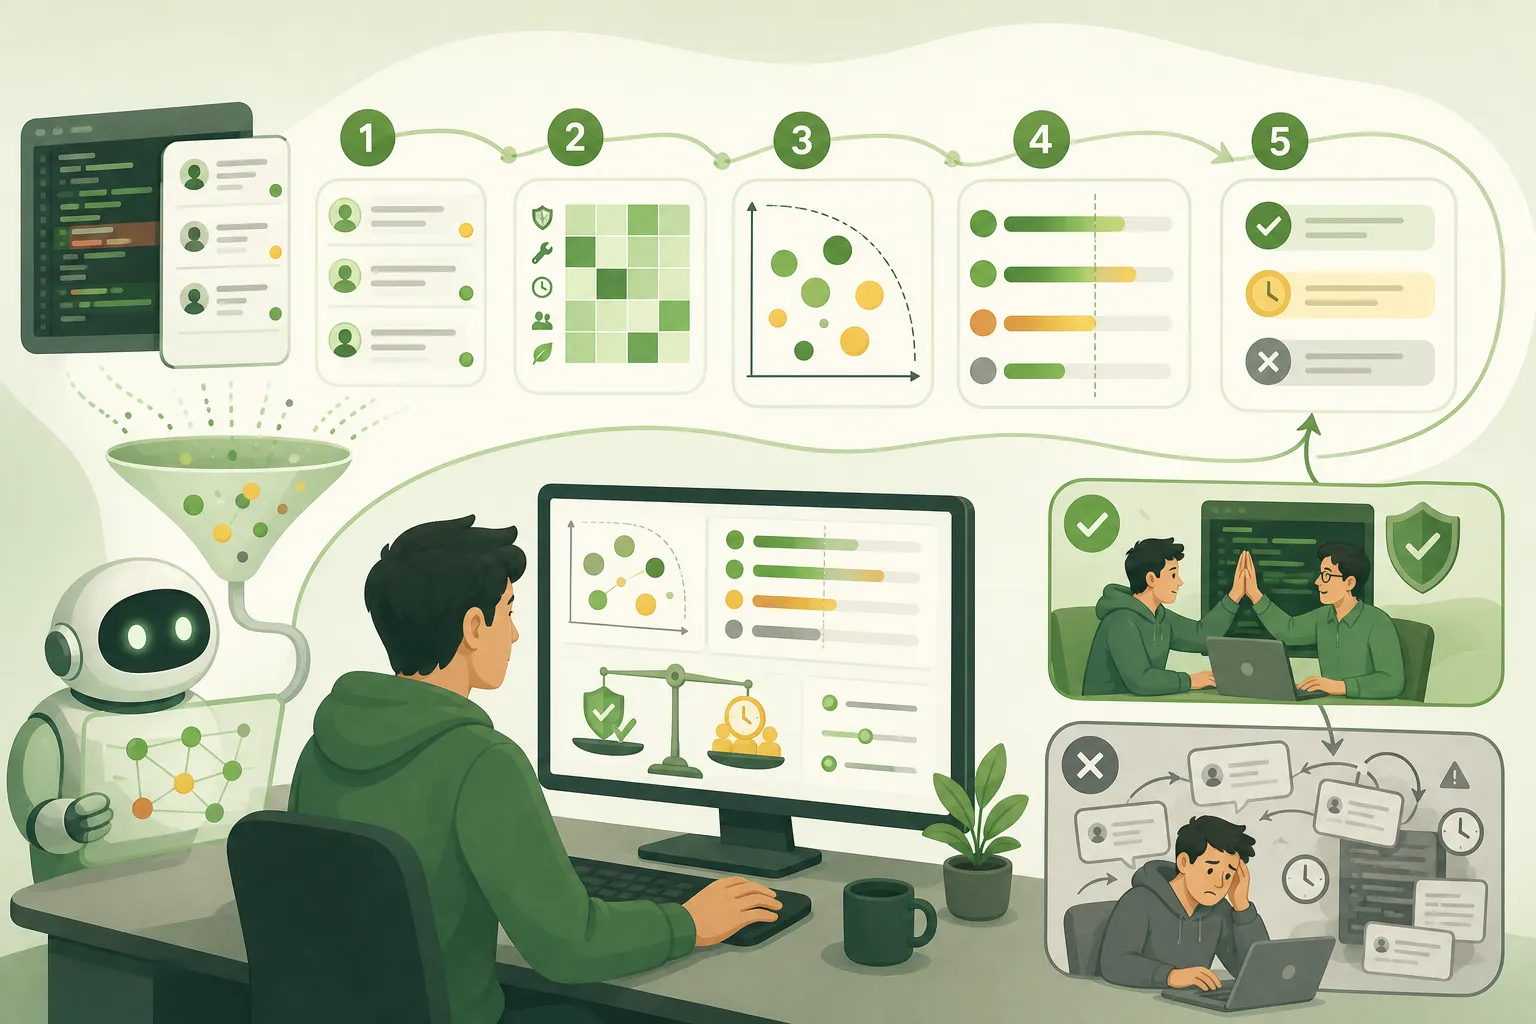
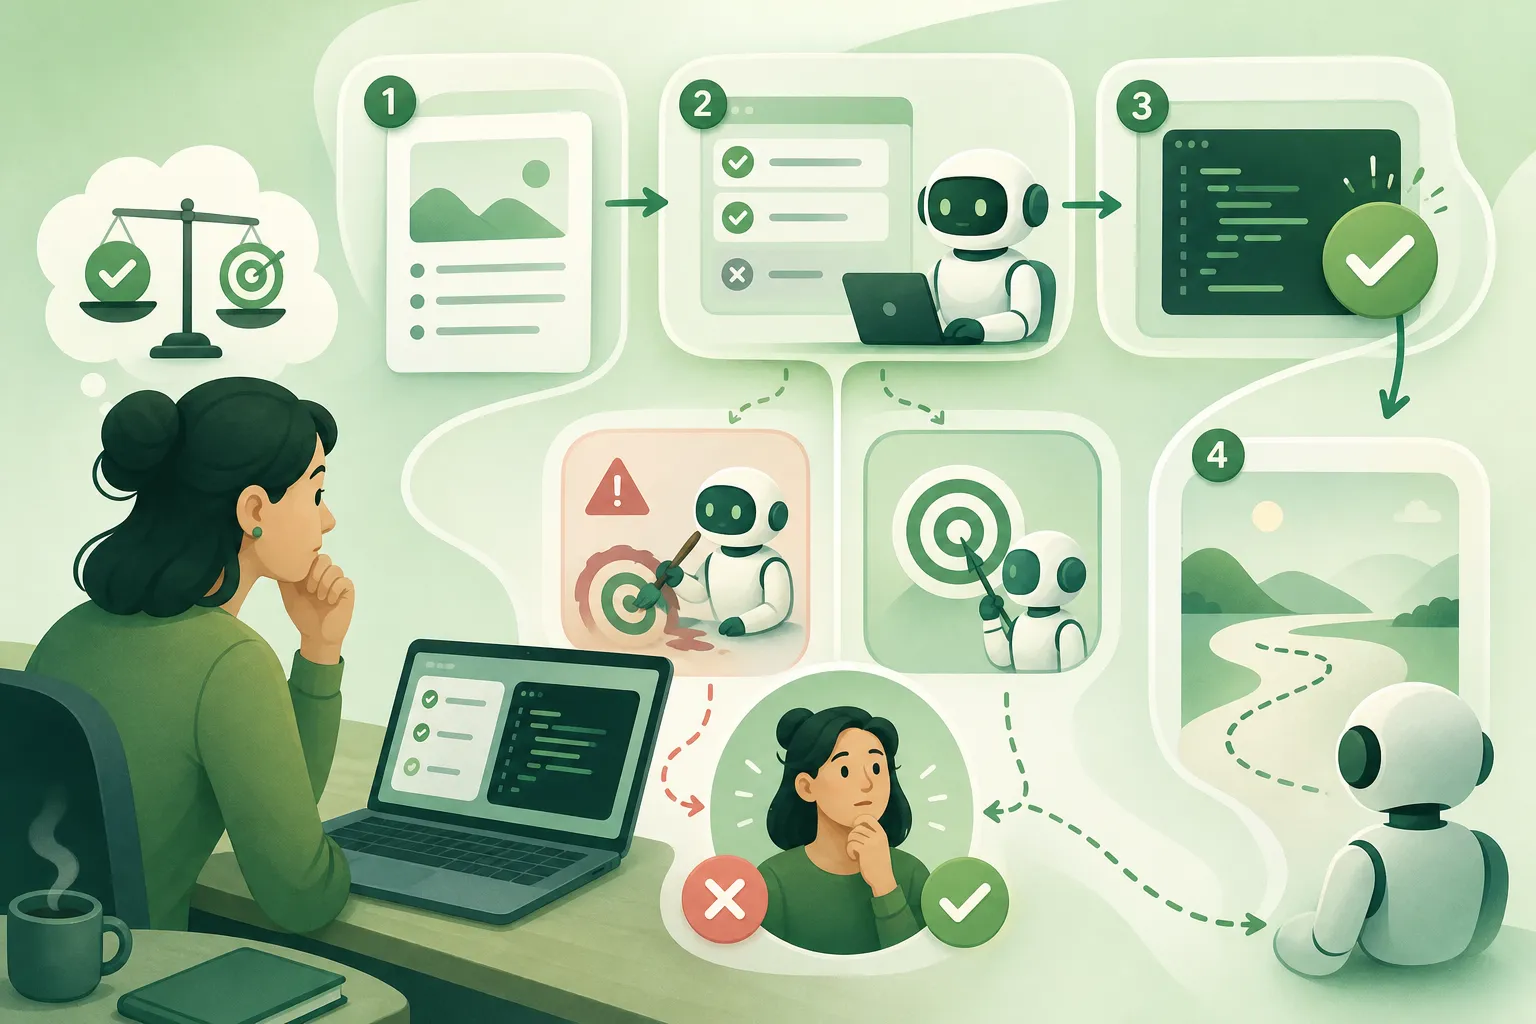
Ten podział pracy wygląda drobno, ale to na nim wszystko stoi. Krytyk nie recenzuje kodu od nowa, tylko bierze na warsztat cudzą recenzję i pyta, czy da się ją obronić dowodem z kodu, czy jest ogólnikiem, który pasowałby do dowolnego pull requesta. Dalej idzie tylko to, co przez ten filtr przeszło, więc główny agent nie dostaje listy luźnych sugestii, tylko uwagi, które ktoś już próbował podważyć.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.