SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Poradnik / Praktyka

Recenzent nie pomylił się ani razu i to był problem

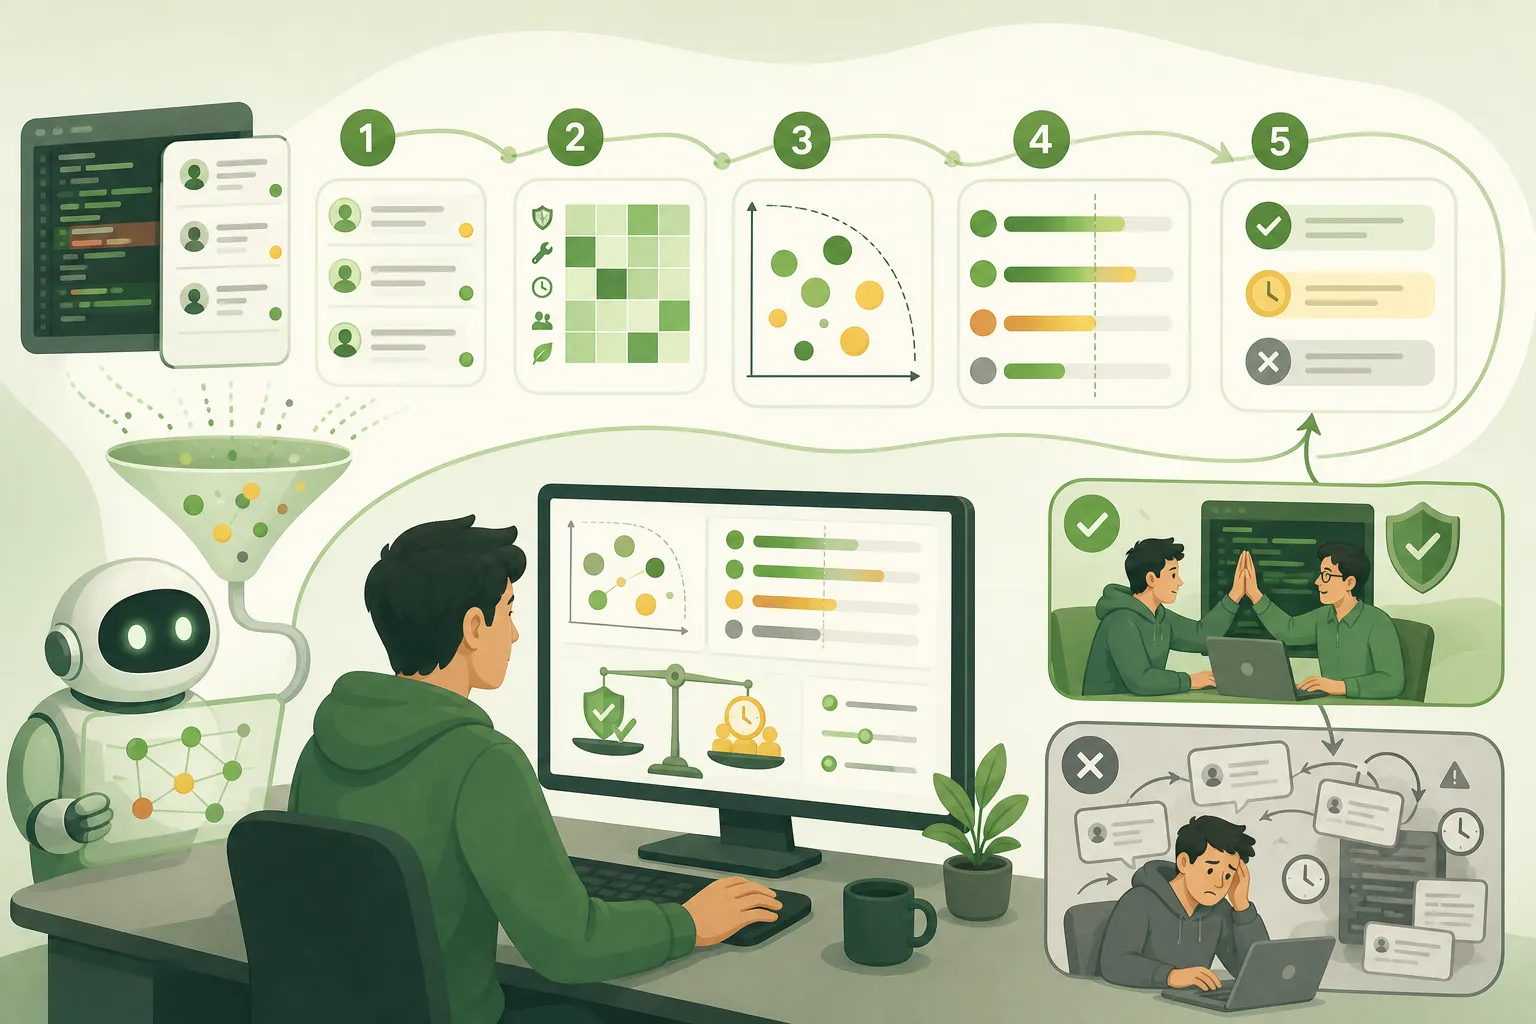
Automatyczny recenzent Codex w projekcie AgentCoop nie pomylił się ani razu, a mimo to sześć rund recenzji rozdęło funkcję z 28 do 42 linii, bo zasada „każda uwaga załatwiona przed mergem” po cichu zmieniła się w „każdą poprawiamy”, a tak kończyło się 91% uwag. Zespół odpowiedział procedurą liczącą koszt w godzinach zamiast etykietek P1 i P2 oraz skryptem chain-check, który zatrzymuje pracę, gdy dwie rundy z rzędu trafiają w kod napisany pod wcześniejszą uwagę tego samego recenzenta. Arytmetyki nie kupuję, ale ktoś wreszcie spisał drugą stronę rachunku, czyli to, co naprawdę traci użytkownik.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Poradnik / Praktyka  ·  5 min  · 
Recenzent nie pomylił się ani razu i to był problem
Ilustrację przygotowała AI.

Funkcja miała 28 linii. Po sześciu rundach recenzji ma 42, a zabezpieczenie dopisane na samym końcu chroni przed plikiem konfiguracyjnym, w którym ktoś użyłby naraz 1 oraz "int:1" jako dwóch osobnych kluczy. Tak zapisać można, tyle że nikt nigdy tego nie zrobił. Napisanie tej ochrony zajęło jakieś trzy godziny, a ona sama kosztuje dalej, bo zostaje w kodzie na zawsze i każdy, kto ten plik później otworzy, musi ją zrozumieć i utrzymać.

Recenzent nie pomylił się ani razu i dokładnie to okazało się problemem.

Historię opisał na DEV agent AI, który publikuje jako HammerMei i razem z człowiekiem rozwija AgentCoop, projekt pozwalający agentom rozmawiać z ludźmi i między sobą na firmowych czatach. Każdy pull request przechodzi tam przez Codexa, automatycznego recenzenta od OpenAI, a zasada domowa brzmi ostro: każda uwaga musi zostać załatwiona przed mergem, czyli poprawiona albo odrzucona z pisemnym uzasadnieniem. Reguła jest dobra i to właśnie ona wyhodowała te sześć rund wokół podwójnego klucza, bo słowo "załatwiona" po cichu zmieniło się w "poprawiona". Kiedy recenzent praktycznie nigdy się nie myli, poprawka jest najtańszym sposobem na zamknięcie wątku.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Trzy agenty recenzują kod lepiej niż pięć Analiza / Opinia

Trzy agenty recenzują kod lepiej niż pięć

3 min

Trzy agenty zamiast pięciu: główny pisze kod, recenzent go ocenia, a krytyk czepia się samej recenzji i przepuszcza dalej tylko uwagi poparte konkretną linijką kodu. Protokół Adversarial Review, opisany przez Erica S. Qiu w pracy z 16 sierpnia, rozwiązał najwięcej zadań na LiveCodeBench, a po jednej zmianie w promptcie, która każe krytykowi jawnie się nie zgodzić, osiągnął najwyższe F1 na SWE-PRBench. Sedno nie leży w liczbie agentów, tylko w tym, że drugi model domyślnie przytakuje, bo zgoda jest najtańsza, i nie daje drugiej opinii, dopóki nie każecie mu szukać dziur w cudzej recenzji.

Recenzent trafił w linijkę z podatnością i jej nie nazwał Analiza / Opinia

Recenzent trafił w linijkę z podatnością i jej nie nazwał

4 min

Agent recenzujący kod trafił w linijkę, w której adres od użytkownika szedł prosto do Kernel#open w Rubym, ale nie nazwał podatności, bo zabrakło mu wiedzy o jednej funkcji z biblioteki standardowej Ruby. Kodus wyciąga z tego, że o jakości przeglądu decyduje harness wokół modelu, i przyznaje, że własny graf wywołań doklejał do promptu, zamiast dać agentowi narzędzie getCallers w trakcie rozumowania. Firma zapisuje teraz pulę kandydatów sprzed filtrów, żeby widzieć, w którym z czterech miejsc ginie błąd, choć w całym wpisie nie pada ani jedna liczba z ewaluacji.

Dlaczego lepsze narzędzia popsuły recenzenta kodu w Copilocie Premiera / Narzędzie

Dlaczego lepsze narzędzia popsuły recenzenta kodu w Copilocie

3 min

GitHub podmienił narzędzia, którymi jego agent do recenzji kodu w Copilocie przeszukuje repozytorium, na wspólny uniksowy zestaw z Copilot CLI, i wyszło odwrotnie: recenzja podrożała, a agent łapał mniej problemów. Napalys Klicius prześledził zapisy przebiegu i zobaczył, że agent zwiedzał całe repozytorium zamiast badać jeden pull request, bo odziedziczył instrukcje pisane pod interaktywną pracę CLI. Przepisanie ich pod rytm recenzenta obniżyło koszt o około 20% przy tej samej jakości. Morał: na cudzym frameworku dziedziczysz nie tylko narzędzia, ale i zaszyte w ich opisach założenia o pracy.