Premiera / Narzędzie
25% na testach w C++: nowy benchmark pokazuje, gdzie agenty się sypią
OmniCode, benchmark zespołu Atharvy Sonwane'a i Saikata Dutty przedstawiony na ACL 2026, sprawdza agenty programistyczne na 1794 zadaniach w Pythonie, Javie i C++, w czterech kategoriach: łatanie błędów, pisanie testów, poprawki z recenzji i porządkowanie stylu. Popularny SWE-Agent z modelem DeepSeek-V3.1 radzi sobie nieźle głównie z błędami w Pythonie, a na pisaniu testów w C++ wyciąga najwyżej 25%, i to w najlepszym przebiegu. Agenty są mocne tam, gdzie trenowano je najintensywniej, więc jeśli piszesz w Javie czy C++ albo oddajesz im testy, sprawdź je na własnym kodzie.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 3 min ·
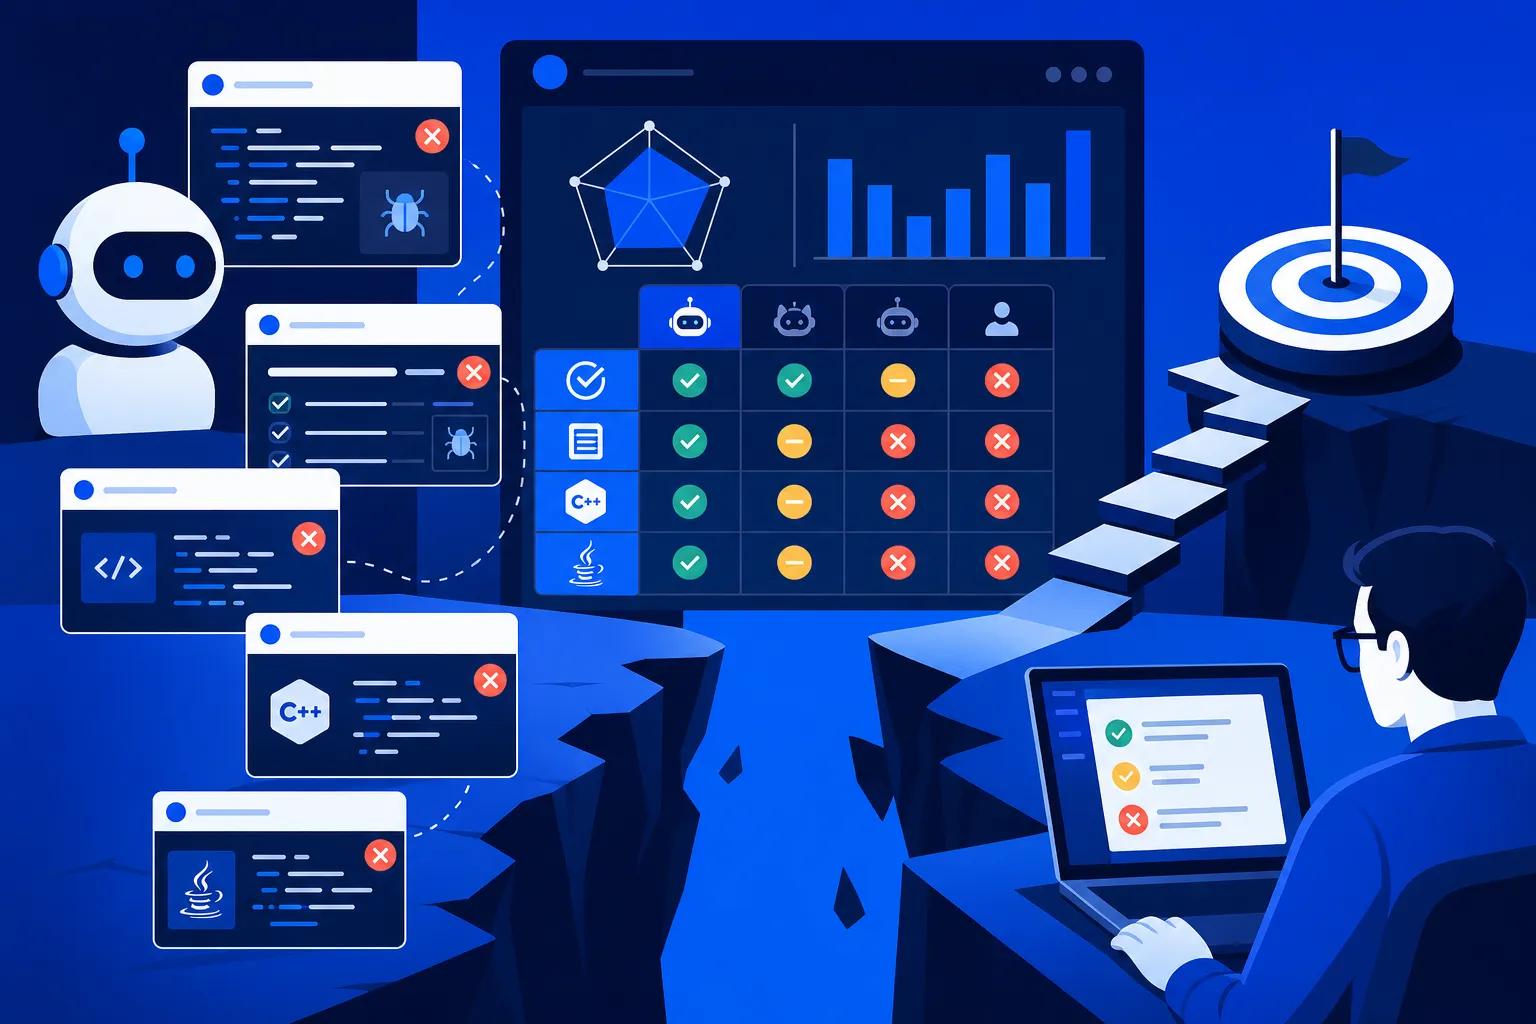
Najgłośniejsze benchmarki dla agentów programistycznych mierzą jedną wąską rzecz. SWE-Bench każe agentowi załatać prawdziwego buga z GitHuba, HumanEval każe rozwiązać drobne zadanie w stylu konkursowym. Obydwa sprowadzają się do wygenerowania kodu albo poprawki. Tyle że codzienna robota programisty to znacznie więcej niż samo pisanie kodu, i nie tylko w Pythonie. OmniCode, praca zespołu Atharva Sonwane'a i Saikata Dutty przedstawiona na konferencji ACL 2026 w lipcu, sprawdza agenty właśnie na tej szerszej robocie. Wynik jest otrzeźwiający.
Cztery rodzaje pracy, trzy języki, 1794 zadania
OmniCode zbiera 1794 zadania w trzech językach, w Pythonie, Javie i C++, podzielone na cztery kategorie. Poza łataniem błędów, które testują wszyscy, doszły trzy rzeczy, których wcześniejsze benchmarki nie ruszały: pisanie testów do istniejącego kodu, nanoszenie poprawek zgłoszonych w recenzji i porządkowanie kodu pod kątem konwencji stylu. To bliższe temu, co programista faktycznie robi w ciągu dnia, niż rozwiązywanie izolowanej zagadki.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.